풀스택 아키텍트(Full-Stack Architect)
실무 시스템의 본질은 화면이 아니라, 이 거대한 소프트웨어 생태계에서는 오직 데이터로만 대화합니다.
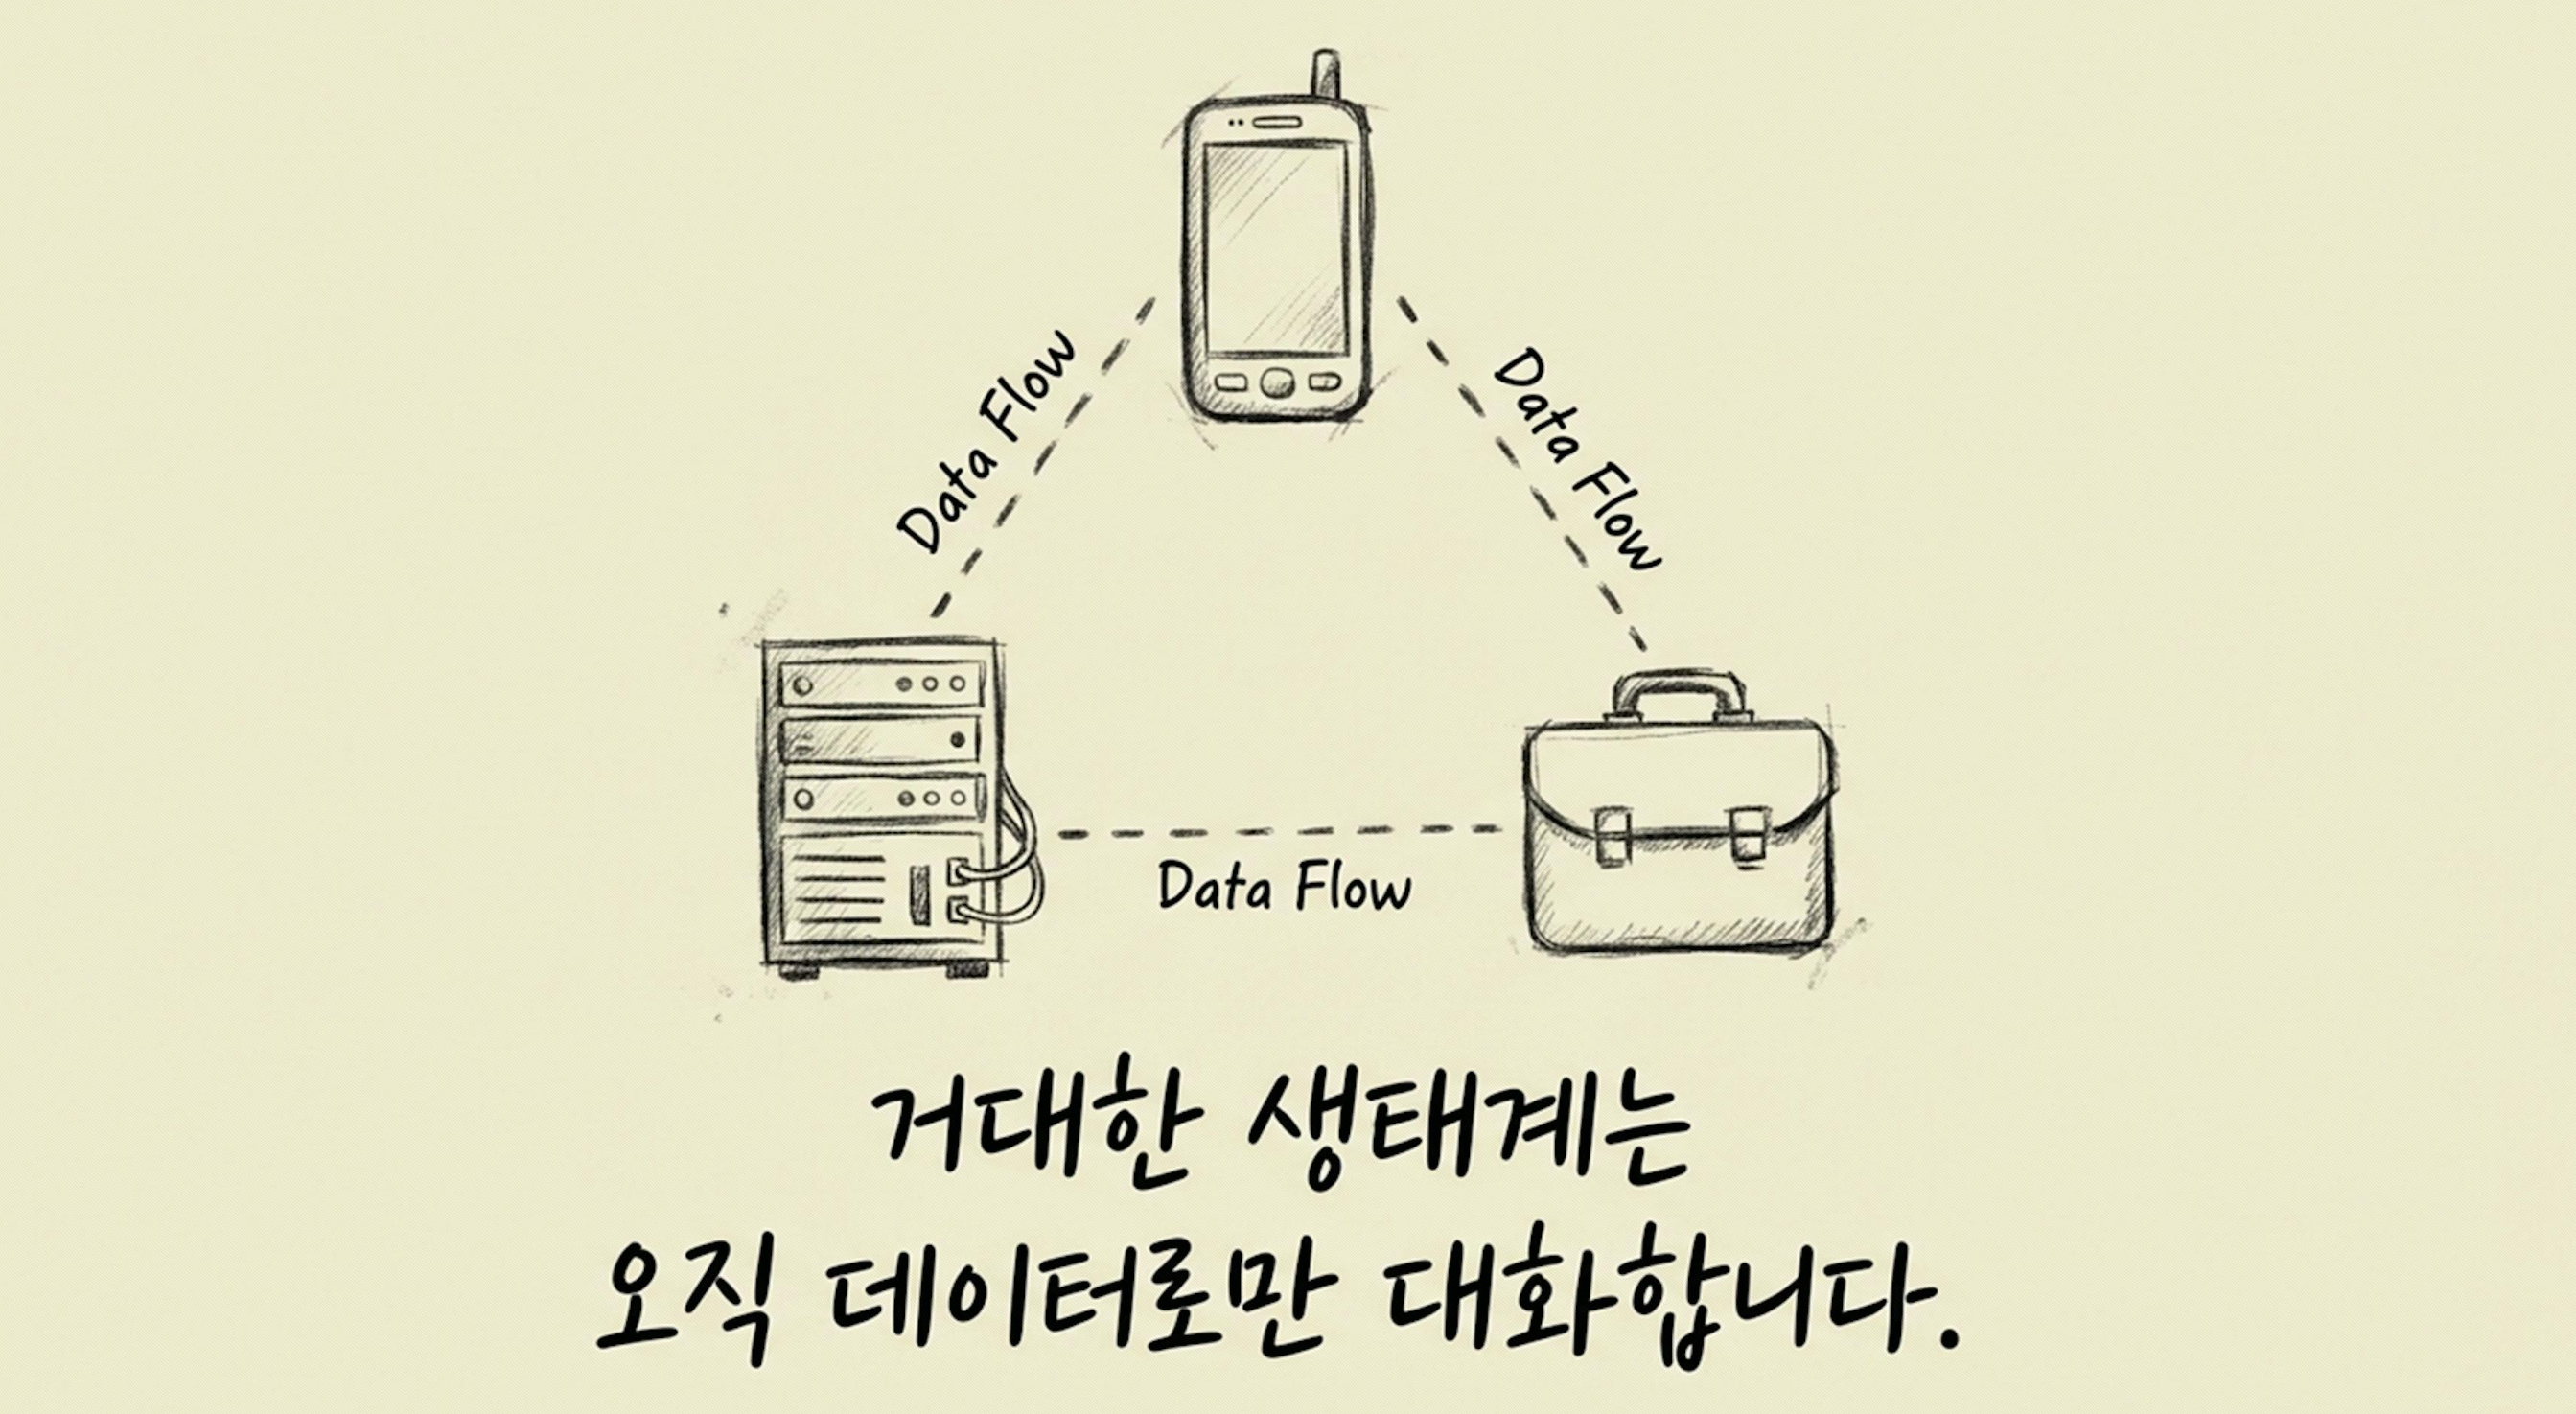
시스템과 시스템이 만나는 차가운 경계선을 API(Application Programming Interface) 라고 합니다.
대충 말하면, 서버는 응답하지 않듯이 정확한 표준 양식으로 요청을 보내야 응답합니다.
전세계의 개발자들이 합의한 절대적인 데이터 교안의 행정 규격이 바로 REST 입니다.
이 절차를 따르는 API를 RESTful API라고도 합니다.
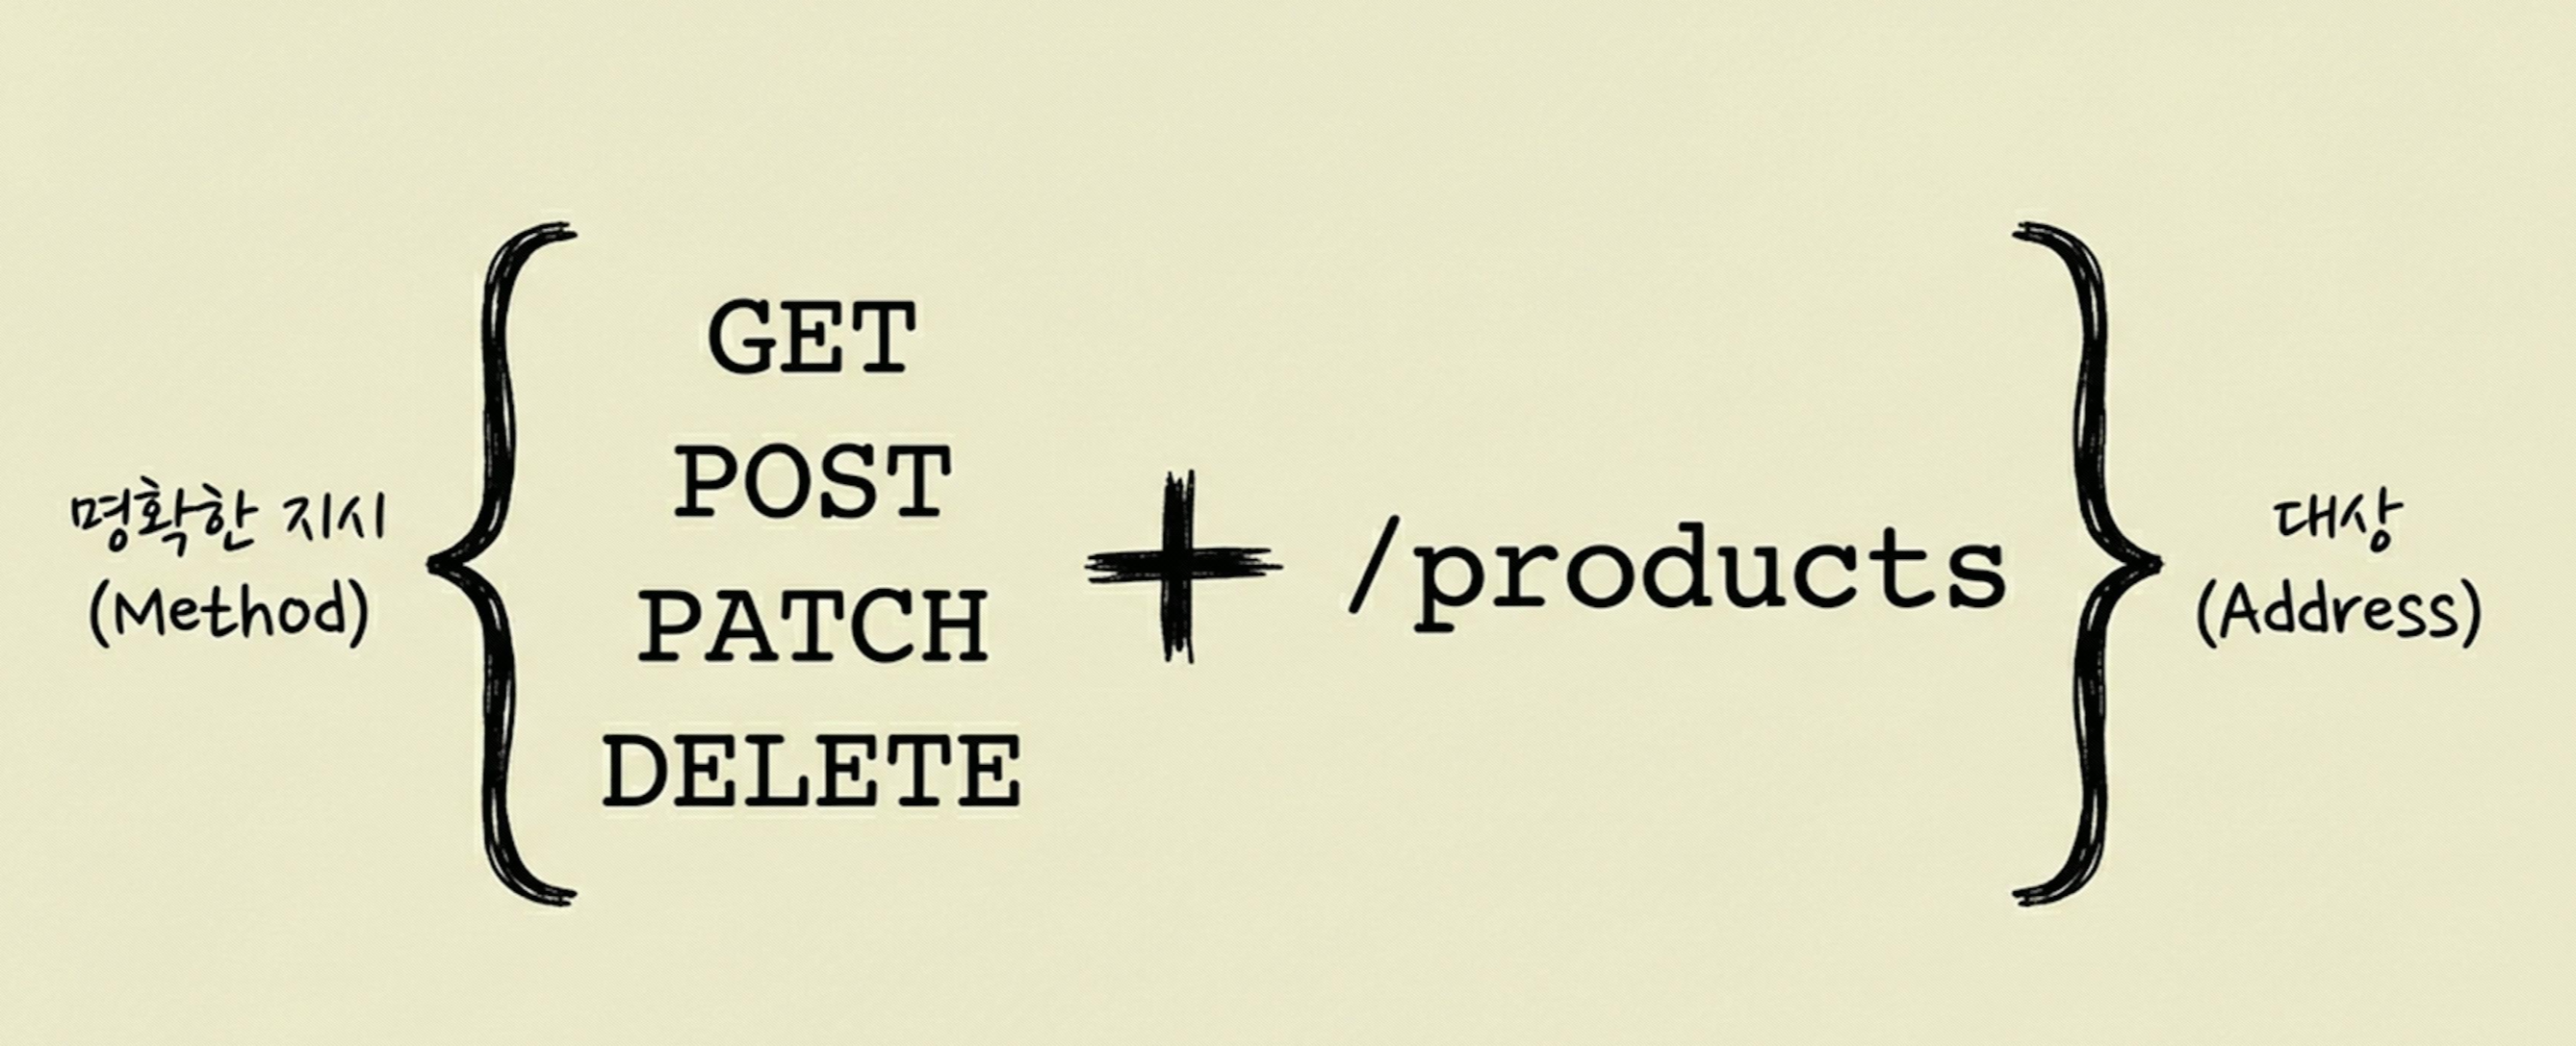
REST의 규격은 문서의 이름인 명사(자원)과 처리 방식인 동사(행위)로 완성되는데,
첫번째 명사는 인터넷에 적는 주소창 URL입니다. 우리가 제어하고자 하는 자원 그 자체를 가리킵니다.
두번째 동사는 자원을 어떻게 처리할 것인지(GET, POST, PATCH, DELETE) 정의합니다.
이 2개의 개념을 합쳐, 완벽한 문장 구조가 탄생하는 것입니다.
주소를 명사로 통일하고, 행위 및 목적은 메소드에 위임하는 것입니다.
서버는 그렇다면 위의 요청을 받고 어떤 데이터를 응답할까요?
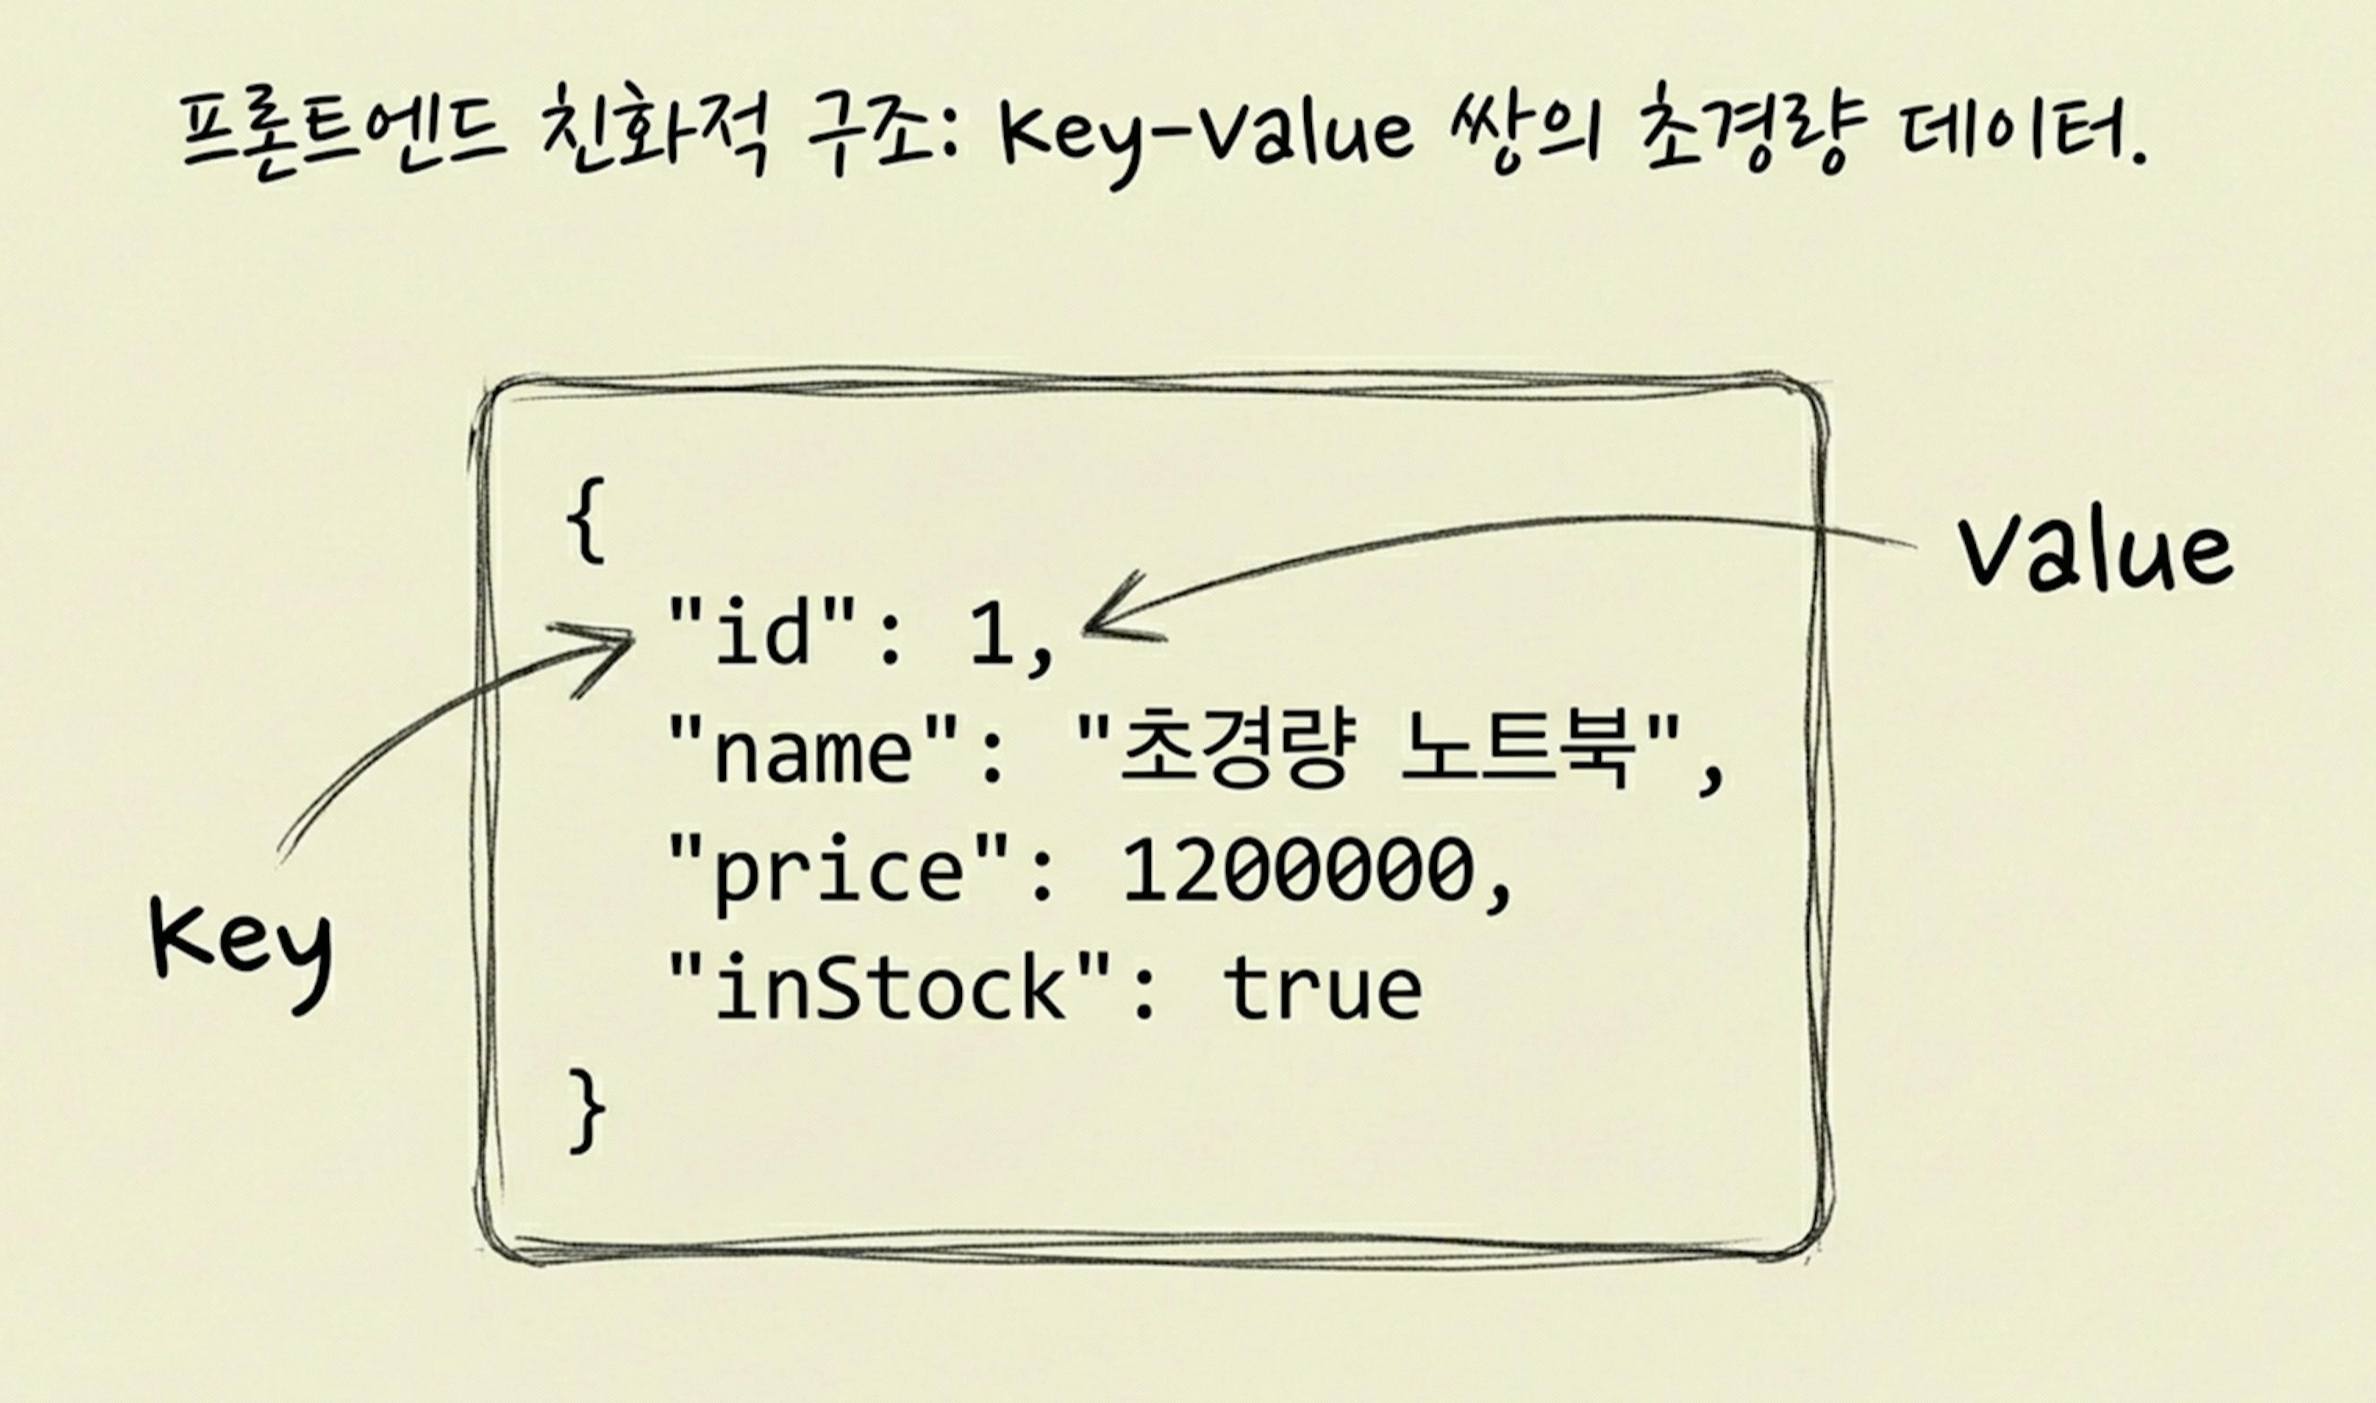
HTML처럼 시각적 요소가 아니라, JSON 처럼 시각적 요소를 뺀 순수한 텍스트를 내뱉습니다. (전세계 표준 서류 포맷)
JSON은 키-값으로 이루어진 단순한 텍스트입니다. 이는 네트워크 전송을 극한으로 낮춘 완벽한 포맷입니다.
여기서 Next.js는 단순히 화면만 그리는 도구가 아니라는 것을 확신하게 됩니다.
화면 없이 순수한 JSON 데이터만을 발행하는 완벽한 API 서버인 Route Handlers를 제공합니다.
Route Handlers - 커스텀 API 서버
HTML 파일이 아닌 JSON 파일을 반환해주는 요구사항이 생길 경우, UI 랜더링에 묶여있는 page.tsx 로는 불가능합니다.
과거에는 이를 위해 별도의 API 서버 인프라(Infra)를 구축해야 했습니다.
그러나 이제는 Next.js의 강력한 코어 엔진인 Route Handlers를 통해 프레임워크 내부에서 완벽한 API 서버를 구축합니다.
이제 이것을 가동하기 위해 프레임워크가 제공하는 3가지 규칙에 대해 알아봅시다.
첫째, 파일명은 반드시 route.ts를 사용해야 합니다.
둘째, 함수명은 반드시 HTTP Method 이름으로 정해야 합니다.
셋째, 동일 경로에 page.tsx와 route.ts는 공존 불가합니다.
따라서 파일 생성 경로는 아래와 같이 정합니다.
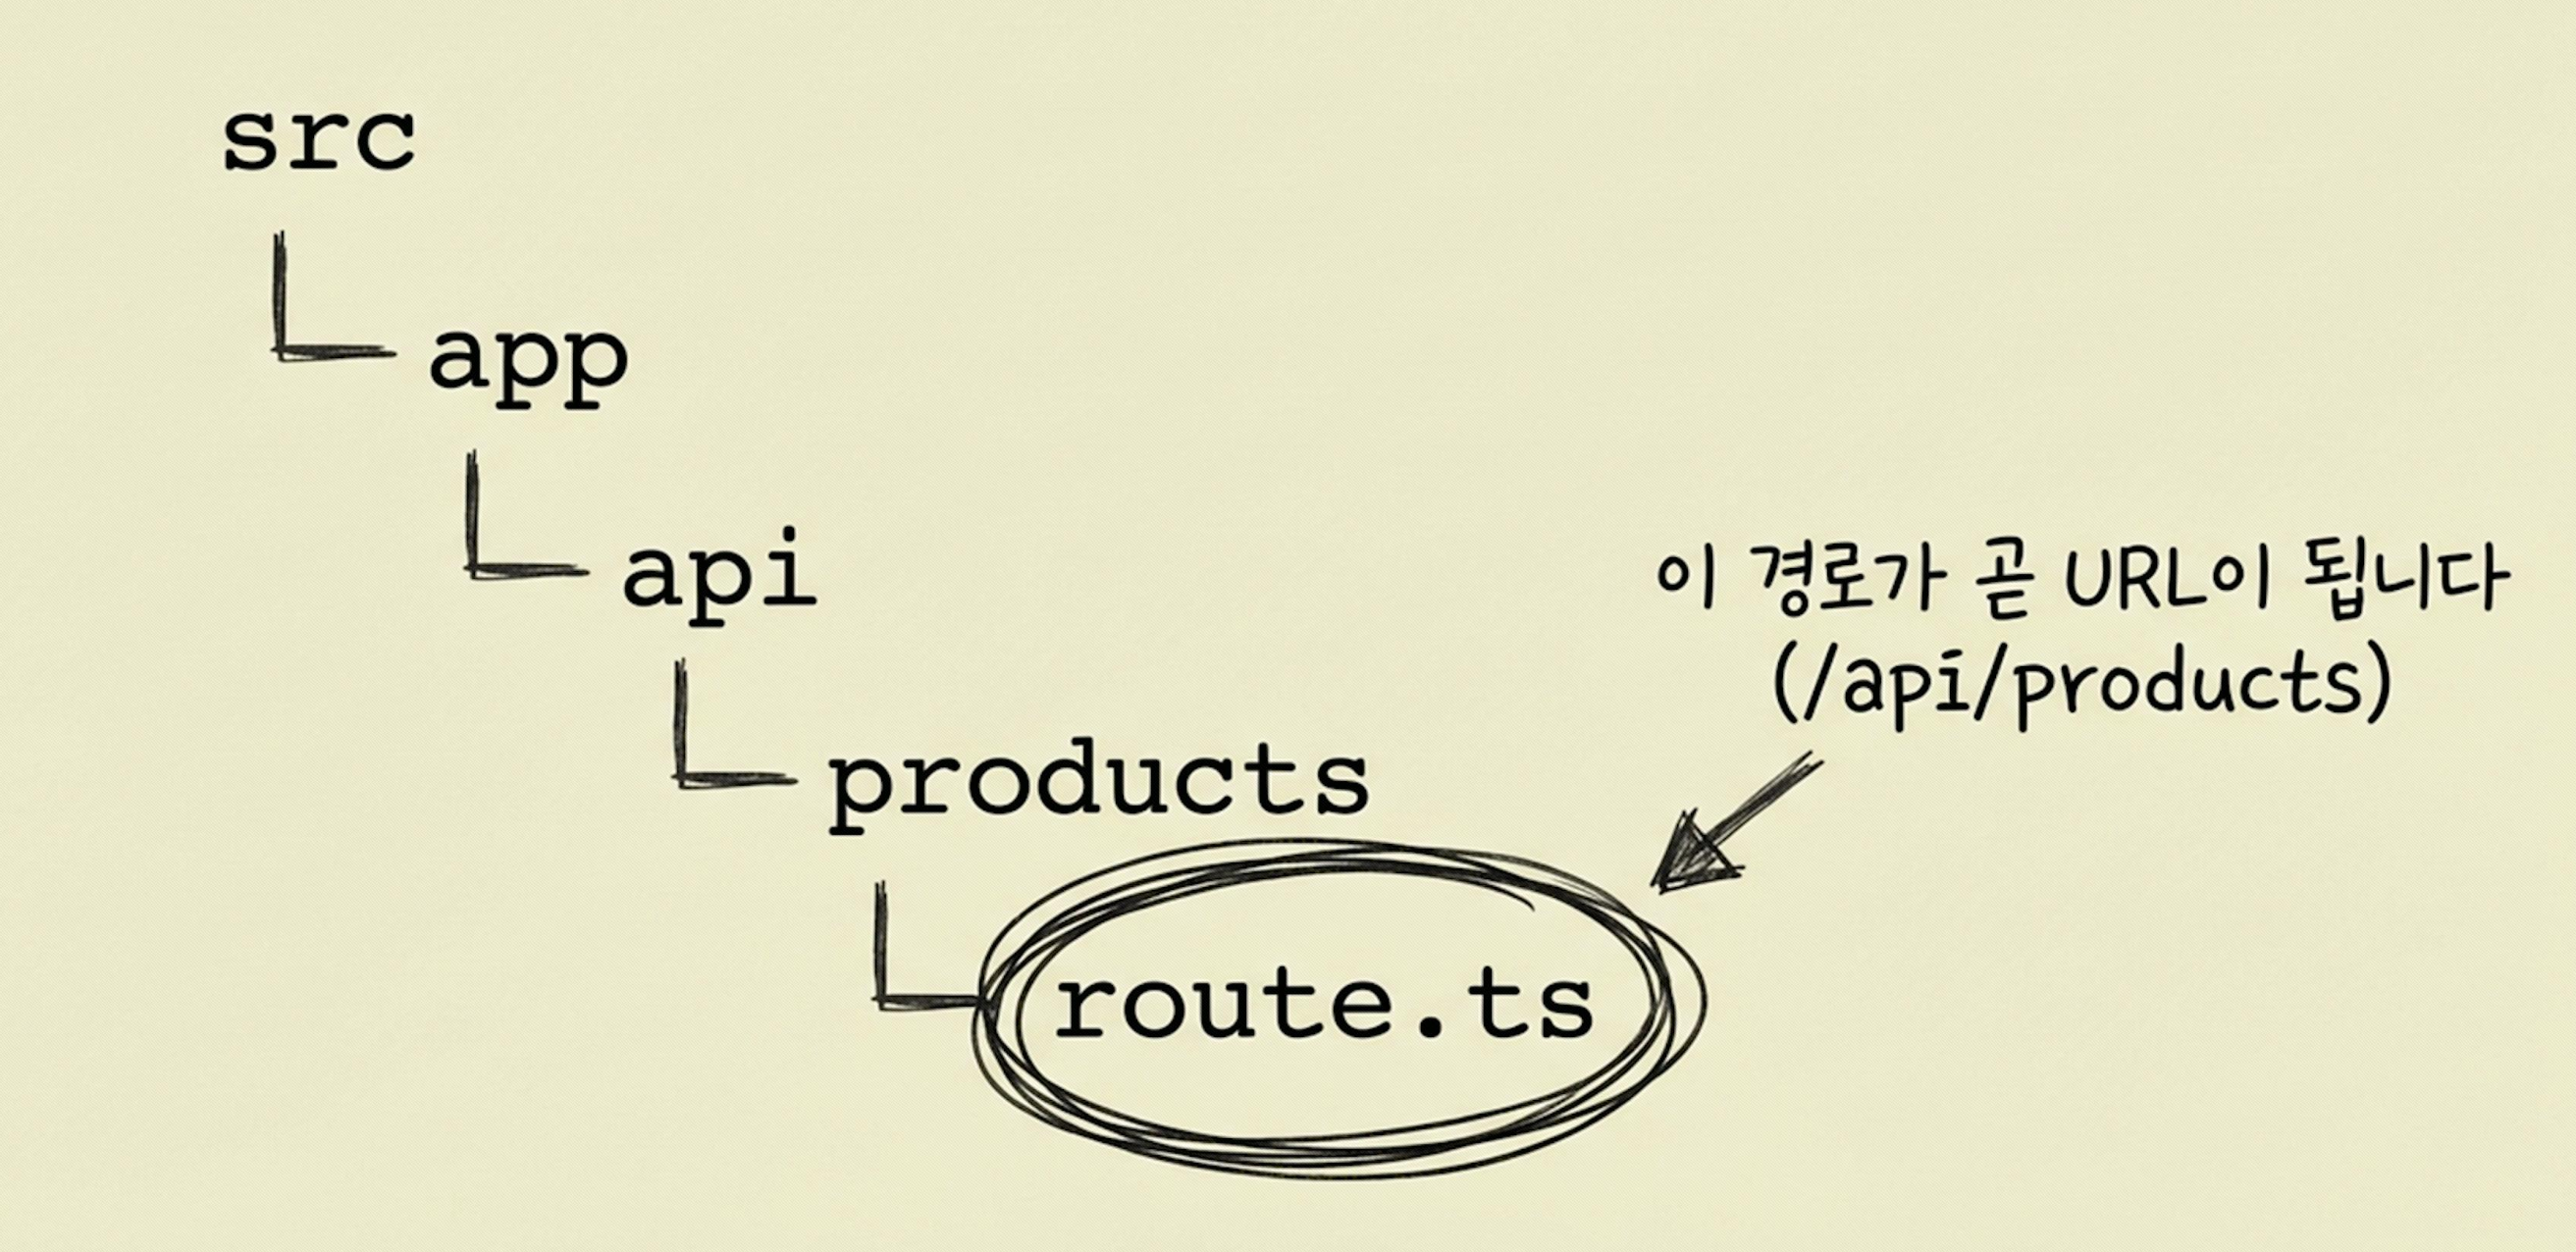
그리고, route.ts의 코드를 살펴봅시다.
첫번째로, interface를 사용하여 응답할 데이터의 형식을 규격화합니다.
interface Product {
  id: number;
  name: string;
  price: number;
}
두번째로, 현재는 DB(데이터베이스)가 없으므로, 임시로 인메모리 가짜 데이터를 준비합니다.
const products: Product[] = [
  { id: 1, name: '초경량 노트북', price: 1200000 },
  { id: 2, name: '무소음 키보드;, price: 180000 }
]
세번째로, GET 메소드 핸들러를 선언해 API와 주소를 맵핑합니다.
export async function GET(request: Request) {
  return Response.json(products)
}
추가적으로, Next.js 15+ 부터 GET 요청은 기본적으로 캐싱되지 않아 항상 최신 데이터를 불러옵니다.
네번째로, 어떤 데이터를 생성하는 POST 메소드를 선언해보겠습니다.
export async function POST(request: Request) {
  try {
    const body: Partial<Product> = await request.json()

    if(!body.name || !body.price) {
      return Response.json({
        { error: '상품 명칭 또는 상품 가격이 누락되었습니다.' },
        { status: 400 }
      })
    }

    const newProduct: Product = {
      id: products.length + 1,
      name: body.name,
      price: body.price
    }

    products.push(newProducts)

    return Response.json(products, { status: 201 })
  } catch (error) {
    return Response.json(
      {
        error: '서버 내부에서 요청을 처리하지 못했습니다'
      },
      {
       status: 500
      }
    )
  }
}
이 안에서의 비즈니스 로직은 4단계로 나뉩니다.
첫번째 데이터 해독입니다. 클라이언트가 전송한 body 데이터를 자바스크립트 객체로 해독합니다.
두번째 1차 방어선 구축입니다. 필수 규격인 name, price가 누락되었다면, 즉시 에러메시지와 에러코드를 반환합니다.
세번째 새 데이터 레코드 생성 및 등록입니다. 새로운 상품 데이터를 만들고, 가상의 배열 데이터에 밀어넣습니다.
네번째 생성 등록이 성공한다면, 밀어넣은 배열 데이터를 반환하고, 성공 status도 반환합니다.
추가로, catch 블록을 통해 시스템 내부 오류에 대해 반려합니다.
이로써 GET과 POST method로 정의된 API를 구성했지만, 지금은 모든 데이터베이스를 값을 쏟아내는 형식입니다.
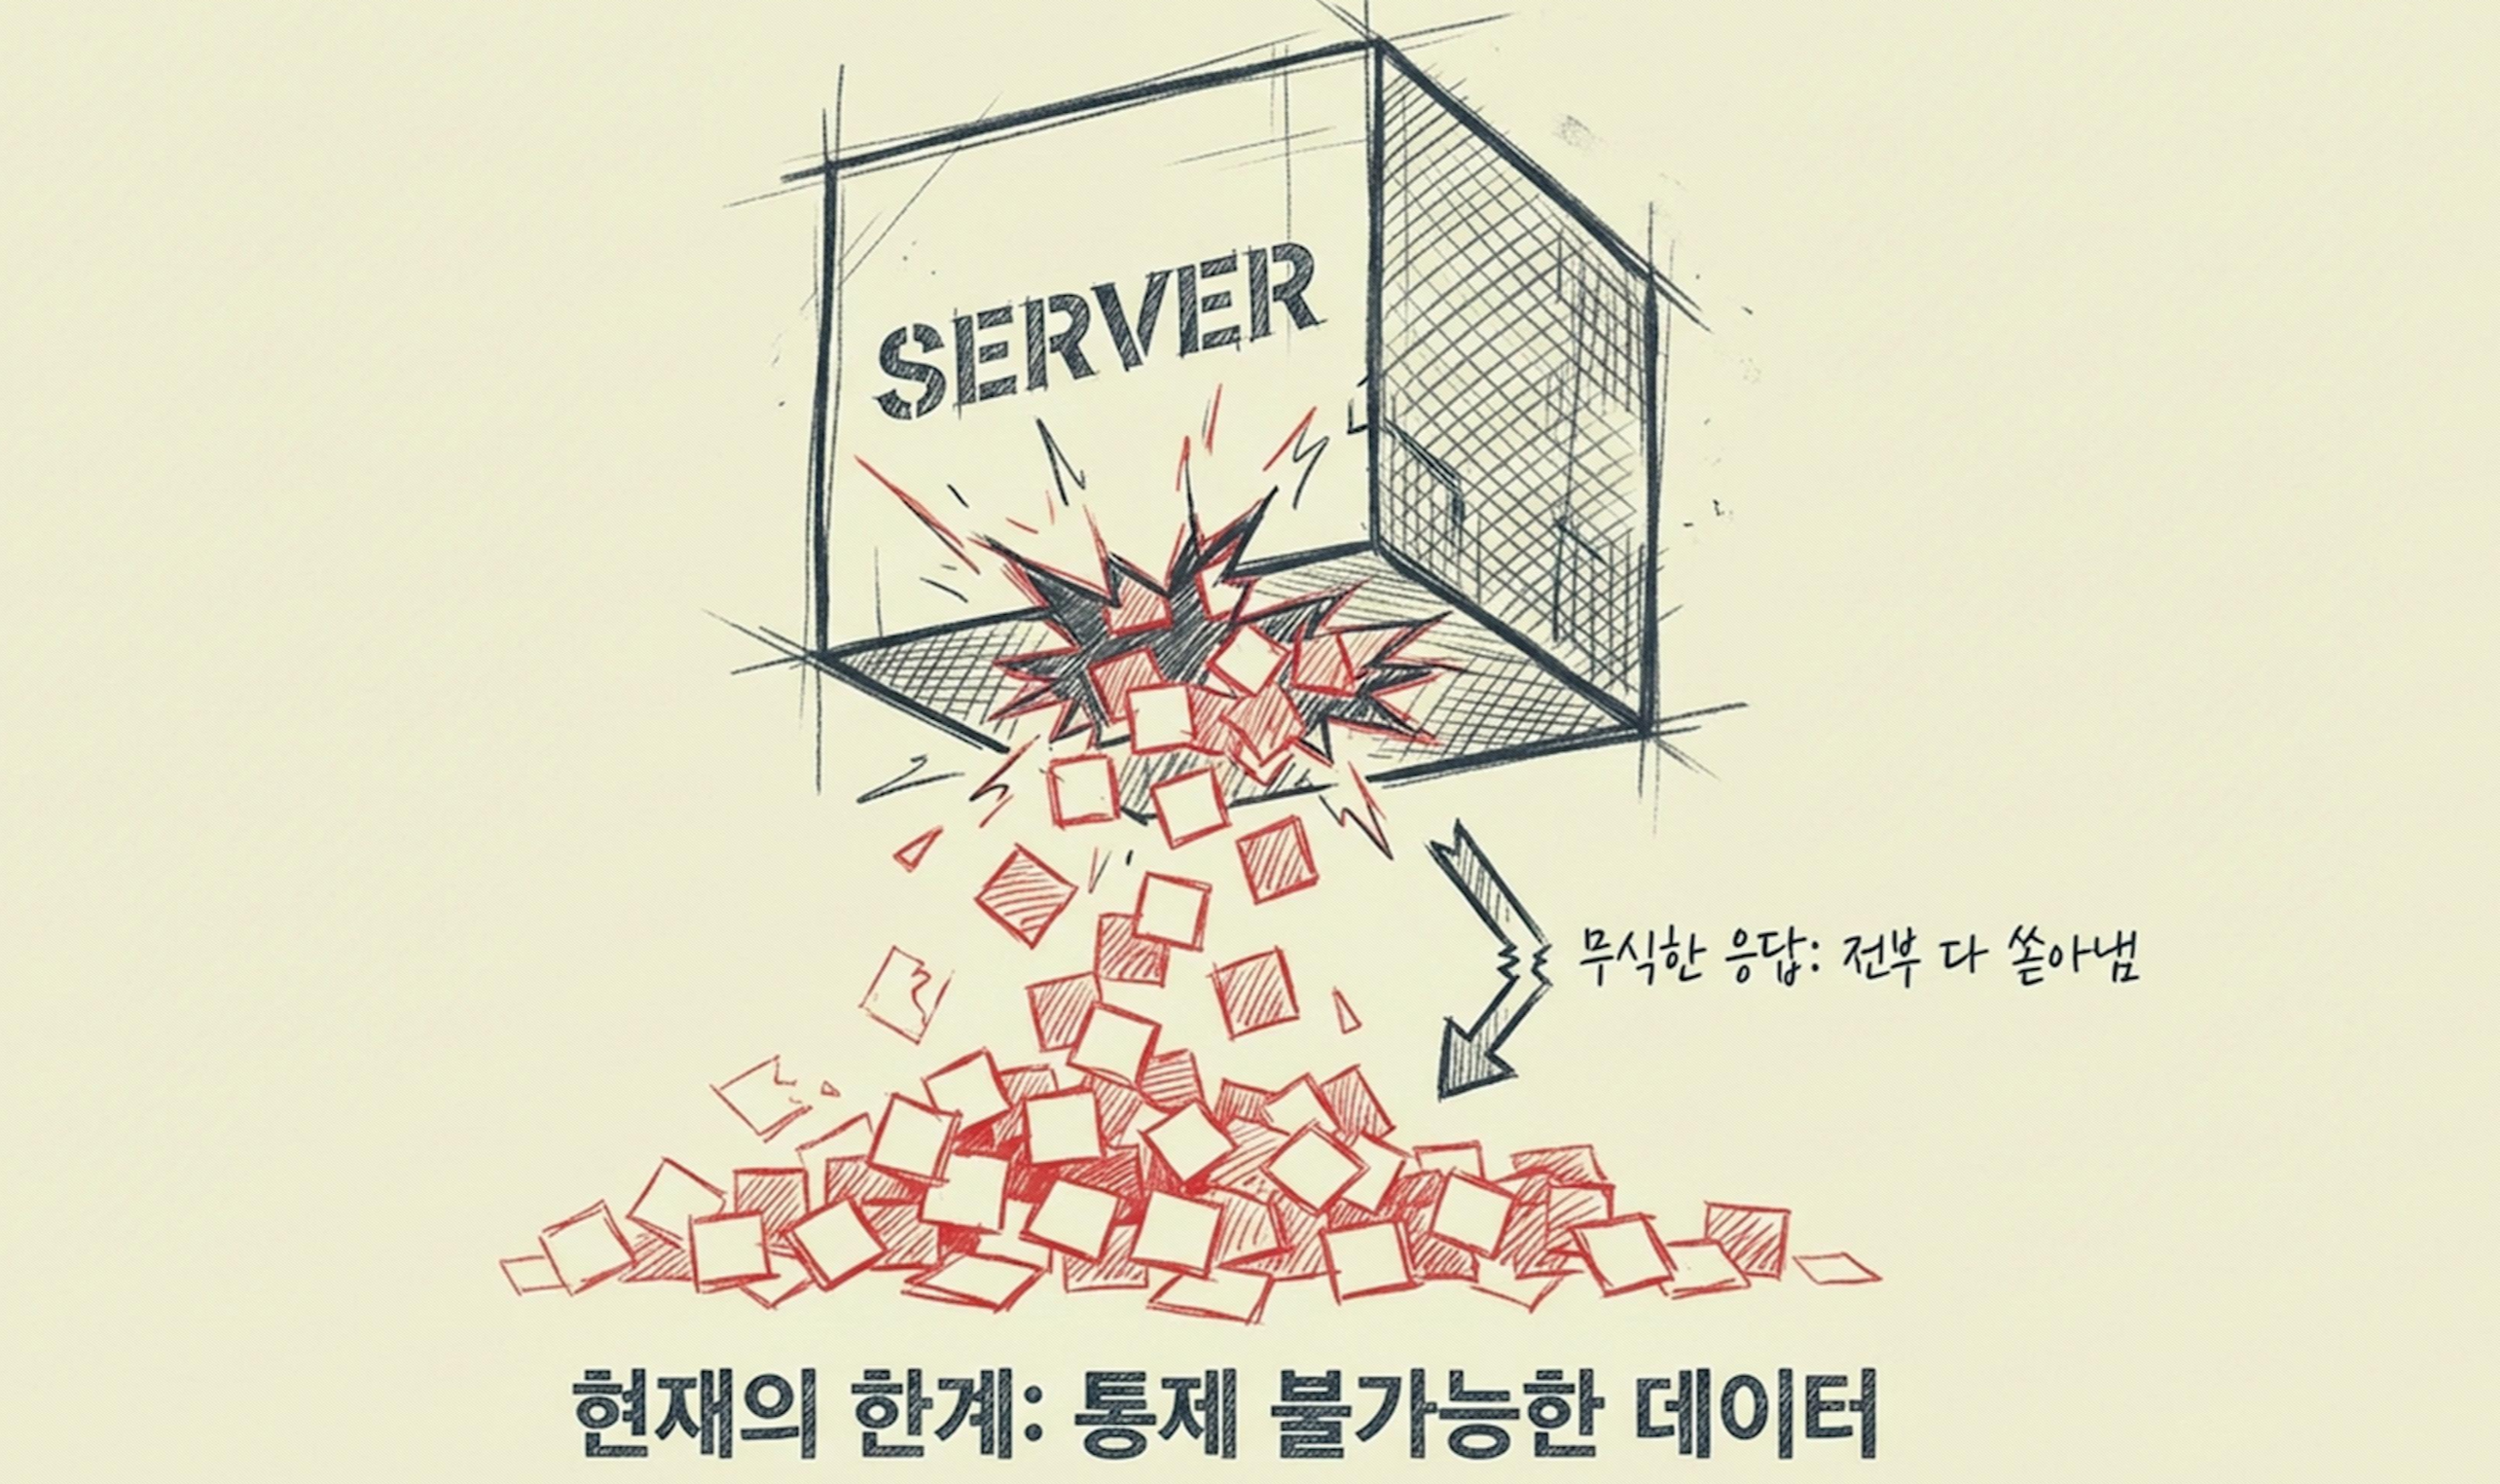
따라서 세부적인 지시사항을 전달하여, 클라이언트의 정밀한 요구를 서버에서 처리할 수 있습니다.
그리고, 웹 생태계에서 이 데이터는 인터넷 주소창이라는 수송관을 통해 서버로 저장되는데
그 인터넷 주소의 본질인 URL과 URI 개념도 이해해야 합니다.
URI는 인터넷 상의 자원을 식별하기 위한 전체 주소 즉, 통합 식별자를 뜻하는 가장 넓은 개념입니다.
URL은 URI의 하위 개념으로, 그 자원이 물리적으로 어디에 있는지 위치를 나타냅니다.
그렇다면, 어떻게 2가지 개념을 통합해 요청 데이터를 서버로 실어 나를 수 있을까요?
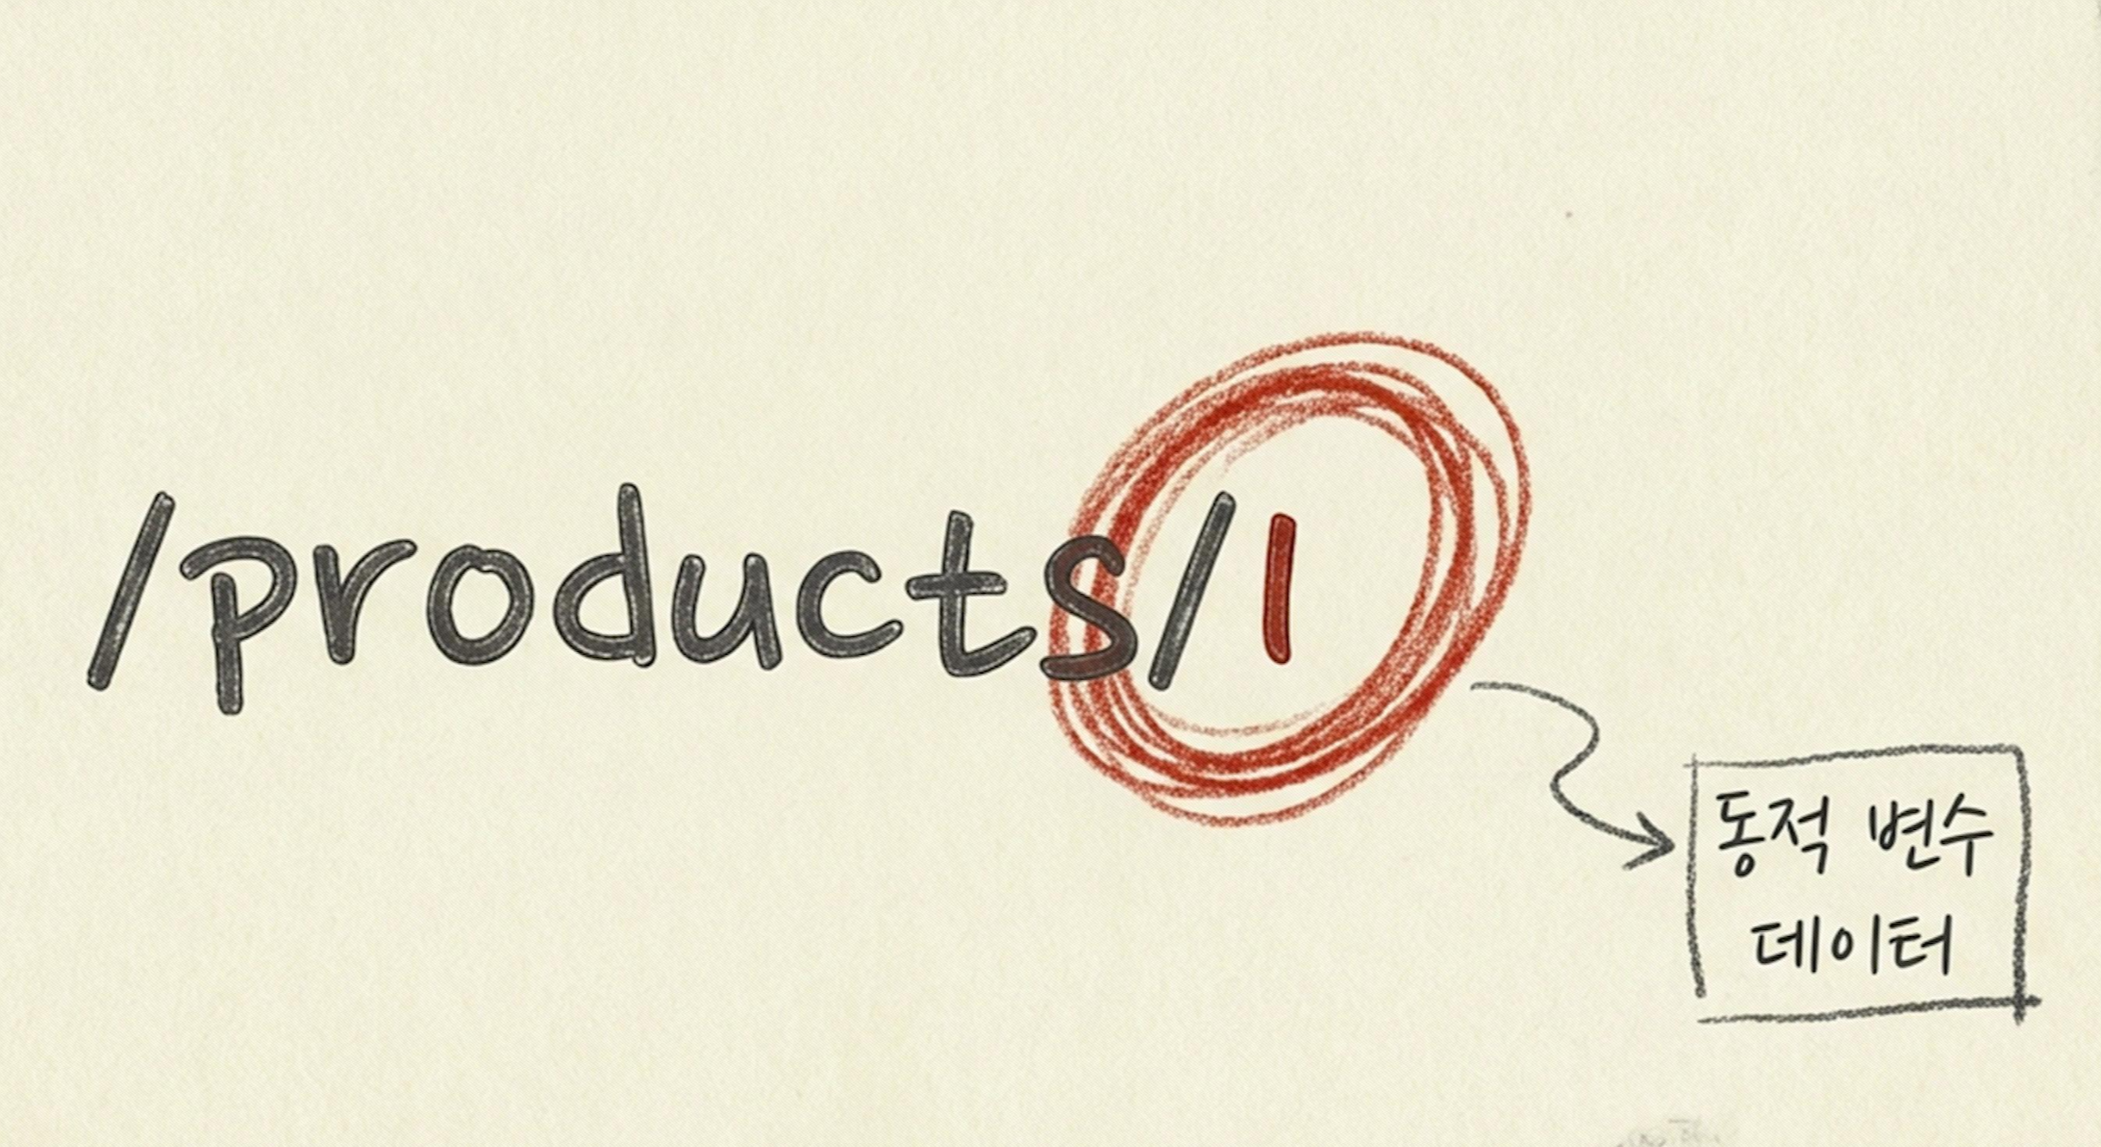
첫번째는 Path Variable 방식입니다. 이는 주소의 일부를 변수처럼 사용하여 대상을 지칭합니다.
Next.js에서는 폴더 이름에 [id] 형식으로 표현합니다.
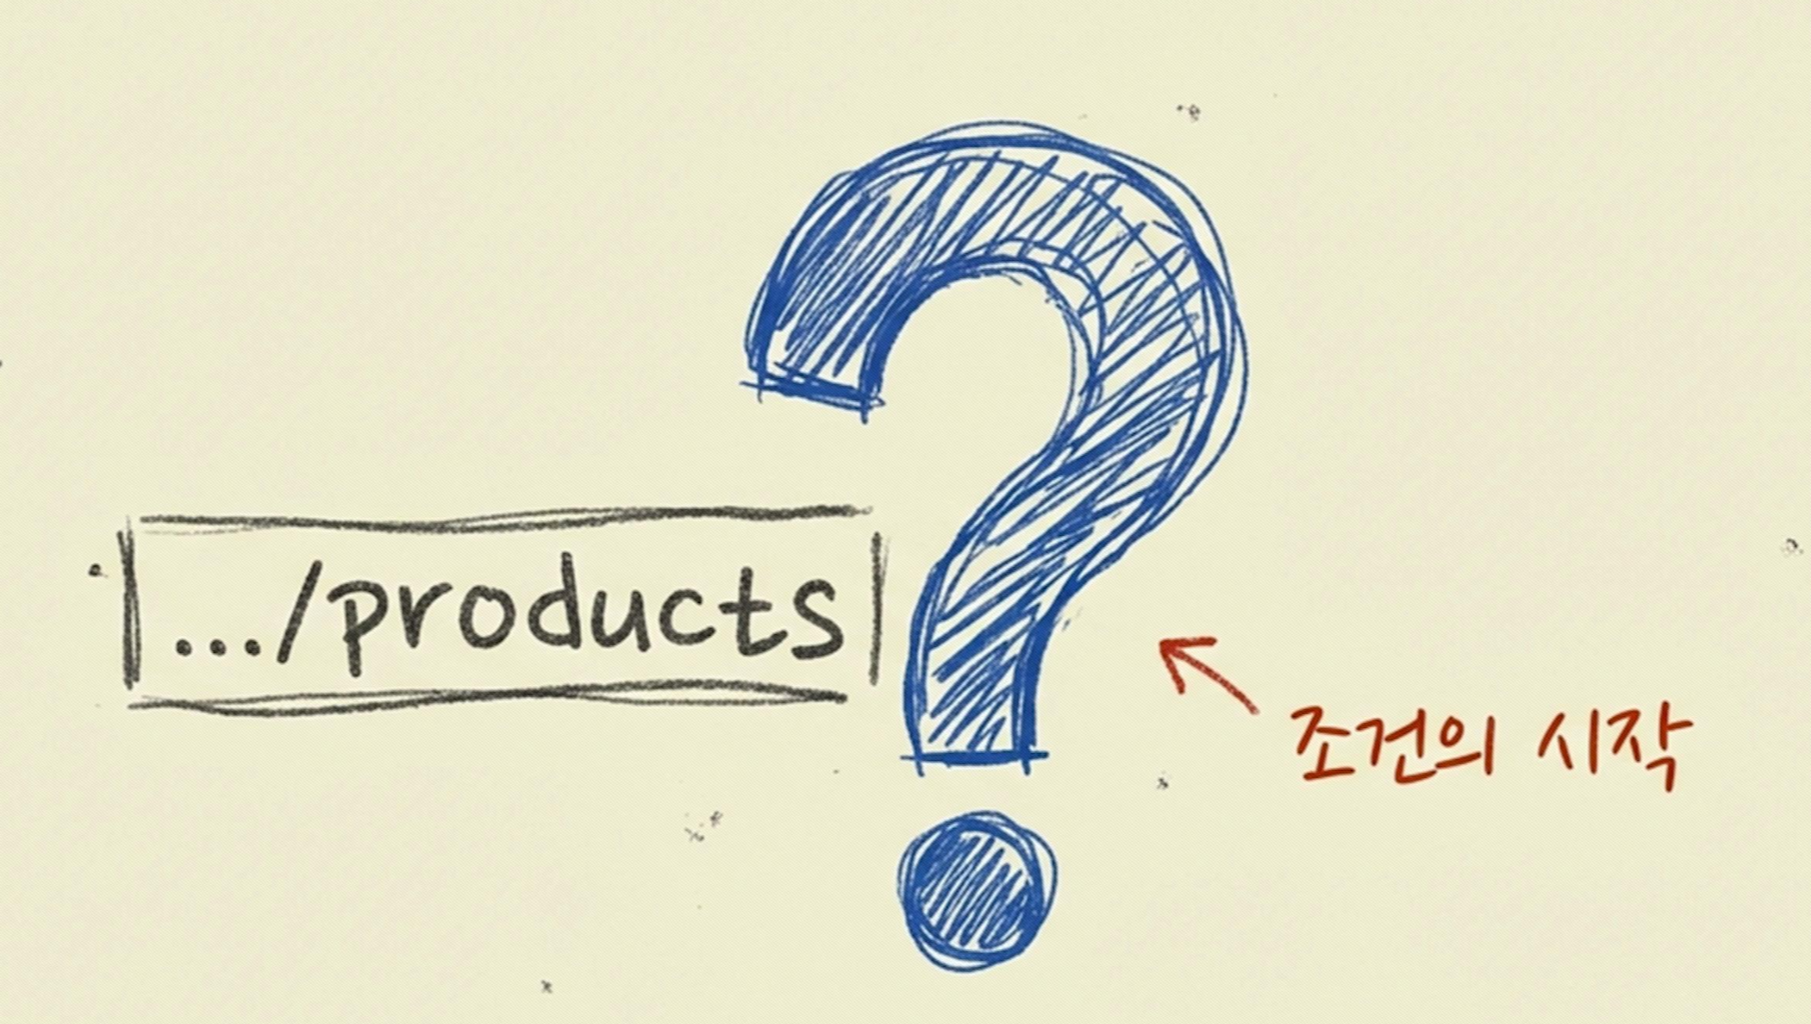
두번째는 Query String 입니다. 대상을 구체적으로 지목하는 것이 아니라, 조건으로 지목할 때 사용합니다.
키=값의 쌍을 이루어 조건을 표시하고, 여러개의 조건이 필요할 떄는 & 기호로 연결합니다.
즉, 대상을 어떻게 가공해서 보여줄지를 결정하는 항목입니다.
이렇게 URI 패턴에 따라, 서버에 도착한 데이터들은 어떻게 해석될까요?
이때 프레임워크의 내장 객체 NextRequest, NextResponse가 등장합니다.
import { NextRequest, NextResponse } from 'next/server'위와 같은 코드를 보면, 이 두 객체는 자바스크립트 기본 내장 객체가 아닙니다. 서버 환경을 위해 특별히 확장한 객체입니다.
위의 GET, POST 함수를 다음과 같이 수정할 것입니다.
export async function GET(request: NextRequest) { .... }

export async function POST(request: NextRequest) { .... }
여기서 함수로 들어오는 request 매개변수의 타입을 NextRequest로 엄격하게 강제합니다.
왜 이런 깐깐한 타입 지정이 필요할까요?
실무 환경에서는 NextRequest 확장 객체의 위력이 압도적이어서, 일반 request의 번거로운 파싱 과정을 해결합니다.
아래의 코드의 내부 로직을 살펴봅시다.
import { NextRequest } from 'next/server'

export async function GET(request: NextRequest) {
  const searchParams = request.nextUrl.searchParams
  const sortOptions = searchParams.get('sort')
}
이것은 request 파라미터에 Query String으로 받아왔을 때 그 Query 옵션에 접근하는 예시입니다.
NextRequest 객체가 보장하는 강력한 내장 메소드를 통해 URL 정보를 완벽히 분해된 정보로 꺼내씁니다.
이제 이 해독된 정보로 서버에서 비즈니스 로직을 완벽하게 수행하는 일 뿐입니다.
비즈니스 로직을 수행하고, NextResponse 객체를 통해 클라이언트에 표준 json 데이터를 응답합니다.
return NextResponse.json(data, {
    status: 201,
    headers: {
      "Content-Type" : "application/json",
      "X-System-Arch" : "MasterClass"
    }
})
단지 데이터만 던지고 끝내는 것이 아니라, 두번째 인자로 객체를 추가로 넘기는데
status 속성으로 http 상태 코드를 명시함으로써, 데이터 생성 성공을 시스템적으로 보장합니다.
headers 속성을 추가로 제어하여, 응답 헤더를 명시하거나 커스텀 헤더를 주입함으로, 백엔드 시스템의 통제력을 높입니다.
지금까지 배운 내용을 바탕으로, API 서버에 동적으로 요청을 보내고, 그 결과 데이터를 가져와
클라이언트 화면에 랜더링하는 완벽한 풀스택 파이프라인을 그려보겠습니다.
가장 먼저 무수히 많은 상품 중,특정 정보만을 정확히 타겟팅하는 동적 라우터 핸들러를 서버에 구축해야 합니다.
아래 폴더에 라우터 핸들러를 정의합시다.
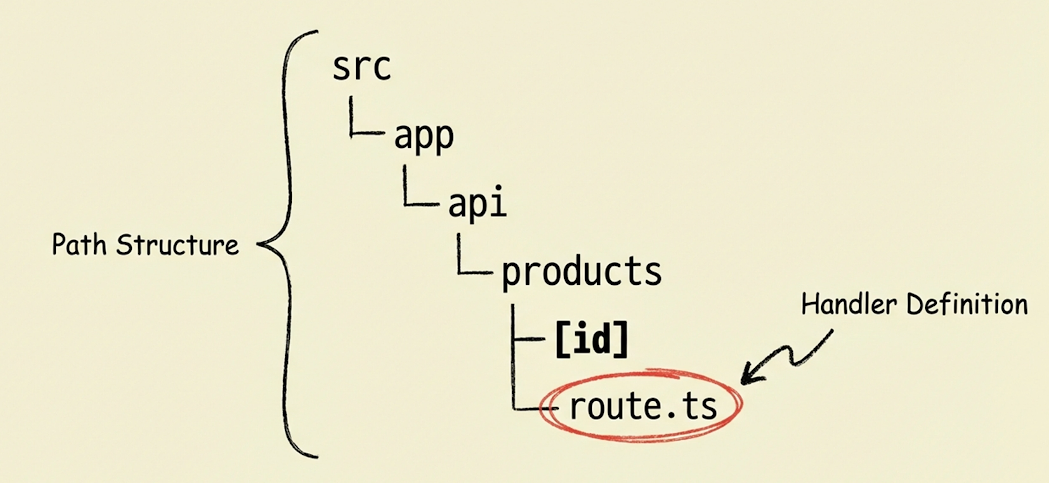
이제 route.ts 코드를 작성하겠습니다.
첫번째 로직은 ProductDetail이란 인터페이스를 통해 시스템 밖으로 나갈 데이터의 규격을 선언합니다.
interface ProductDetail {
  id: string
  name: string
  price: number
  description: string
}
두번째로는 GET 함수를 선언하는데 params를 받는데에 있어 Promise 객체로 받게 됩니다.
즉 동적 경로를 해석하는 일 자체가 비동기적으로 수행됩니다. 따라서 동적 경로인 id 값은 async - await 통해 받습니다.
export async function GET(
  request: Request,
  { params } : { params: Promise<{ id: string }> }
) {
  const { id } = await params
  // 이후 로직은 밑에서
}
다음 로직은 실제로는 데이터베이스 쿼리가 들어가야 할 자리이지만, 목 데이터로 대체하여 보여주겠습니다.
// 위에 로직은 위를 참고하세요.

const product: ProductDetail = {
	id,
    name: `${id}번 상품`,
    price: 50000,
    description: '시스템 통제 센터에서 발행한 안전한 데이터입니다'
}

return NextResponse.json(product)
이제 API 라우팅은 완료되었습니다. 마지막으로, 이 API를 받아서 프론트엔드 화면을 page.tsx에서 보여줍시다.
아래 폴더에 파일을 생성합니다.
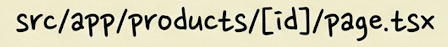
프론트엔드 화면에서 서버와 통신해야 하므로, 서버 컴포넌트로 구성했습니다.
export default async function ProductDetailPage(
 { params } :
 { params : Promise<{ id: string }> }
 ) { .... }
그리고, 첫번째로 API 서버에서 했던 것과 동일하게 params에 있는 id를 비동기적으로 추출합니다.
const { id } = await params두번째로 백엔드 서버와의 통신을 위해 fetch API를 사용해 API 엔드포인트를 트리거합니다.
여기서 fetch API의 두번째 인자로 cache: 'no-store'를 주목합시다.
이는 아키텍트가 프레임워크의 캐시 엔진에 내리는 강력한 통제 지시입니다.
캐시된 낡은 데이터가 아니라 100% 신선한 날 것의 데이터를 가져오라는 지시입니다.
const response = await fetch(`http://localhost:3000/api/products/${id}`, {
  cache: 'no-store'
})
세번째로, 서버에서 무사히 도착한 response 객체를 json 메소드로 해독합니다.
const product: Product = await response.json()마지막으로, 해독된 순수한 자바스크립트 객체를 HTML에 랜더링합니다.
return (
  <div style={{ padding: '20px', border: '1px solid #ccc' }}>
    <h1>상품 상세 제어소</h1>
    <hr />
    <p><strong>상품 식별자 : </strong> {product.name}</p>
    <p><strong>측정 가치 : </strong> {product.price.toLocaleString()}</p>
    <p><strong>시스템 로그 : </strong> {product.description}</p>
    <p><small>요청된 타겟 ID : {id}</small></p>
  </div>
)
이는 현대의 표준 풀스택 파이프라인으로 구성되어 있으나, 치명적인 단점이 있습니다.
수만명의 사용자가 동시에 접속해서 동일한 상품 페이지를 열어본다면 어떻게 될까요?
우리 서버는 수만번의 동일한 API 처리를 해야하고, 데이터베이스를 수만번 조회하며, 결국 서버는 과부하로 붕괴합니다.
이런 성능의 한계를 돌파하기 위한 마법이 밑에서 배울 메모이제이션 & 캐싱입니다.
메모이제이션 & HTTP 캐시 제어
메모이제이션이란, 동일한 계산을 반복해야 할 때, 이전에 계산해둔 결과값을 메모리에 임시로 저장해두었다가
나중에 똑같은 요청이 들어오면 계산을 생략하고 저장된 값을 즉시 반환하는 기술입니다.
이러한 React의 최적화 철학이 Next.js에 그대로 넘어온 것이 Request Memoization입니다.
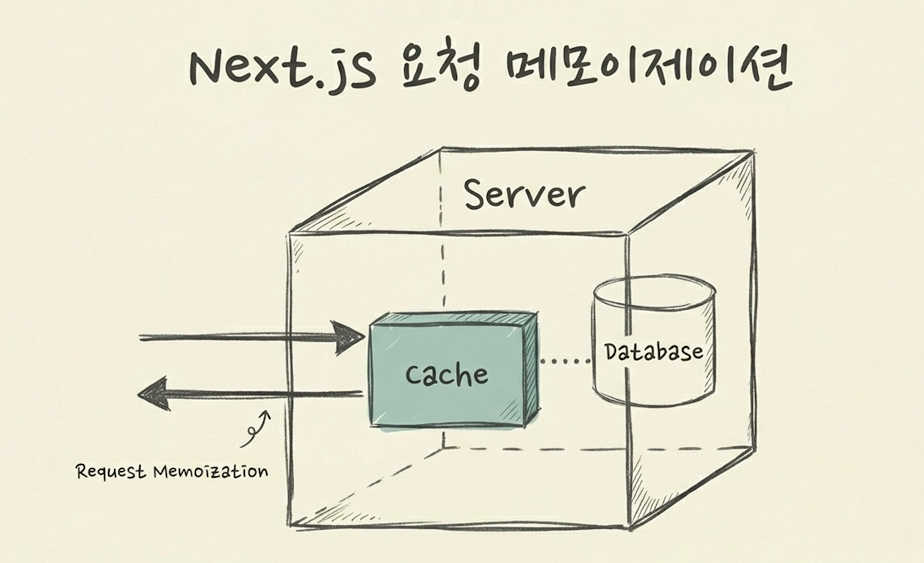
코드를 보며 논리적 흐름을 짚어봅시다. 먼저 메모이제이션할 캐시 저장소를 선언합니다.
const memoCache: Record<string, any> = {}그리고 함수를 만들어줍니다.
function expensiveCalculation(input: string) : string { ... }함수 내부 로직을 작성해봅시다.
첫번째로 캐시 히트(Cache Hit) 검증 단계입니다. 함수가 실행되자마자 시스템에 있는 캐시 메모리를 뒤져 있는지 확인합니다.
이 때는 모든 연산 과정을 건너뜁니다.
if(memoCache[input]) {
  console.log('캐시된 정답을 시스템 메모리에서 발견하여 즉시 반환합니다')
  return memoCache[input]
}
하지만 저장된 데이터가 없다면, 이 때 캐시 미스(Cache Miss) 처리 및 무거운 연산을 수행합니다.
console.log('데이터 베이스를 조회하여 새롭게 연산중입니다..')
const result = `결과값 {input} 처리 완료`
마지막 단계로, 힘들게 얻어낸 연산 결과를 그냥 버리지 않고, 메모리 객체에 기록해둡니다.
memoCache[input] = result

return result
하지만 이런 메모이제이션은 치명적인 한계가 있는데, 페이지 랜더링이 끝나고 나면 데이터는 폐기되어
다시 무거운 계산을 반복해야 할 것입니다. 즉, 다른 사용자가 들어오면 이 무거운 계산을 처음부터 해야한다는 뜻입니다.
그래서 우리는 더 강력하고 영구적인 글로벌 기억장치 HTTP 캐시를 제어해야만 합니다.
HTTP 캐시는 서버가 클라이언트나 CDN 프록시 서버에게 데이터를 넘겨줄 때 유통기한을 설정해
가지고 있는 복사본을 알아서 쓰라는 지침서를 붙여줍니다. 그 지침서를 선언하는 헤더는 다음과 같습니다.
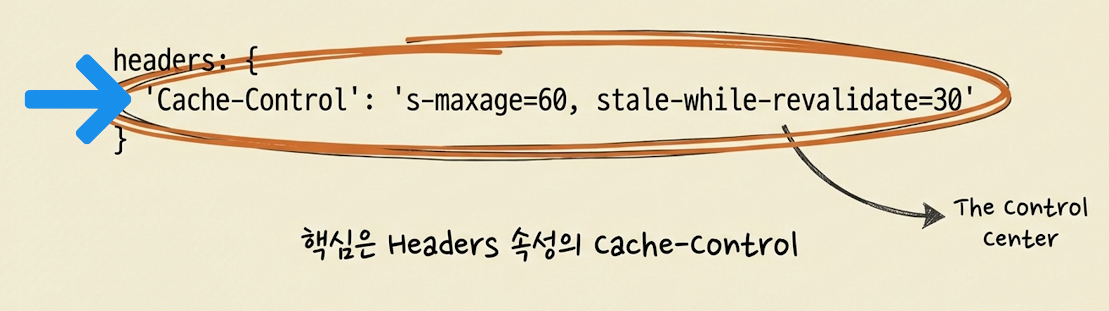
const data = { message: '이 데이터는 완벽하게 통제된 캐시 정책을 따릅니다.' }

return NextResponse.json(data, {
  headers: {
    'Cache-Control': 's-maxage=60, stale-while-revalidate=30'
  }
})
첫번째 s-maxage=60은 글로벌 CDN 서버 거점들에게 내리는 명령으로, 이 데이터를 60초 동안 보관하라는 의미입니다.
덕분에 어느 국가에서 접속하든 60초 안에는 우리 서버 본체까지 데이터베이스를 조회할 필요 없이
각자의 나라의 가장 가까운 캐시 서버에서 데이터를 광속으로 받아가게 됩니다.
두번째 stale-while-revalidate=30의 의미는 60초의 유통기한이 끝나고, 새 데이터를 서버에서 가져올 때까지
보통은 빈 화면에서 기다려야 하지만, 이 옵션을 30초로 설정하면 사용자에게 빈 화면 대신 일단 낡은 데이터를 즉시 보여주고
뒤에서 몰래 신선한 데이터를 새롭게 굽습니다.
이제 이 과정을 통해 어떻게 성능 최적화를 할 수 있는지 실전으로 알아보겠습니다.
Next.js는 위의 복잡한 개념들을 개발자가 수동으로 관리하지 않아도 되도록 시스템 내부에 자동화해두었습니다.
그 첫번째가 Request Memoization 입니다.
우리가 예전에 서버 컴포넌트를 설계할 때 여러 컴포넌트에서 동일한 데이터가 필요하더라도
상위에서 하위로 데이터를 넘기지 말고, 각각 API를 호출해야 했습니다.
Next.js는 한번의 랜더링 사이클 내에서 동일한 주소에 요청을 가로채어 실제 네트워크 통신은 1번만 수행하고
나머지는 메모리에서 즉시 복사해 나누어 줍니다. 이 Request Memoization을 코드로 직접 확인해보겠습니다.
먼저 셋팅이 하나 필요한데, 서버 단에서는 네트워크 통신과 데이터 통신 최적화는 Next.js에서 직접 통제,검증해야 합니다.
따라서 next.config.ts 옵션에서 logging 옵션을 통해 서버가 background에서 fetch를 날릴 때마다 터미널에 로그를 날려줍니다.
const nextConfig: NextConfig = {
  reactCompiler: true,
  logging: {
    fetches: {
      fullUrl: true
    }
  }
}

export default nextConfig
이제 다음과 같은 폴더에 page.tsx 서버 컴포넌트를 작성해보겠습니다.
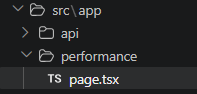
예시로, 실제 Github API를 연동하여 vercel의 Next.js 저장소 정보를 가져오겠습니다.
async function getNextjsStats() {
  const res = await fetch('https://api.github.com/repos/vercel/next.js', {
    next: { revalidate: 3600 }
  })

  if (!res.ok) throw new Error("Github 데이터를 가져오는데 실패했습니다")
  return res.json()
}
여기서 fetch의 두번째 인자 { next : ..... } 에 주목해야 합니다.
본래 fetch API는 브라우저와 Node.js에서 제공하는 웹 표준 기술이며, Next.js가 만든 것이 아닙니다.
하지만, Next.js 설계자들은 이 표준 fetch를 프레임워크 내부에서 몰래 확장했습니다.
그리고, 개발자가 표준 fetch에는 존재하지 않는 Next.js의 고유한 캐싱 기능이나 재검증 시간을 통제하도록
next라는 이름의 특수 제어 패널을 주입한 것입니다.
특히 Next.js 15+ 부터는 fetch가 자동으로 캐싱되지 않아, next 옵션에 revalidate: 3600 옵션을 주어,
Next.js에서는 3600초동안 강제로 캐싱하라는 설정을 넣은 것입니다.
이어서 메인 서버 컴포넌트의 로직을 살펴봅니다. 함수 초기 구조는 다음과 같이 작성했습니다.
export default async function PerformancePage() { ... }안의 메인 로직을 살펴보면, 의도적으로 Github API를 의도적으로 2번 연속으로 호출했습니다.
const data1 = await getNextjsStats()
const data2 = await getNextjsStats()
논리적으로 생각하면 Github API가 2번 네트워크 통신이 발생해야 합니다.
실제로 2번 타격하는지, 1번만 타격하는지 테스트해보겠습니다. (참고로, npm run build & npm run start로 해야합니다)
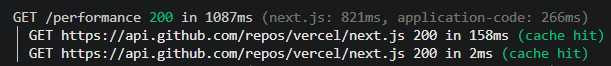
여기서 확인할 점은 첫번째 요청은 수십ms가 소요되었지만, 두번째 요청은 단 2ms에 불과하며
초록색 글씨로 cache hit라고 명확하게 찍혀있습니다.
두번째 요청부터는 즉 네트워크 요청을 차단하고 메모리에 있던 데이터를 반환한다는 의미입니다.
Route Handler Caching
Request Memoization을 넘어, 수만 명의 사용자가 시스템을 공유할 때를 대비하는 거대한 성능 튜닝인
Route Handler Caching을 다루겠습니다.
여기서 필요한 배경지식은 이러합니다. Next.js 14 까지는 GET 요청이 프레임워크가 알아서 정적으로 캐싱해버렸습니다.
그러나, Next.js 15+ 부터는 API Routes가 매 요청마다 무조건 새롭게 연산을 수행하는 동적 랜더링이 기본값이 되었습니다.
만약 우리가 아무 조치를 취하지 않는다면, 수만명의 접속자가 몰리면, 수만번의 데이터베이스 조회를 수행해야 할 것입니다.
실무에서 fetch API 뿐만 아니라 Prisma(ORM) 혹은 외부 결제 SDK를 사용할 때는 어떤 옵션을 써야할까요?
이 때 필요한 것이 파일 전체 즉 라우터 세그먼트 전체를 통제로 얼려버리는 거대한 방어체계입니다.
아래와 같은 설정을 통해 이 세그먼트 내부에서 일어나는 모든 연산의 응답을 60초 동안 서버 캐시에 고정합니다.
export const revalidate = 60이 원리는 프레임워크가 이 세그먼트 내의 최종 결과물을 백그라운드 캐시 인프라에 스스로 묶어둡니다.
아키텍트가 일일히 헤더를 조작할 필요 없이 프레임워크 차원에서 방어체계를 구축하는 것입니다.
이벤트 기반 아키텍처 및 웹훅
HTTP 통신 방식에서는 치명적인 한계가 하나 존재합니다. 클라이언트가 먼저 말을 걸어야만 서버가 움직이기 때문입니다.
만약 다음과 같은 경우를 생각해봅시다.
우리가 운영하는 Github 오픈소스 저장소에 누군가 일정 버튼을 눌렀을 때 백엔드 서버가 알아채고 Slack에 알림을 보내야 합니다.
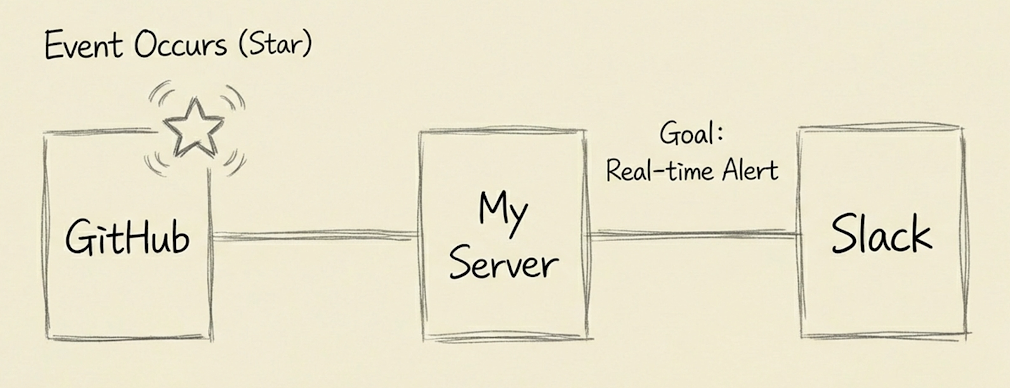
우리 서버는 클라이언트가 접속하기를 마냥 기다릴수만은 없으며, 외부 상태를 알아채야 하는 상황입니다.
이 때, Polling 방식이 있지만 아키텍트의 시선으로 이는 최악의 시스템 설계 방식입니다.
아무 일도 일어나지 않는 상황에도 서버는 계속 네트워크 커넥션을 열어야 하고, API를 계속 두드려야 합니다.
이 때 응답의 99%는 변화 없는 무의미한 데이터일 뿐입니다.
이것은 결국 양쪽 서버 모두에게 엄청난 네트워크 대역폭 낭비와 시스템 부하를 일으키며 시스템을 붕괴시킵니다.
이러한 수동적인 비효율성을 해결하기 위해 등장한 패러다임이 이벤트 기반 아키텍처(EDA) 입니다.
웹 생태계에서 이것을 기반으로 구현할 수 있는 가장 강력한 물리적 도구가 웹훅(Web-Hook) 입니다.
특정 이벤트가 발생했을 때 내 코드가 실행되도록 운영 흐름에 갈고리를 걸어 흐름을 빼앗는 것에서 유래했습니다.
이러한 웹훅의 정확한 동작원리는 HTTP 클라이언트와 서버 역할의 완벽한 역전입니다.
웹훅을 설정하면, 그 이벤트가 발생하는 찰나에 Github 서버가 내부적으로 이벤트를 감지하고,
스스로 클라이언트로 변신하여, 그리고 우리 서버의 특정 주소로 이벤트를 발생시킨 정보를
JSON으로 채워 POST 요청을 합니다. 즉, 우리 서버는 그저 문을 열어두고, Github 서버가 던져주는 데이터를 받아먹습니다.
네트워크 낭비는 0%에 수렴하고, 사건 발생 즉시, 0.1s 만에 데이터를 수신하는 완벽한 실시간성을 보장받습니다.
이제 이 원리를 Next.js 코드로 구현해보겠습니다. 먼저 다음과 같은 파일을 만듭니다.
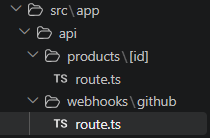
첫째로, 웹훅은 외부 인터넷망에서 우리 서버로 밀고 들어오는 데이터이기 때문에, 그 안전을 보장할 수 없습니다.
따라서, 아키텍트는 Github의 공식 API 명세서를 분석하여, 그 정보만을 정밀하게 추출하도록 엄격한 데이터 규격을 설정합니다.
interface GithubStarPayload {
  action: 'created' | 'deleted'
  repository: {
    full_name: string
    stargzers_count: number
  }
  sender: {
    login: string
  }
}
두번째, Route Handler 함수를 만들어야 합니다. 여기서 POST Method를 사용합니다.
export async function POST(request: NextRequest) { ... }함수 내부로 들어가면, 먼저 request.json()를 비동기로 호출하여, 자바스크립트 객체로 해독합니다.
const payload: GithubStarPayload = await request.json()객체 분해 할당 문법을 이용해, 각 속성을 가져옵니다.
const { action, repository, sender } = payloadaction이 새롭게 생성된 created 상태일 때만, 알림 console 출력하도록 설계합니다.
실무에서는 사내 Slack에 연동하거나, DB를 불러오는 로직이 이에 해당됩니다.
if (action === 'created') {
  console.log(`[실시간 알람] ${sender.login} 님이 ${repository.full_name}에 눌렀습니다.`)
  console.log(`별의 총 개수는 ${repository.stargazers_count}개입니다.`)
}
그리고, 깃허브 서버에게 데이터를 안전하게 받았다는 응답을 보냅니다.
return NextResponse.json({ success: true }, { status: 200 })그리고 앞에서 try 문을 통해 catch 하여 에러 방어선까지 구축합니다.
} catch(error) {
  console.error('웹훅 처리 중 오류가 발생했습니다: ', error)
  return NextResponse.json({ message: '잘못된 페이로드입니다.' }, { status: 400 })
}
여기서 결과를 테스트할 때 웹훅의 단점은 localhost는 외부 Github 서버가 직접 뚫을 수 없는 막힌 공간이라는 것입니다.
따라서 우리는 Postman을 사용하여, 우리가 마치 Github 서버가 된 것처럼 가짜 웹훅 데이터를 서버에 쏘아볼 것입니다.
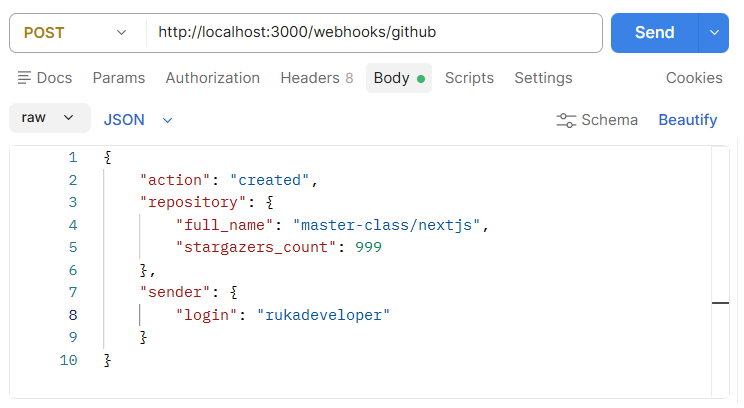
이렇게 되면 결과값으로 { success: true } 가 아래와 같이 반환됩니다.
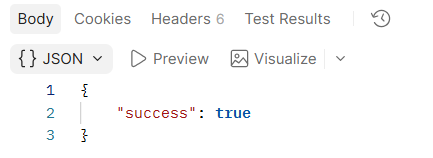
최종적으로 서버에서 console을 확인해보면

정확히 잘 뜨는 것을 확인할 수 있습니다.
외부 연동하는 RESTful API 구축 파이프라인
이번 프로젝트의 최종 목표는 Github 저장소에 누군가 별을 누르면, 신호를 Next.js API 서버가 수신하여
통제소에 기록하고 이를 다시 프론트엔드 화면으로 내어주는 실시간 알림 시스템을 구현합니다.
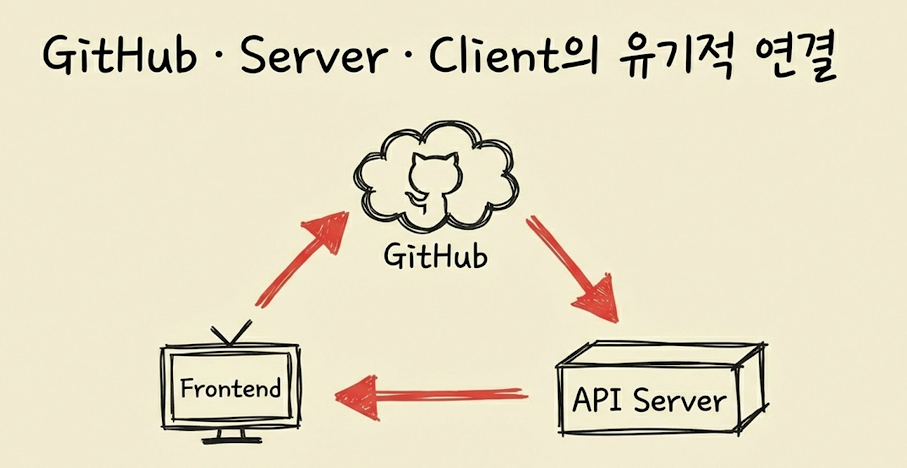
먼저 백엔드 로직의 시작점을 api/ 폴더로 시작해 격리합니다.
첫번째로, Star 이벤트를 위한 전용 폴더인 app/src/webhooks/stars를 만들고 그 곳에 route.ts를 만듭니다.
이 파일은 2개의 거대한 책임을 지게 되는데
첫번째, 외부 Github에 이벤트를 수신하는 POST 통제소의 역할이며, 두번째 저장된 데이터를 FE로 내어주는 GET 브릿지입니다.
자세한 코드 분석을 보겠습니다.
먼저, StarEvent 라는 타입스크립트 인터페이스를 선언했습니다.
interface StarEvent {
  sender: {
    login: string;
    avatar_url: string;
  }
  repository: {
    full_name: string;
  }
  strred_at: string;
}
그 아래에 선언된 starEvents 배열을 통해 서버가 켜져있는 동안 저장할 수 있는 인메모리 데이터베이스 방식을 채택합니다.
let starEvents: StarEvent[] = []이제 본격적으로 POST 핸들러 로직을 살펴봅시다.
export async function POST(request: NextRequest) { ... }아래 메인 로직을 살펴보면, 먼저 들어온 Request 객체를 비동기적으로 해독합니다.
필수 데이터가 누락되었다면, 가차없이 400번 에러를 반환하는 유효성 검사를 수행합니다.
검증을 통과했다면 현재 시간을 주입합니다.
그리고, 방금 들어온 최신 알림을 배열의 맨 앞에 끼워넣고, 배열의 크기를 최대 5개로 잘라내어 메모리 누수를 방지합니다.
작업이 성공하면 201 상태코드를 반환하고, 시스템 내부 오류 시에는 500 에러를 반환합니다.
try {
   const body: StarEvent = await request.json()

   if (!body.sender?.login || !body.repository?.full_name) {
       return NextResponse.json({ error: '유효하지 않은 데이터 규격입니다' }, { status: 400 })
   }

   body.strred_at = new Date().toISOString()

   starEvents = [body, ...starEvents].slice(0, 5)
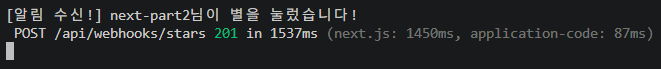
   console.log(`[알림 수신!] ${body.sender.login}님이 별을 눌렀습니다!`)

   return NextResponse.json({ message: '시스템 기록 완료' }, { status: 201 })
} catch (e) {
   return NextResponse.json({ error: '시스템 내부 오류' }, { status: 500 })
}
그리고, FE 화면으로 응답시켜줄 GET Method도 작성합니다.
export async function GET() {
    return NextResponse.json({
        events: starEvents,
        updatedAt: new Date().toISOString()
    })
}
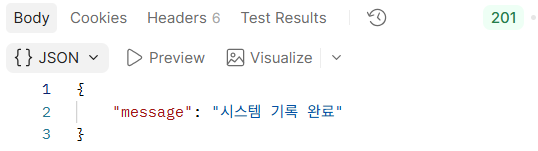
FE 화면을 구현하기 전에 Postman을 통해 1차 검증을 합니다.
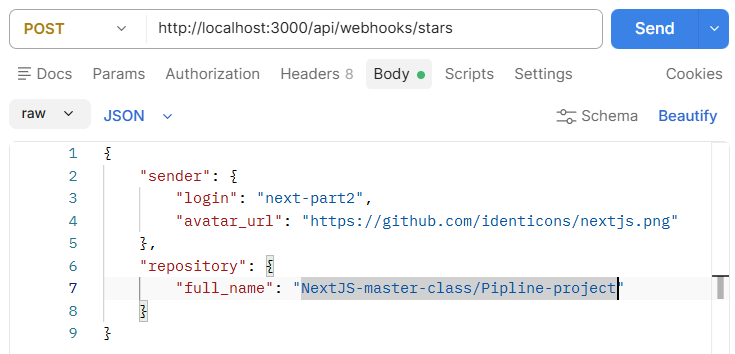
아래처럼 정상적으로, 201 Status를 반환합니다.
서버 터미널에서도 아래처럼 정상 알림 콘솔을 반환합니다.
이제 Postman으로 1차 검증이 완료되었으니 BE API를 FE 환경에서 호출하여 UI를 구현합니다.
다음과 같은 경로로 page.tsx 파일을 만들어주세요.
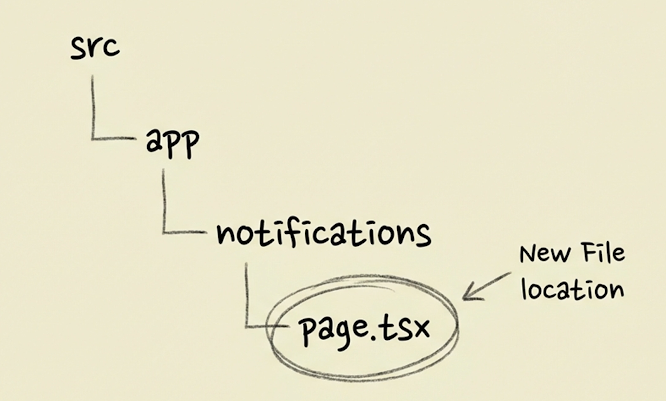
이 컴포넌트는 서버 환경에서 직접 데이터 파이프라인을 당겨오는 서버 컴포넌트입니다.
로직을 살펴보면 먼저 받을 알림 데이터를 먼저 규격화합니다.
interface NotificationData {
  events: {
    sender: { login: string; avatar_url: string; }
    repository: { full_name: string }
    starred_at: string
  }[]
  updatedAt: string
}
그리고, 컴포넌트 함수를 작성하는데, 먼저 fetch 함수를 통해 GET API 라우터를 타격합니다.
실시간 형식이므로, 여기서 cache: 'no-store' 옵션을 통해 캐싱 없이 항상 신선한 데이터를 가져옵니다.
const response = await fetch(`http://localhost:3000/api/webhooks/stars`, {
  cache: 'no-store'
})
응답받은 데이터를 비동기 해석하여 자바스크립트 객체로 받아냅니다.
const data: NotificationData = await response.json()마지막으로, 화면 랜더링을 아래와 같이 구성합니다.
return (
    <div style={{ padding: '40px', fontFamily: 'sans-serif' }}>
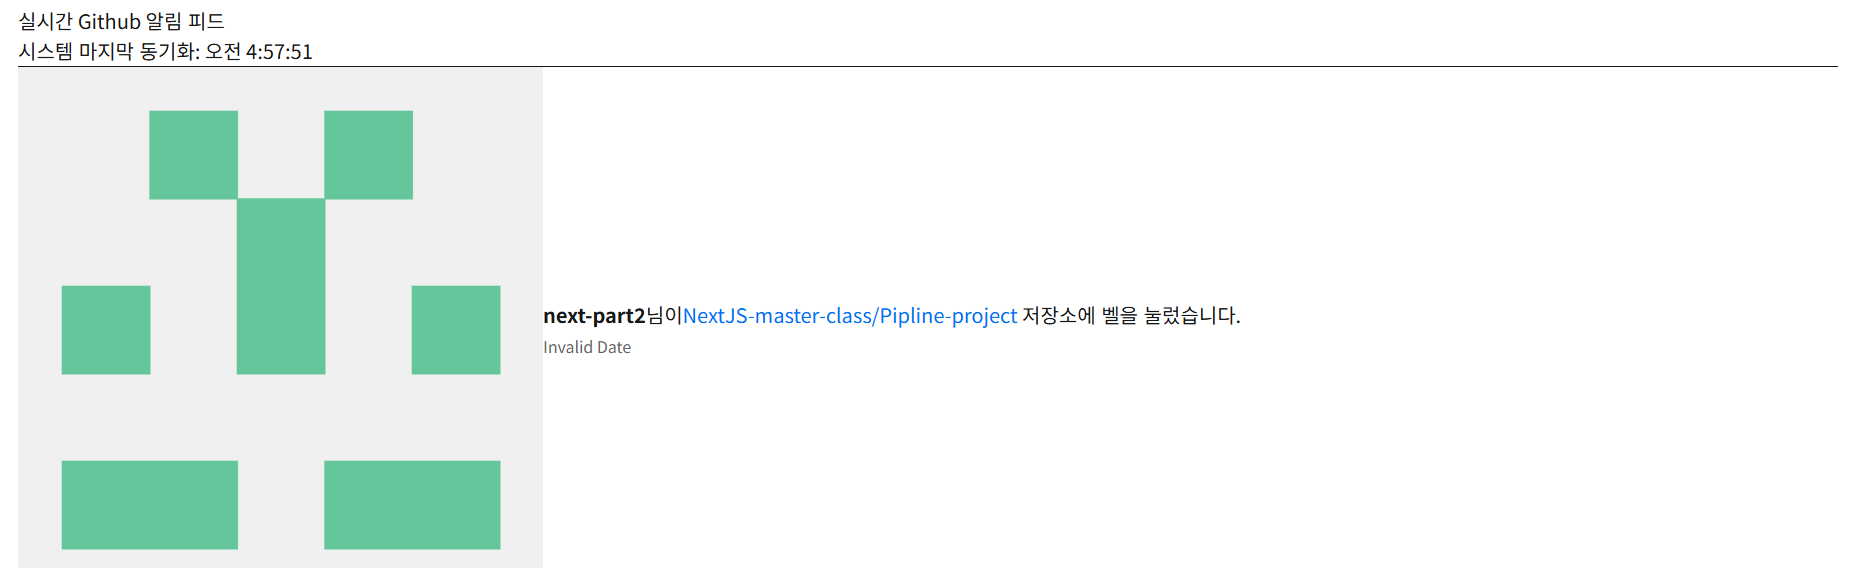
        <h1>실시간 Github 알림 피드</h1>
        <p>시스템 마지막 동기화: {new Date(data.updatedAt).toLocaleTimeString()}</p>
        <hr />
        {data.events.length === 0 ? (
            <p>아직 수신된 알림이 없습니다. Postman으로 이벤트를 트리거해보십시오.</p>
        ) : (
            <ul style={{ listStyle: 'none', padding: 0 }}>
                {data.events.map((event, index) => (
                    <li key={index}
                        style={{ marginBottom: '20px', display: 'flex', alignItems: 'center' }}
                    >
                        <img src={event.sender.avatar_url} alt="profile" />
                        <div>
                            <strong>{event.sender.login}</strong>님이
                            <span style={{ color: '#0070f3' }}>
                                {event.repository.full_name}
                            </span> 저장소에 벨을 눌렀습니다.
                            <br />
                            <small style={{ color: '#666' }}>
                                {new Date(event.starred_at).toLocaleString()}
                            </small>
                        </div>
                    </li>
                ))}
            </ul>
        )}
    </div>
  )
}
최종적으로, 다음과 같이 UI가 업데이트 되는 것을 확인했습니다.