넘파이(Numpy)
넘파이 라이브러리는 Python에서 수치 연산, 다차원 행렬 연산 등을 빠른 속도로 처리하기 위해
이용되는 라이브러리이며, 대부분 머신러닝/딥러닝 프레임워크들이 넘파이 기반으로 만들어져 있습니다.
넘파이에서 제공하는 핵심 객체가 ndarray 객체입니다. 다차원 배열이라고도 부릅니다.
Python에 다차원 List가 있는데 왜 굳이 ndarray를 사용할까요?
그 이유는 내부적으로 C언어로 만들어져 있어 성능적으로 훨씬 빠르고, 훨씬 적은 메모리를 사용하며
선형대수나 통계관련 여러 수치 함수를 제공하며, 수많은 모듈에서 numpy 함수명과 그 기능을 그대로 사용하기 때문입니다.
먼저, numpy 라이브러리를 설치하고, 임포트합니다.
import numpy as np넘파이에서 제공하는 다차원 배열은 차원의 개수에 많은 영향을 받습니다.
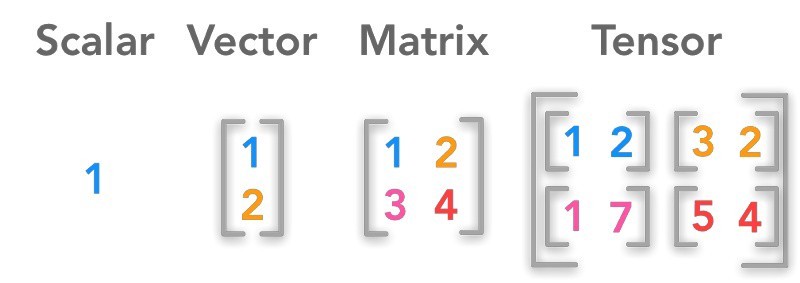
0차원 단일 값은 Scalar, 1차원 배열은 Vector, 2차원 배열은 Matrix, n차원 배열은 Tensor라고 부릅니다.
1차원 배열 (벡터)
넘파이에서 제공하는 array() 함수로 numpy array 객체를 생성할 것입니다.
arr1 = np.array([1, 2, 3, 4, 5])
print(arr1) # [1 2 3 4 5] or array([1, 2, 3, 4, 5])
이 numpy 1차원 배열의 타입을 확인해보겠습니다. 결과는 numpy.ndarray 타입으로 해석됩니다.
print(type(arr1)) # numpy.ndarray리스트와의 가장 큰 차이점은 리스트는 원소가 여러 타입들을 지원하지만, ndarray는 한 타입으로 통일해야 합니다.
[1, 2, 3.14, '김', True] # 리스트의 요소는 서로 다른 타입을 가질 수 있습니다.
arr1 = np.array([1, 2, 3, 4, 5]) # ndarray는 요소가 한 가지 타입으로 이루어져야 합니다.
이제 n차원 배열의 대표적인 속성을 알아보겠습니다.
첫번째 속성은 shape 입니다. 넘파이에서는 해당 차원의 array의 크기를 알 수 있습니다.
shape를 확인함으로써, 몇 개의 데이터가 있는지, 몇 차원으로 존재하는지 확인할 수 있습니다.
shape는 최종적으로 차원별 크기를 원소로 하는 튜플을 반환합니다. 1차원 배열에서는 원소가 1개입니다.
arr1.shape # (5,)두번째 속성은 ndim 입니다. 이것은 현재 다차원 배열이 몇 차원인지 반환하여 줍니다.
arr1.ndim # 1세번째 속성은 size 입니다. 이것은 그 안에 담겨있는 데이터의 개수입니다.
arr1.size # 5네번째는 len() 함수입니다. ndarray에도 ndarray의 원소 길이를 의미하는 len() 적용이 가능합니다.
그 이유는 ndarray도 iterable한 객체이기 때문입니다.
len(arr1) # 5다섯번째 속성은 dtype입니다. ndarray는 그 안에 있는 데이터가 모두 동일한 타입이기 때문입니다.
arr1.dtype # dtype('int64')뒤에 있는 64는 차지하는 용량으로써 **64bit(=8 bytes)**를 의미합니다.
여섯번째 경우는 리스트의 원소가 서로 하나의 데이터 타입이 아닐 때 ndarray는 어떻게 처리할까요?
다음과 같은 예시를 통해 알아보겠습니다.
arr2 = np.array([10, 3.14, 2, 0.12])결론적으로 가장 범위가 큰 타입인 실수 타입(float)으로 통일됩니다.
arr2 # array([10. , 3.14, 2. , 0.12])실제로 dtypes를 확인하면 실수 타입(float)으로 확인됩니다.
arr2.dtype # dtype('float64')2차원 배열 (매트릭스 / 행렬)
넘파이에서 제공하는 array() 함수로 2차원 리스트를 통해 ndarray를 생성합니다.
arr2d = np.array([[2, 3, 4], [1, 2, 4]])n차원 리스트의 원소는 (n-1)차원 리스트가 되므로, 2차원 리스트의 원소는 1차원 리스트가 됩니다.
각각 [2, 3, 4]와 [1, 2, 4]가 원소가 됩니다.
arr2d # array([[2, 3, 4], [1, 2, 4]])차원이 2개면 흔히 Matrix 혹은 행렬이라고 많이 표현합니다. 이 행렬은 2행 3열 행렬이 됩니다.
몇행 몇열인지는 shape 속성을 통해 확인할 수 있습니다.
arr2d.shape # (2, 3)마찬가지로, ndim 속성을 통해 몇 차원 데이터인지 확인 가능합니다.
arr2d.ndim # 2위에서 2차원 배열의 원소는 1차원 배열이라고 했으므로, 1차원 배열 뭉텅이의 갯수는 총 2개가 됩니다.
따라서 2차원 배열의 길이는 2개가 됩니다.
len(arr2d) # 2반대로, size 속성은 그 안에 있는 스칼라값 원소의 갯수이므로, 총 2 x 3 = 6개가 됩니다.
arr2d.size # 6여기서 주목해야 할 점은 차원의 개념입니다. 즉, 동일한 어떤 스칼라값을 가져도 차원이 다를수가 있다는 것입니다.
예시를 통해 알아보겠습니다.
먼저, 원소를 10으로 하는 0차원 배열(스칼라)을 만들겠습니다.
arr_0d = np.array(10)
arr_0d # array(10)
그 다음, 원소를 10으로 하는 크기 1의 1차원 배열(벡터)을 만들겠습니다.
arr_1d = np.array([10])
arr_1d # array([10])
마지막으로 원소를 [10]으로 하는 크기 1의 2차원 배열(매트릭스)을 만들겠습니다.
arr_2d = np.array([[10]])
arr_2d # array([[10]])
정리하면, 10이라는 데이터를 동일하게 가지고 있지만 현재 차원만 다른 상황입니다.
여기서 item() 함수를 통해 size가 1인 ndarray의 데이터 값을 추출해봅시다.
arr_0d.item() # 10
arr_1d.item() # 10
arr_2d.item() # 10
데이터값 자체는 10으로 모두 동일한 값이 추출됩니다. 즉, 데이터값은 같아도 차원이 다를 수가 있다는 점입니다.
또 다른 ndarray 생성 함수 - arrange()
np.arange() 함수는 Python의 range() 함수와 유사하며, 넘파이 ndarray 객체를 생성할 수 있습니다.
0부터 9까지의 숫자를 원소로 가지는 1차원 ndarray를 생성해보겠습니다.
np.arange(10) # array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])1부터 9까지의 숫자를 원소로 가지는 1차원 ndarray의 경우, start parameter를 사용합니다.
np.arange(1, 10) # array([1, 2, 3, 4, 5, 6, 7, 8, 9])또, steps parameter를 통해 건너뛰는 값을 사용할 수도 있습니다.
np.arange(1, 10, 2) # array([1, 3, 5, 7, 9])또 다른 배열 객체 만드는 함수 - ones, zeros, eye, full
첫번째, np.ones()는 1로 꽉 채워진 ndarray를 생성합니다. dtype은 float64로 생성됩니다.
원하는 dtype으로 변환하고 싶다면, parameter에 dtype 옵션을 추가하면 됩니다.
n차원 배열로 변환하고 싶다면 튜플 값으로 각 차원별 데이터 개수를 명시하면 됩니다.
np.ones(6) # array([1. , 1. , 1. , 1. , 1. , 1. ])
np.ones(6, dtype=np.int16) # array([1, 1, 1, 1, 1, 1], dtype=int16)
np.ones((2, 3), dtype=np.int16) # array([[1, 1, 1], [1, 1, 1]], dtype=int16)
두번째, np.zeros()는 0으로 꽉 채워진 ndarray를 생성합니다. dtype은 float64로 생성됩니다.
사용 방식은 np.ones()와 동일합니다.
np.zeros((3, 2, 5), dtype=np.int16)
'''
array([
[
[0, 0, 0, 0, 0],
[0, 0, 0, 0, 0]
],
[
[0, 0, 0, 0, 0],
[0, 0, 0, 0, 0]
],
[
[0, 0, 0, 0, 0],
[0, 0, 0, 0, 0]
])
'''
세번째, np.eye()는 단위 행렬을 생성하며, 주 대각선만 1이고 나머지는 0인 (N, N) ndarray를 생성합니다.
np.eye(5, dtype=np.int32)
'''
array([
 [1, 0, 0, 0, 0],
 [0, 1, 0, 0, 0],
 [0, 0, 1, 0, 0],
 [0, 0, 0, 1, 0],
 [0, 0, 0, 0, 1]
])
'''
네번째, np.full()는 특수한 값으로 채워진 ndarray를 생성합니다. 사용 방식은 **np.full(shape, fill_value)**입니다.
np.full((2, 3), 10)
# array([[10, 10, 10], [10, 10, 10]])
차원 변환 - reshape()
만들어진 ndarray의 차원을 자유자재로 바꾸는 함수이며, 머신러닝 / 데이터 프로세싱에서 자주 사용됩니다.
먼저 0부터 11까지의 1차원 배열을 하나 만들겠습니다.
arr = np.arange(12) # array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11])이것을 2행 6열의 2차원 배열로 차원 변환하겠습니다.
arr.reshape(2, 6) # array([[0, 1, 2, 3, 4, 5], [6, 7, 8, 9, 10, 11]])다만 reshape의 parameter를 서로 곱한 값이 기존 ndarray의 size와 맞지 않는다면 오류입니다.
랜덤 모듈 - random
랜덤 값으로 채워진 배열을 만들고 싶을 때 넘파이의 np.random 서브 모듈에 있는 함수를 사용합니다.
첫번째, rand() 함수로 0부터 1 사이까지의 랜덤 값으로 배열을 만듭니다.
랜덤 값이 등장하는 확률 분포는 전 구간이 동일합니다. 즉, 균일하게 샘플링이 된 랜덤값입니다.
np.random.rand(10)
# array([0.231, 0.675, 0.107, 0.610, 0.291, 0.514, 0.398, 0.577, 0.993, 0.539])
두번째, randn() 함수로 정규 분포에 준한 랜덤값을 만듭니다. 평균을 0으로 두고 표준편차가 1인 종 모양 분포입니다.
즉, 음수값이 랜덤 값으로 나올수도 있습니다.
np.random.randn(5)
# array([-1.25, -2.07, -0.97, 2.51, 0.54])
세번째, seed() 함수로 랜덤값을 매번 달라지는 것이 아니라 고정된 난수값을 나오게 하는 것입니다.
np.random.seed(0) # array([0.54, 0.71, 0.60, 0.54])ndarray에서의 인덱싱
Python의 리스트에서의 인덱싱과 동일한 개념으로 사용되며
튜플을 사용하여 차원이 하나씩 줄어들어 각 차원별 인덱스에 접근할 수 있습니다.
예를 들어, 다음과 같은 1차원 배열이 있다고 해보겠습니다.
x = np.arange(10) # array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])1차원 배열은 기존의 리스트 인덱싱과 똑같이 하면 됩니다. 참고로 타입은 int로 넣었을 경우, numpy.int64에 해당됩니다.
x[0] # np.int64(0)여기서 Python int 값으로 뽑아내고 싶다면, item() 함수를 사용하면 됩니다.
x[0].item() # 0리스트와 같이 인덱싱을 통해 값을 수정할 수도 있습니다.
x[3] = 100
x # array([0, 1, 2, 100, 4, 5, 6, 7, 8, 9])
이번엔, reshape() 함수를 이용해 2차원 배열로 변환하여 2차원 배열에 대한 인덱싱을 알아보겠습니다.
y = np.arange(10).reshape(2, 5)
# array([0, 1, 2, 3, 4], [5, 6, 7, 8, 9]])
스칼라 값에 접근하기 위해 리스트에서처럼 인덱싱을 2번 사용하는 방법이 있습니다.
y[0][2] # np.int64(2)하지만, 넘파이에서는 튜플처럼 콤마로 차원별 인덱싱이 가능합니다. 넘파이에서만 가능한 방법입니다.
y[0, 2] # np.int64(2)또, 넘파이에서는 Integer Array Indexing을 제공합니다. Advanced Indexing이라고도 하는 인덱싱 방법입니다.
다음과 같은 1차원 배열을 만들겠습니다.
x = np.arange(100, 1000, 100)
# array([100, 200, 300, 400, 500, 600, 700, 800, 900])
만약 인덱싱할 때, 리스트 형태(iterable 형태)로 인덱싱을 했을 때 차원이 감소되지 않고, 데이터를 뽑아줍니다.
x[[0]] # array([100])[ ] 안에 리스트를 넣을 수 있으므로, 콤마(,)로 구분하여 다양한 인덱스 값을 넣을 수 있습니다.
x[[0, 7, 5]] # array([100, 800, 600])ndarray에서의 슬라이싱
리스트, 문자열에서의 슬라이싱과 동일한 개념으로 사용합니다.
튜플을 사용하여 각 차원별로 슬라이싱이 가능하며, 슬라이싱은 차원 변화가 없습니다.
다음과 같은 1차원 배열이 있다고 가정하겠습니다.
x = np.arange(100, 1000, 100)
# array([100, 200, 300, 400, 500, 600, 700, 800, 900])
1부터 6까지의 인덱스를 슬라이싱하겠습니다.
x[1:7] # array([200, 300, 400, 500, 600, 700])전체를 슬라이싱할 경우, 아래와 같이 2가지 경우가 있습니다.
x[:] # array([100, 200, 300, 400, 500, 600, 700, 800, 900])
x[...] # array([100, 200, 300, 400, 500, 600, 700, 800, 900])
전체를 슬라이싱하되, 2칸씩 건너뛸 경우 아래와 같이 작성합니다.
x[::2] # array([100, 300, 500, 700, 900])2차원 배열의 경우에는 어떻게 슬라이싱하게 될까요? 먼저 리스트의 경우를 생각해보겠습니다.
다음과 같은 2차원 리스트가 있다고 가정하겠습니다.
y = [[0, 1, 2, 3, 4], [5, 6, 7, 8, 9], [10, 11, 12, 13, 14]]행(axis=0)에 대한 0부터 1까지 슬라이싱해보겠습니다.
y[0:1] # [[0, 1, 2, 3, 4]]그렇다면 다음과 같이 슬라이싱하려면 어떻게 해야할까요?
''' [[1, 2, 3], [6, 7, 8]] '''먼저 행(axis=0)에 대해서 슬라이싱해보겠습니다.
y[:2] # [[0, 1, 2, 3, 4], [5, 6, 7, 8, 9]]하지만 열(axis=1)에 대해서 추가로 슬라이싱이 불가능합니다. 그 이유는 차원별 슬라이싱이 불가능하기 때문입니다.
y[:2][1:4] # 차원 변화가 없으므로 [[5, 6, 7, 8, 9]]반면에, ndarray는 차원별 슬라이싱이 가능하다는 장점이 있습니다.
다음과 같은 2차원 배열이 있다고 해보겠습니다.
x = np.arange(15).reshape(3, 5)
'''
array([[0, 1, 2, 3, 4],
       [5, 6, 7, 8, 9],
       [10, 11, 12, 13, 14]])
'''
튜플을 구분하듯이 콤마(,)로 구분해서 차원별로 슬라이싱하면 됩니다.
x[:2, 1:4] # [[1, 2, 3], [6, 7, 8]]슬라이싱할 때, 해당 인덱스만 선택해서 인덱싱하고, 슬라이싱할 수도 있습니다.
x[2, 1:4] # [11, 12, 13]차원변경하기 - ravel, flatten, reshape
차원변환은 데이터 분석과 인공지능에서 빈번하게 발생되는 작업이니만큼 자유자재로 변환할 수 있어야 하고
머리속으로 내가 변환하는 데이터의 구조가 그려지도록 익숙해져야 하는 작업입니다.
ravel() 및 np.ravel() 그리고 flatten() 함수는 다차원 배열을 1차원 배열로 펼치는 작업입니다.
다음과 같은 다차원(2차원) 배열이 있다고 가정하겠습니다.
x = np.arange(15).reshape(3, 5)
'''
array([[0, 1, 2, 3, 4],
       [5, 6, 7, 8, 9],
       [10, 11, 12, 13, 14]])
'''
ravel()을 통해 3 x 5 2차원 배열을 1차원 배열로 펼쳐주겠습니다.
x.ravel() # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14]같은 문법으로, np.ravel()을 사용할 수도 있습니다.
np.ravel(x) # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14]같은 원리로 flatten()을 사용할 수도 있습니다.
x.flatten() # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14]세 가지 경우 모두 order parameter가 존재합니다.
기본값은 C이며, row 우선으로 펼칩니다. 또 다른 값은 F이며 column 우선으로 펼칩니다.
x.flatten(order='F') # [0, 5, 10, 1, 6, 11, 2, 7, 12, 3, 8, 13, 4, 9, 14]하지만 무엇보다 다루기 쉽고 직관적인 것은 reshape 함수입니다.
앞서 다룬 reshape 내용과 똑같으며, reshape에 -1 값을 주면, 차원 유추할 수 있습니다.
다음과 같은 예시를 살펴봅시다. 총 데이터가 36개인 6 x 6 행렬을 만들겠습니다.
x2 = np.arange(36).reshape(6, 6)reshape 값에 -1를 주려면, 2번째 파라미터에 적습니다.
당연히 사이즈가 기존 배열과 같아야 하므로, 유추가 되기 때문입니다. 다만 차원 유추는 하나만 허용됩니다.
x2.reshape(6, -1, 2).shape # (6, 3, 2)차원 확장/제거 - expand_dims, squeeze
다음과 같은 예시를 통해 차원을 확장하고 제거하는 방법을 알아보겠습니다.
먼저 shape가 (6,)인 1차원 배열을 초기화하겠습니다.
x3 = np.arange(6) # [0, 1, 2, 3, 4, 5]이것을 reshape로 이용해 shape가 (6, 1)인 2차원 배열로 확장해보겠습니다.
x3 = x3.reshape(6, 1) # [[0], [1], [2], [3], [4], [5]]여기서 squeeze()를 사용해 차원 크기가 1인 차원을 제거해보겠습니다.
x3 = x3.squeeze() # [0, 1, 2, 3, 4, 5]이후에 expand_dims()를 사용해 특정 차원축(axis)에 새로운 차원을 추가할 수 있습니다.
먼저 0번째 차원축에 새로운 차원을 추가합니다.
x3 = np.expand_dims(x3, axis=0)
# (6,) -> (1, 6)
# [[0, 1, 2, 3, 4, 5]]
그리고, 마지막 차원축에 차원을 추가해보겠습니다.
x3 = np.expand_dims(x3, axis=-1)
# (1, 6, 1)
# [[[0], [1], [2], [3], [4], [5]]]
또, 차원축을 추가하는데 np.newaxis를 사용할수도 있습니다.
다음과 같은 shape가 (4, )인 1차원 배열이 있다고 가정합시다.
x4 = np.array([2, 0, 1, 8])여기서 np.newaxis를 통해 차원축을 추가합니다.
인덱싱처럼 처리해서 newaxis를 넣은 위치에 차원이 추가됩니다. (여기에선 axis=0 위치에 추가합니다)
이것을 1차원 벡터를 row vector로 변환했다고도 표현합니다.
x4 = x4[np.newaxis, :] # (4, ) -> (1, 4)반대로 axis=-1 위치에 추가하면 1차원 벡터를 column vector로 변환했다고도 표현합니다.
x4 = x4[:, np.newaxis] # (4, ) -> (4, 1)차원 축 바꾸기 - transpose, T, swapaxes
transpose는 기존의 행렬에서 차원축을 역전시키는 행동입니다.
다음과 같은 3 x 5의 2차원 행렬이 있다고 가정해보겠습니다.
a = np.arange(15).reshape(3, 5)
'''
  [
   [0, 1, 2, 3, 4],
   [5, 6, 7, 8, 9],
   [10, 11, 12, 13, 14]
  ]
'''
여기서 transpose 연산을 하면 3 x 5 행렬이 5 x 3 행렬로 변환됩니다.
np.transpose(a)
'''
  [
   [0, 5, 10],
   [1, 6, 11],
   [2, 7, 12],
   [3, 8, 13],
   [4, 9, 14]
  ]
'''
혹은 넘파이에서 제공하는 T라는 속성을 이용할 수도 있습니다.
a.T
'''
  [
   [0, 5, 10],
   [1, 6, 11],
   [2, 7, 12],
   [3, 8, 13],
   [4, 9, 14]
  ]
'''
그 밖에도 swapaxes 함수를 통해 axis=0과 axis=1을 서로 반전시킵니다.
np.swapaxes(a, 0, 1)
'''
  [
   [0, 5, 10],
   [1, 6, 11],
   [2, 7, 12],
   [3, 8, 13],
   [4, 9, 14]
  ]
'''
브로드캐스팅(broadcasting) - 크기가 다른 배열끼리의 연산
크기 같은 배열끼리의 연산은 각 원소별로 진행하지만, 크기가 다른 배열끼리의 연산은 크기를 맞춘 후 진행합니다.
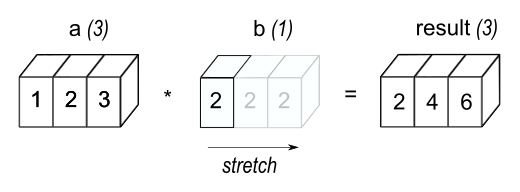
서로 shape가 다른 2개의 배열을 준비하겠습니다.
a = np.arange(12).reshape(4, 3) # (4, 3) [[0, 1, 2], [3, 4, 5], [6, 7, 8], [9, 10, 11]]
b = np.arange(100, 103) # (3,) # [100, 101, 102]
그 다음에 a + b 연산을 하면, 놀랍게도 연산이 됩니다.
원리는 shape가 작은 배열을 stretch하여 shape가 큰 배열과 shape를 맞추는 것입니다.
a + b # [[100, 102, 104], [103, 105, 107], [106, 108, 110], [109, 111, 113]]불린 인덱싱(Boolean Indexing)
ndarray 인덱싱 시에, bool list(mask)를 전달하여 True인 경우만 필터링합니다.
즉, for 문 사용하지 않고도 ndarray에서 조건에 맞는 데이터만 추출하는 기능입니다.
브로드캐스팅(broadcasting)을 활용하여 ndarray부터 bool list를 얻을 것입니다.
먼저, 고정된 시드값을 통해 1부터 99까지의 랜덤값을 추출합니다.
np.random.seed(41)
x = np.random.randint(1, 100, size=10)
# [65, 36, 13, 99, 81, 66, 90, 24, 86, 27]
나눗셈의 나머지 기능을 통해 0 혹은 1 값만 추출합니다.
x % 2
# [1, 0, 1, 1, 1, 0, 0, 0, 0, 1]
조건식을 통해 bool 형식의 ndarray를 얻습니다.
even_mask = x % 2 == 0
# [False, True, False, False, False, True, True, True, True, False]
이 bool 배열로 원본에 대해 인덱싱을 해줍니다. 원본에 대해 True인 부분만 필터링합니다.
x[even_mask] # [36, 66, 90, 24, 86]