함수(Function)
프로그래밍에서 동일한 혹은 비슷한 내용 코드가 반복될 때가 있습니다.
이러한 코드 낭비를 줄이기 위해 반복되는 코드를 모아서 하나의 함수로 정의해놓고, 사용(호출)하는 것입니다.
즉, 반복적으로 사용되는 가치가 있는 부분을 입력값을 주었을 때 어떤 일을 수행하고,
어떤 결과값을 돌려주는 것이 현명합니다.
함수를 정의할 때는 def 키워드로 아래와 같이 작성합니다.
def exampleFunction(a):
  return a
함수의 동작 정의는 매개변수를 통해 입력을 받고, 본체를 수행하여 최종적으로 결과값을 리턴하거나,
리턴하지 않을수도 있습니다.
호출할 때는 다음과 같이 호출합니다. 여기서 리턴값은 함수를 호출한 쪽에 반환합니다.
a = exampleFunction(10) # 10매개변수, 인자
매개변수는 함수 정의할 때 매개변수가 정의된 순서대로 적어야 합니다. (positional argument)
def func(name, age):
  print(f'안녕하세요 제 이름은 {name} 입니다.')
  print(f'안녕하세요 제 나이는 {age} 입니다.')

func('김은하', 23)
# 안녕하세요 제 이름은 김은하 입니다.
# 안녕하세요 제 나이는 23 입니다.
하지만 정의된 순서를 일일히 기억할 수는 없으므로, name=value 쌍으로 전달하는 호출도 있습니다.
def func(name, age):
  print(f'안녕하세요 제 이름은 {name} 입니다.')
  print(f'안녕하세요 제 나이는 {age} 입니다.')

func(age=23, name='김은하')
# 안녕하세요 제 이름은 김은하 입니다.
# 안녕하세요 제 나이는 23 입니다.
리턴 값
호출된 함수를 실행 중 return을 만나게 되면, 함수를 종료하거나, 호출한 쪽으로 값을 돌려줍니다.
def add(a, b):
  return a + b

a = add(1, 2) # 3
b = add(2, 3) # 6
디폴트 매개 변수
함수 정의 시 매개변수에 디폴트 값을 지정해주면, 호출 시 생략해도 디폴트 값이 적용됩니다.
def sayMyself(name, age, gender='M'):
  print(f'안녕하세요 제 이름은 {name} 입니다.')
  print(f'안녕하세요 제 나이는 {age} 입니다.')
  print(f'안녕하세요 제 성별은 {gender} 입니다.')

sayMyself('김은하', 23)
# 안녕하세요 제 이름은 김은하 입니다.
# 안녕하세요 제 나이는 23 입니다.
# 안녕하세요 제 성별은 M 입니다.
Argument Packing / Unpacking
함수 안에 매개변수 정의시 *를 붙이면, 복수개의 매개변수를 튜플 형태로 묶어, 패킹하여 사용합니다.
보통 관례적으로 *args를 많이 사용합니다.
def func_args(*args):
  print(args)

func_args(10) # (10,)
func_args(10, 20, 30) # (10, 20, 30)
함수 안에 매개변수 정의시 **를 붙이면, 함수의 인수로 key=value 형태로 보내면,
kwargs가 dict 형태로 패킹하여 사용합니다.
def func_kwargs(**kwargs):
  print(kwargs)

func_kwargs(name="John") # { 'name': 'John' }
func_kwargs(name="John", age=30) # { 'name': 'John', age: 30 }
반대로 호출시 *를 붙이면 리스트 혹은 튜플을 언패킹하여 전달합니다.
def print_val(kor, eng, math):
  print(kor, eng, math)

score = [10, 20, 30]
print_val(*score) # 10 20 30
역시 호출시 **를 붙이면 딕셔너리를 언패킹하여 전달합니다.
def print_dict(name, email):
  print(name, email)

student = { "name": "John", "email": "John@naver.com" }
print_dict(**student) # John John@naver.com
람다(Lambda)
이름이 없는 익명함수를 정의할 때 사용합니다.
사용방식은 lambda [parameter] : [리턴 값] 방식으로 사용합니다.
sqr = lambda x: x ** 2

sqr(10) # 100
여기서, map(), filter(), reduce() 등에서 람다 함수를 많이 응용합니다.
map()은 N개의 입력을 받아, 어떠한 동작을 적용하여 N개의 결과값을 생성하는 메소드입니다.
리턴 값은 이터러블한 map 객체입니다.
list(map(lambda x: x * 3, [10, 20, 30])) # [30, 60, 90]filter()은 N개의 입력받아, 어떤 조건을 만족하는 N'개를 생성하는 것입니다.
리턴 값은 이터러블한 filter 객체입니다.
list(filter(lambda x: x % 3 == 0, [3, 7, 9])) # [3, 9]문자열 함수
upper()는 문자열을 모두 대문자로 만드는 함수이고, lower()는 문자열을 모두 소문자로 만드는 함수입니다.
str1 = "Apple"
str1.upper() # APPLE (단, 원본에는 변화가 없습니다)
str1.lower() # apple (단, 원본에는 변화가 없습니다)
strip()은 좌우의 공백을 제거해주는 함수입니다.
a = "    Hello, Python!     "
print(a.strip()) # 'Hello, Python!'
replace()는 문자열을 치환해주는 함수로, 첫번째 인자에 해당하는 문자를 찾아
두번째 인자에 해당하는 문자로 치환합니다.
str1 = "Hello, Python!"
str1.replace("H","P") # 'Pello, Python!'
split()은 어떤 문자열을 기준으로 분리하여 각 요소들을 리스트에 저장합니다. 기본값은 " "로써 빈 문자열입니다.
fruits = "사과 키위 바나나 수박"
fruits.split() # ['사과','키위','바나나','수박']
join()은 어떤 문자열을 기준으로 리스트의 각 요소들을 연결하는 함수입니다.
data = ["A", "B", "C", "D", "E"]
"-".join(data) # A-B-C-D-E
index()와 find()는 어떤 문자열을 찾는데, 찾으면 원본 문자열의 인덱스 값을 리턴합니다.
다만 index()는 못 찾을 경우 ValueError를 리턴하고, find()는 못 찾을 경우 -1를 리턴합니다.
str2 = 'hello, python'
print(str2.index('lo')) # 3
print(str2.index('xx')) # ValueError
print(str2.find('lo')) # 3
print(str2.find('xx')) # -1
count()는 문자열 내에서 특정 문자열 패턴의 발견 갯수를 리턴합니다.
str4 = "aabababbabbaababb"
print(str4.count("ba")) # 5
startswith()는 어떤 문자열로 시작하는지, endswith()는 어떤 문자열 종료하는지 여부를 리턴합니다.
str3 = "https://www.nytimes.com/visions-identity-a-generation-s-teen-pressure.html"
print(str3.startswith('http')) # True
print(str3.startswith('html')) # True
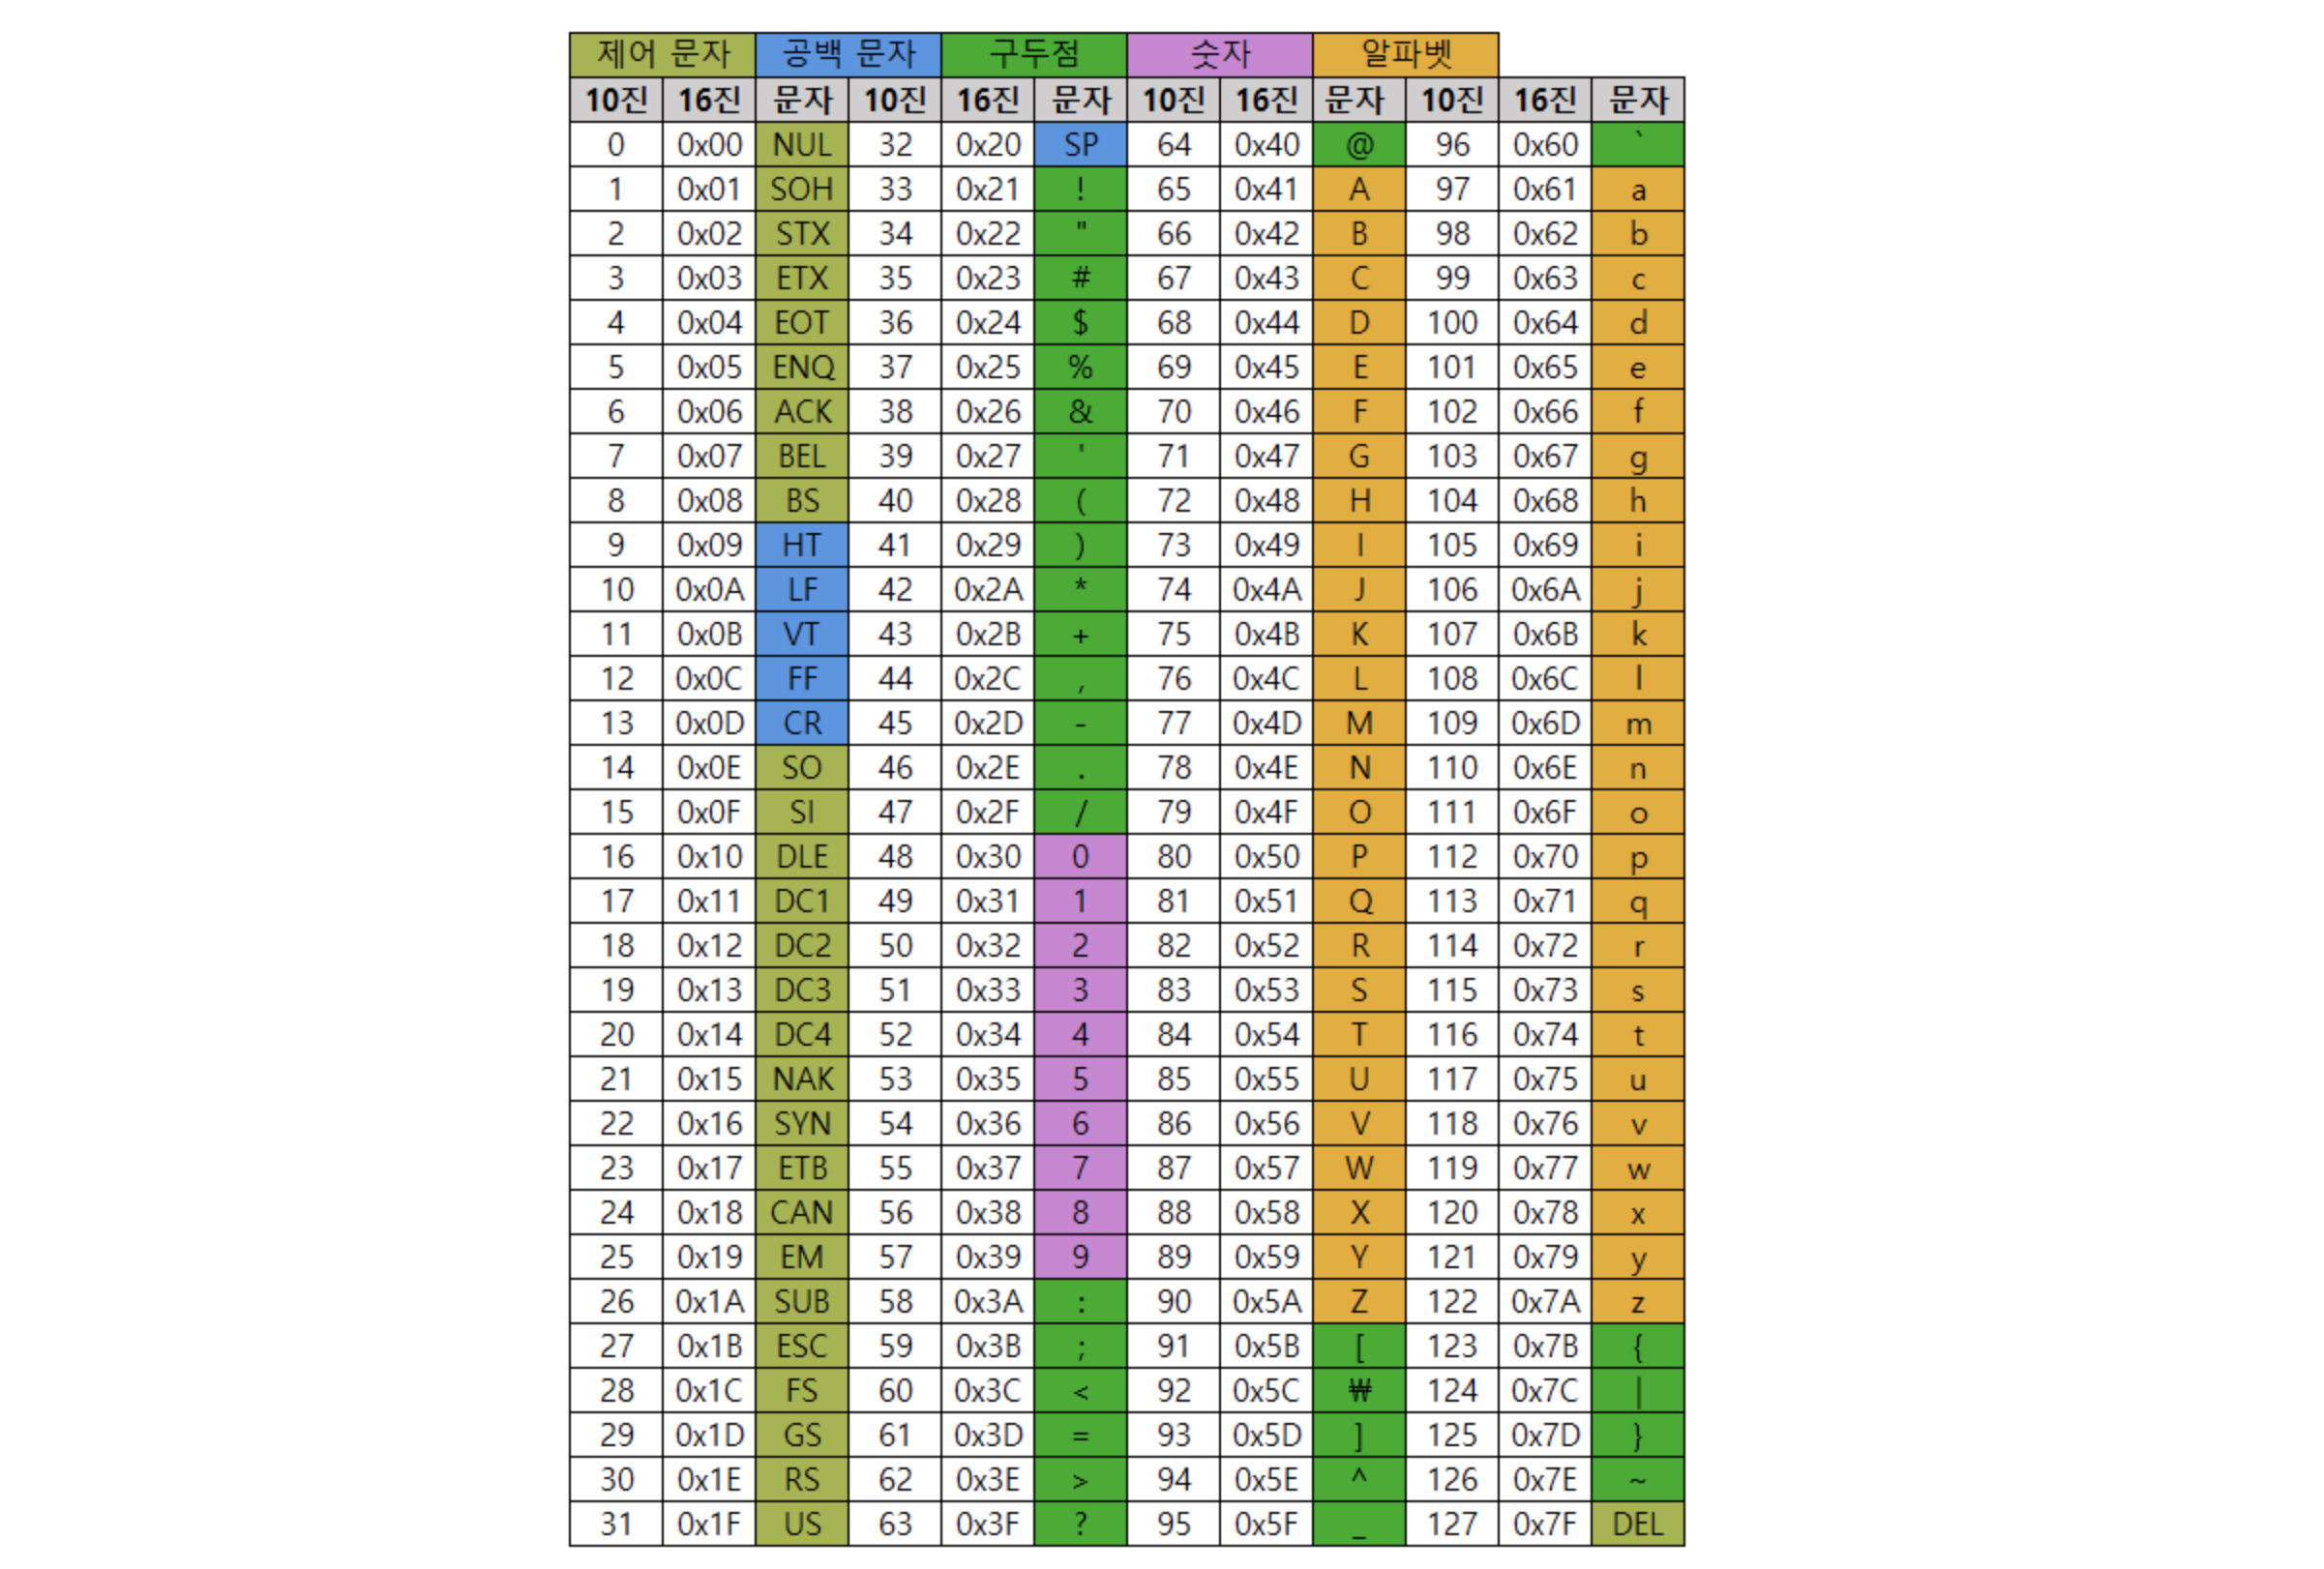
ord()와 chr()는 Python의 내장 함수로, 각각 문자의 코드값과 코드의 문자값을 의미합니다.
도전 과제 - 등장하는 알파벳 개수를 세어 dict으로 만들어보기
다음과 같은 문자열이 있다고 해봅시다.
word = 'Alice in wonderland'Step 1. 먼저 알파벳 형태를 통일하기 위해 문자열을 모두 소문자로 만듭니다.
word_lower = word.lower()Step 2. 딕셔너리 컴프리헨션과 count() 함수를 통해 각각의 알파벳을 계수합니다.
result = {ch: word_lower.count(ch) for ch in set(word_lower) if ch.isalpha()}