분석 목표
국민연금공단 국민연금 가입 사업장 내역 데이터를 분석해
월별 탈퇴 기업, 시도별 탈퇴 기업, 상하반기 탈퇴 기업 알아봅니다.
특정 회사명을 입력하면 다음과 같은 데이터를 출력합니다.
- 회사명을 기준으로 간단한 정보 출력하기
- 회사에 근무하신 직원들의 평균 월급여 추정액, 연봉추정액, 가입자 수 출력하기
- 동종 업종 대비 평균 업종의 차이 출력하기
- 동종 업계는 얼마 정도 받는지 출력하기
세부 설정
다음과 같은 라이브러리를 임포트합니다.
import os
import warnings
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
판다스에서 실수값을 소수점 이하 1자리까지 표시하는 옵션입니다.
pd.set_option('display.float_format', '{:.1f}'.format)판다스에서 DataFrame 출력할 때 보여줄 수 있는 최대 컬럼 수를 설정하며, None일 경우 모든 컬럼을 출력합니다.
pd.set_option('display.max_columns', None)한글 폰트를 설정하는 옵션입니다.
import matplotlib.font_manager as fm

NanumBarunGothic_path = './fonts/NanumBarunGothic.ttf'
fm.fontManager.addfont(NanumBarunGothic_path)

plt.rc('font', family='NanumBarunGothic')
데이터 준비하기
공공 데이터 포털(data.go.kr)에서 csv 파일을 다운로드합니다.
https://www.data.go.kr/data/15083277/fileData.do
그리고, 먼저 메인 폴더 path를 마운트합니다.
base_path = r'C:\Users\haruka\Desktop\AI수업\mcp-month-2\data'그리고 실제 파일 이름을 마운트하고, 데이터를 DataFrame으로 저장합니다.
file_name = '국민연금공단_국민연금 가입 사업장 내역_20260923.csv'
df = pd.read_csv(os.path.join(base_path, file_name), encoding='cp949')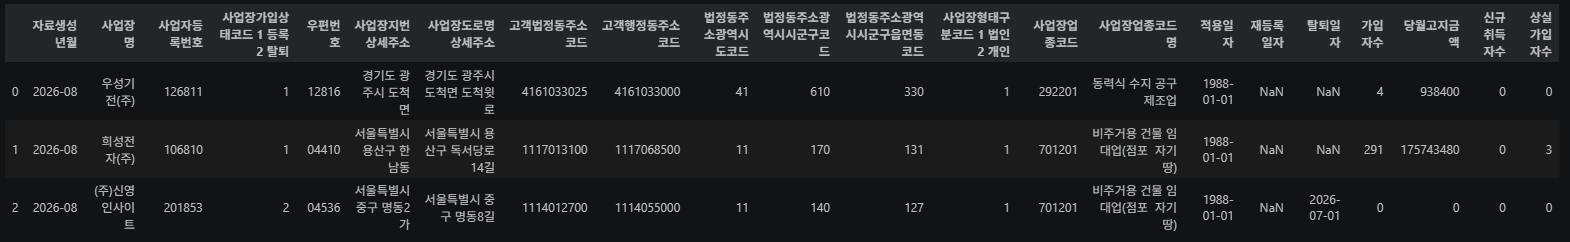
데이터의 row, column 갯수를 살펴봅니다. 총 591,028개의 데이터와 22개의 컬럼이 출력되었습니다.
df.shape # (591028, 22)info()을 통해 데이터 타입들을 확인해보겠습니다. 일부 컬럼들에 NaN 값들이 존재합니다.
df.info()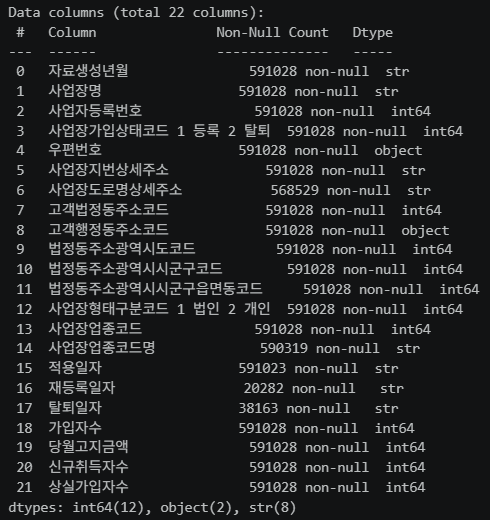
컬럼명 변경하기
다루기 용이한 컬럼명으로 변경합니다.
df.columns = [
    '자료생성년월',
    '사업장명',
    '사업자등록번호',
    '가입상태',
    '우편번호',
    '사업장지번상세주소',
    '주소',
    '고객법정동주소코드',
    '고객행정동주소코드',
    '시도코드',
    '시군구코드',
    '읍면동코드',
    '사업장형태구분코드 1 법인 2 개인',
    '업종코드',
    '업종코드명',
    '적용일자',
    '재등록일자',
    '탈퇴일자',
    '가입자수',
    '금액',
    '신규',
    '상실'
]
필요없는 8개의 컬럼은 삭제합니다.
df.drop([
  '자료생성년월',
  '우편번호',
  '사업장지번상세주소',
  '고객법정동주소코드',
  '고객행정동주소코드',
  '사업장형태구분코드 1 법인 2 개인',
  '적용일자',
  '재등록일자'
], inplace=True, axis=1)
실제로 컬럼이 삭제되었는지 row, column을 확인해봅니다.
df.shape # (591028, 14)결측치 처리하기
특정 컬럼에 대해서만, dropna()를 하도록하겠습니다.
분석에 꼭 필요한 사업장명, 사업자등록번호, 시도코드 컬럼에서의 NaN이 있는 행은 삭제합니다.
df.dropna(subset=['사업장명', '사업자등록번호', '시도코드'], inplace=True)실제로 shape의 변화는 없는 것으로 보아, 사업장명 / 사업자등록번호 / 시도코드의 결측치는 없습니다.
df.shape # (591028, 14)사업장명 정리하기
사업장명 컬럼의 데이터가 (주)나 [주식회사]가 들어간 문자열은 제거합니다.
또 숫자, 한글, 영어를 제외한 특수문자는 공백으로 대체하고, 공백이 1개 이상 들어간 경우 1개로 대체하겠습니다.
먼저 첫번째로, (주)가 들어간 회사명에서 (주)를 제거하겠습니다.
해당 컬럼에 접근하면 Series가 나오는데 추가로 str 속성에 접근하면 StringMethods 객체를 리턴합니다.
df['사업장명'].str # <pandas.core.strings.accessor.StringMethods at 0x23f3c5c06e0>이는 문자열 데이터에서 일괄적으로 적용할 수 있는 문자열 연산을 제공하는 접근자입니다.
즉 Python의 문자열 메서드를 Series 전체에 한번에 적용할 수 있도록 하는 기능을 제공합니다.
우리는 contains()를 사용하여 (주) 문자열이 포함되었는지 검사합니다.
결과적으로 Boolean Mask Series를 리턴합니다.
df['사업장명'].str.contains(r'\(주\)')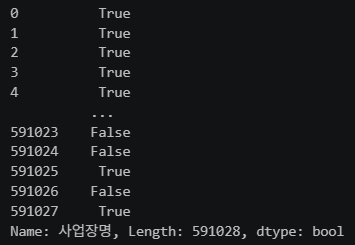
이 Mask Series를 이용해 loc를 통해 Boolean Indexing 합니다.
ju_loc = df.loc[df['사업장명'].str.contains(r'\(주\)')]
이제 정규표현식을 이용해 (주)라는 글자를 제거해보겠습니다. (예시로 첫 데이터만 적용하겠습니다.)
pattern1 = r'(\([^)]+\))'
re.sub(pattern1, '', '우성기전(주)') # '우성기전'
다음 두번째로, []가 들어간 회사명에서 []를 제거하겠습니다.
bracket_loc = df.loc[df['사업장명'].str.contains(r'\[')]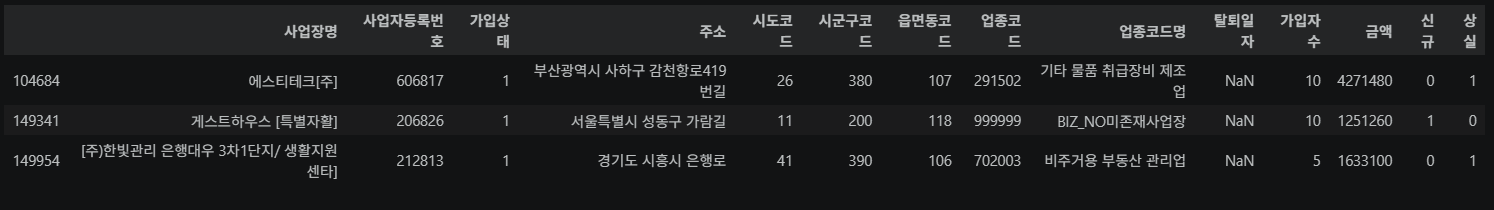
이제 정규표현식을 이용해 [ ] 안의 회사명 글자를 제거해보겠습니다. (예시로 첫 데이터만 적용하겠습니다.)
pattern2 = r'(\[[^)]+\])'
re.sub(pattern2, '', '에스티테크[주]') # 에스티테크
다음 세번째로 사업장명에 특수문자가 있는 경우를 살펴보겠습니다.
special_loc = df.loc[df['사업장명'].str.contains(r'\/')]
이제 정규 표현식을 이용해 숫자를 알파벳, 숫자, 한글 제외한 특수문자를 제거합니다. (예시로 예시 데이터만 적용합니다.)
pattern3 = '[^A-Za-z0-9가-힣]'
result = re.sub(pattern3, ' ', '*&&^%의료법인%해정') # '     의료법인 해정'
그리고, 공백 여러개는 1개로 바꿉니다.
result = re.sub(' +', ' ', result).strip() # '의료법인 해정'최종적으로 전처리 되기 이전 데이터는 다음과 같습니다.
df.loc[[0, 112863, 718]]
이제 위 내용을 기반으로 전처리하는 함수를 만들겠습니다.
def preprocessing(x):
  x = re.sub(pattern1, '', x)
  x = re.sub(pattern2, '', x)
  x = re.sub(pattern3, ' ', x)
  x = re.sub(' +', ' ', x)
  return x.strip()
최종적으로 사업장명 컬럼에 대해 함수를 apply하면 됩니다.
df['사업장명'] = df['사업장명'].apply(preprocessing)그리고 전처리 이후 내용은 다음과 같습니다.
df.loc[[0, 112863, 718]]
분석하기
분석년도 2025년으로 준비합니다.
year = 2025가입상태가 1인 기업들만 필터링하는 마스크를 준비합니다.
join_mask = df['가입상태'] == 1가입상태가 2인 데이터는 삭제하고, 가입일자와 탈퇴일자 컬럼은 제거하겠습니다.
df = df.loc[join_mask].drop(['가입상태', '탈퇴일자'], axis=1).reset_index(drop=True)
df.head()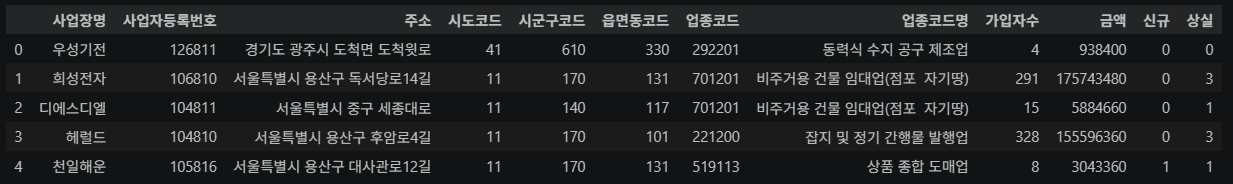
이제 국민연금납부액으로 기업별 평균 연봉을 역추정해보겠습니다.
국민연금 보험률은 9%인데, 쉽게 이야기해서 급여의 9%를 국민연금으로 내는 것입니다.
이 중 4.5%는 회사가, 나머지 4.5%는 개인이 부담하는 구조입니다.
국민연금 보험료는 소득 상한선과 하한선이 설정되어 있어 소득 전체가 아닌 일부 소득에만 부과됩니다.
따라서 국민연금납부액만으로 기업별 평균 연봉을 역추산하는 것은 한계가 있습니다.
상한선과 하한선이 있어 실제보다 과소계산될 수 있습니다.
월급여추정은 **인당금액 / 9% * 100%**으로 계산할 수 있습니다.
이에 따라, 파생변수인 인당 금액, 월급여추정, 연간급여추정을 추가해보겠습니다.
인당금액은 금액을 가입자수로 나눈 값입니다.
df['인당금액'] = df['금액'] / df['가입자수']월급여추정은 인당금액을 9%로 나누고 100%를 곱합니다.
df['월급여추정'] = df['인당금액'] / 9 * 100연간급여추정은 월급여추정에 12를 곱합니다.
df['연간급여추정'] = df['월급여추정'] * 12최종적으로 다음과 같이 파생변수가 추가됩니다.
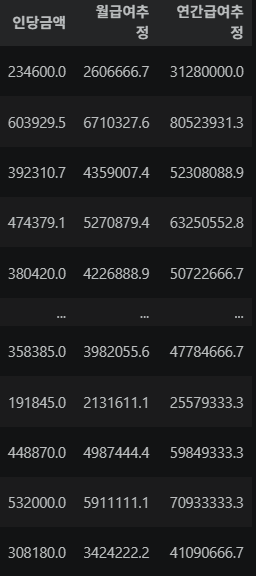
기업을 필터링할 것인데 가입자수를 1000명을 초과하는 기업만 필터링합니다.
단, 연간급여추정 및 가입자수로 내림차순 정렬하고, 사업장명 / 가입자수 / 월급여추정 / 연간급여추정만 출력합니다.
cond = df['가입자수'] > 1000
df.sort_values(['연간급여추정', '가입자수'], ascending=False)\
  .loc[cond, ['사업장명', '가입자수', '월급여추정', '연간급여추정']]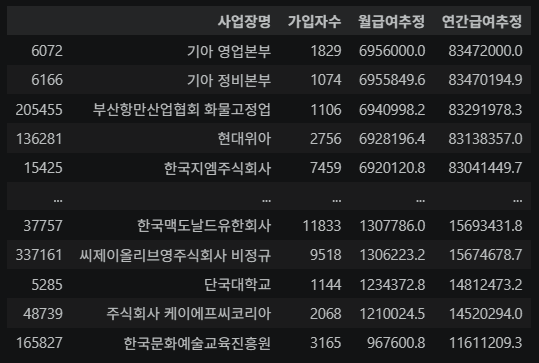
그리고, 사업장명을 검색해 결과를 반환하는 함수를 만드는데, 함수명은 find_company() 입니다.
매개변수로 contains를 추가해 True일 경우 포함하는 모든 회사를 찾고, False일 경우 완벽히 일치하는 회사만 찾습니다.
최종적으로 사업장명 / 월급여추정 / 연간급여추정 / 업종코드를 보여주는 DataFrame을 반환합니다.
def find_company(company_name, contains):
  if contains:
    return df.loc[
      df['사업장명'].str.contains(company_name),
      ['사업장명', '월급여추정', '연간급여추정', '업종코드', '가입자수']
    ].sort_values('가입자수', ascending=False)
  else:
    return df.loc[
      df['사업장명'] == company_name,
      ['사업장명', '월급여추정', '연간급여추정', '업종코드', '가입자수']
    ].sort_values('가입자수', ascending=False)
이 함수대로 에스케이텔레콤이라는 회사를 먼저 일치하는 것만 찾아봅니다.
find_company('에스케이텔레콤', False)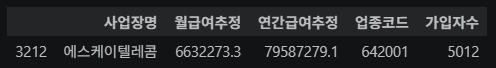
이 함수대로 에스케이텔레콤이라는 회사를 포함시키는 것까지 찾아봅니다.
find_company('에스케이텔레콤', True)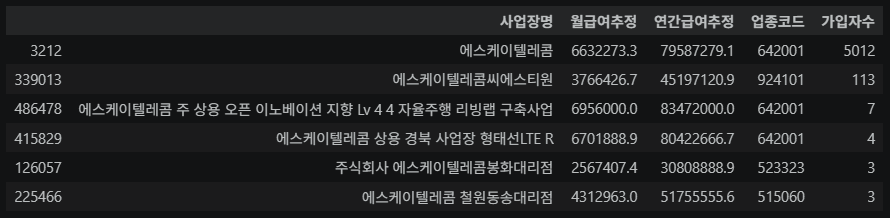
그리고 마지막으로 업종코드가 동일한 회사를 비교해보겠습니다.
먼저 회사의 기본정보를 반환하는 함수인 company_info() 함수를 만듭니다.
def company_info(company_name):
  company = find_company(company_name, True)
  return df.loc[company.iloc[0].name] # 검색된 company중 가입자수가 많은 회사 1개
그리고, 주어진 사업장과 업종코드가 동일한 회사를 비교하는 compare_company() 함수를 만듭니다.
최종적으로 월급여추정과 연간급여추정의 평균, 총 개수, 최소값, 최대값을 보여줍니다.
def compare_company(company_name):
  company = find_company(company_name, True)
  code = company['업종코드'].iloc[0]
  df1 = df.loc[df['업종코드'] == code, ['월급여추정', '연간급여추정']]\
          .agg(['mean', 'count', 'min', 'max'])
  df1.columns = ['업종_월급여추정', '업종_연간급여추정']
  df1 = df1.T
  df1.columns = ['평균', '개수', '최소', '최대']
  df1.loc['업종_월급여추정', company_name] = company['월급여추정'].values[0]
  df1.loc['업종_연간급여추정', company_name] = company['연간급여추정'].values[0]
return df1삼성전자를 예시로 들겠습니다.
compare_company('삼성전자')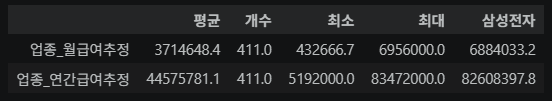
Streamlit 활용한 앱 개발
위에서 분석한 내용을 토대로 웹 어플리케이션 배포를 합니다.
먼저 배포를 위해서 Github에 PyNps_MCP2607 이라는 이름으로 Repository를 만듭니다.
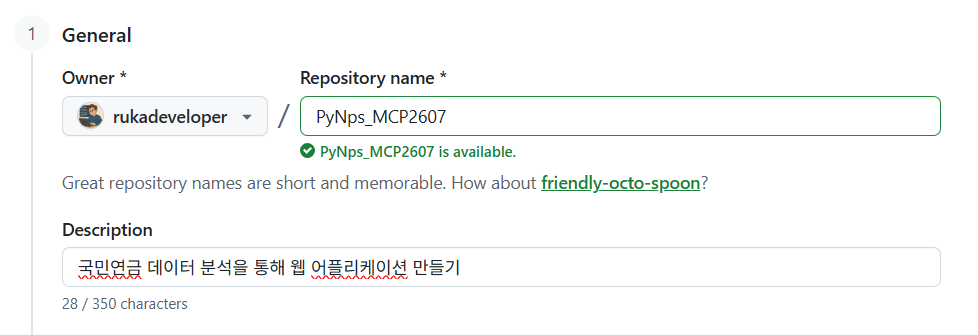
그리고 streamlit_main.py 라는 파일을 하나 만듭니다.
import os
import warnings
import numpy as np
import matplotlib
import matplotlib.pyplot as plt
from matplotlib import font_manager as fm, rc
import platform
import seaborn as sns
import re
import streamlit as st

# 한글 폰트 설정
try:
  if platform.system() == 'Windows':
    font_name = font_manager.FontProperties(fname="c:/Windows/Fonts/malgun.ttf").get_name()
    rc('font', family=font_name)
  else:
    rc('font', family='AppleGothic')
except:
  pass

matplotlib.rcParams['axes.unicode_minus'] = False # 마이너스 기호 깨짐 방지
그리고, 웹 애플리케이션의 제목으로 국민연금 데이터 분석이 표시되게 합니다.
st.title("국민연금 데이터 분석")여기까지 하고, 커밋하여 저장합니다.
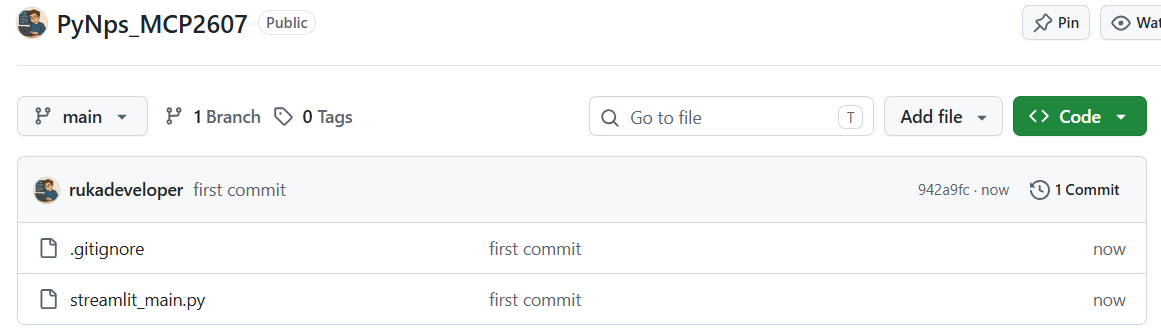
배포를 위해 Streamlit Cloud 홈페이지로 접속합니다.
Streamlit Community Cloud • StreamlitDeploy, manage, and share your Streamlit apps — all for free.streamlit.io
접속하고 아래를 선택합니다.
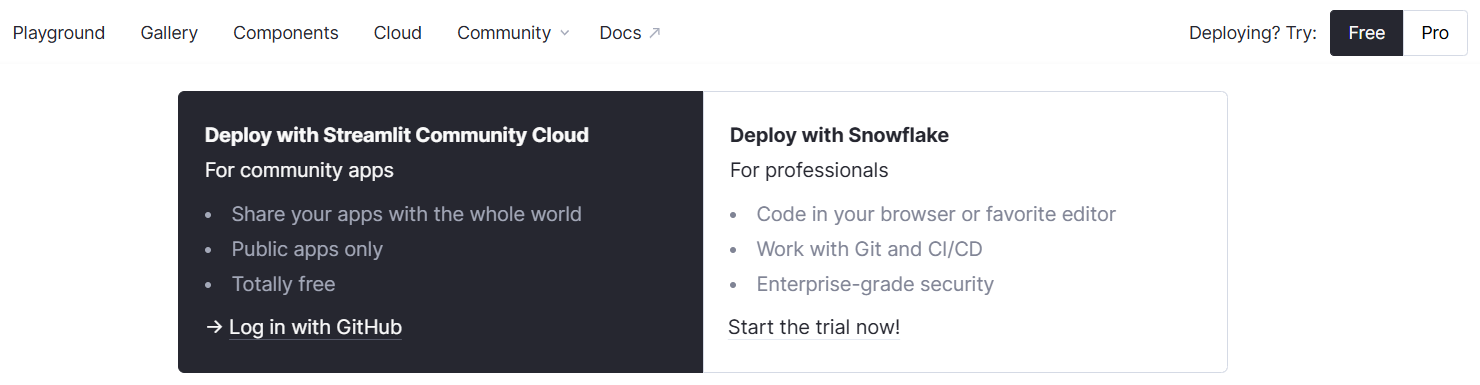
Github으로 로그인한 후, Create app을 누릅니다.

Github 계정을 연동한 후 아래를 누릅니다.
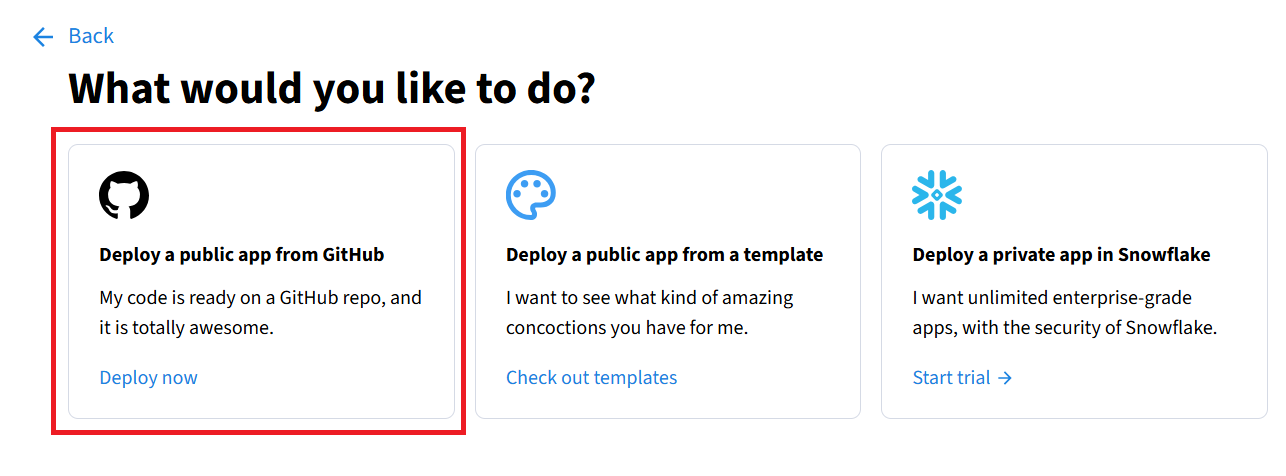
그리고, 여러가지 사항을 선택하고 Deploy를 누릅니다.
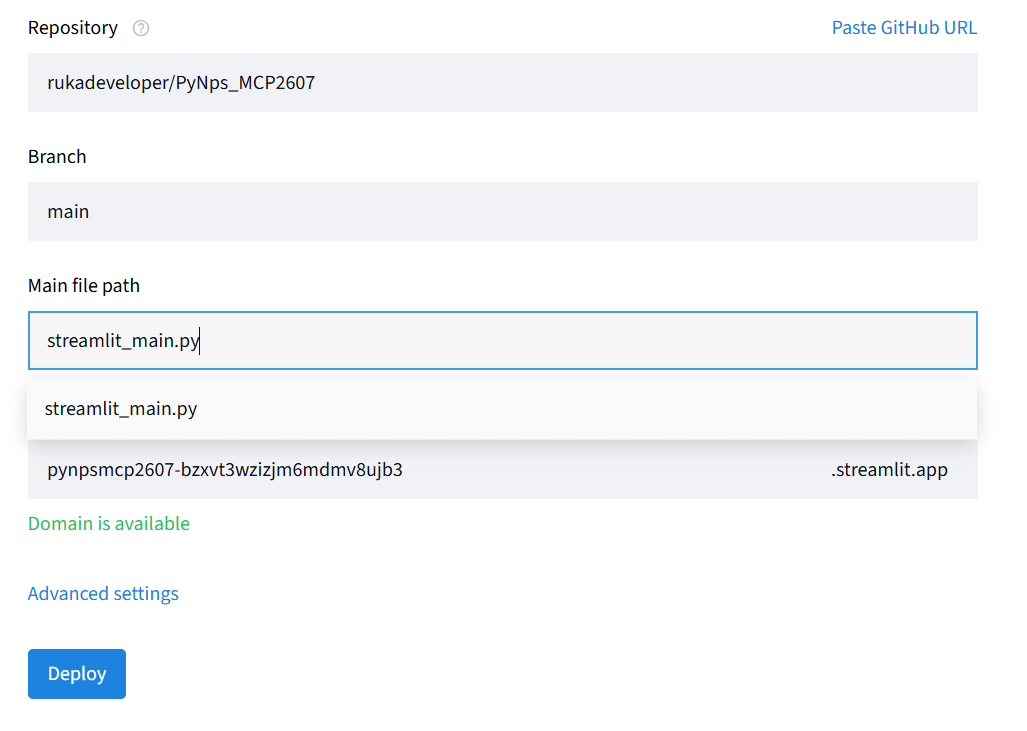
그러면 최종 배포링크가 생깁니다.
추가로, 국민연금 데이터를 다룰 클래스를 생성하며, 전처리를 할 생성자를 만듭니다.
class PensionData():
  def __init__(self, filePath):
    warnings.simplefilter(action='ignore', category=pd.errors.DtypeWarning)
    self.df = pd.read_csv(os.path.join(filePath), encoding='cp949')
    self.pattern1 = r'(\([^)]+\))'
    self.pattern2 = r'(\[[^)]+\])'
    self.pattern3 = r'[^A-Za-z0-9가-힣]'
    self.preprocess()

  def preprocess(self):

    # 사업자업종코드 컬럼값이 빈 문자열인 것들은 제거
    mask = self.df['사업장업종코드'].replace({r'^\s+$': pd.NA}, regex=True).isna()
    self.df = self.df[~mask]
    self.df['사업장업종코드'] = self.df['사업장업종코드'].astype('int32')

    # 컬럼명들 재정의
    self.df.columns = [
      "자료생성년월", "사업장명", "사업자등록번호", "가입상태", "우편번호",
      "사업장지번상세주소", "주소", "고객법정주소코드", "고객행정주소코드",
      "시도코드", "시군구코드", "읍면동코드",
      "사업장형태구분코드 1 법인 2 개인", "업종코드", "업종코드명",
      "적용일자", "재등록일자", "탈퇴일자",
      "가입자수", "금액", "신규", "상실"
    ]

    # 불필요한 컬럼 제거
    df = self.df.drop([
      '자료생성년월', '우편번호', '사업장지번상세주소', '고객법정동주소코드',
      '고객행정동주소코드', '사업장형태구분코드 1 법인 2 개인', '적용일자',
      '재등록일자'
    ], axis=1)

    # 사업장명 cleasing
    df['사업장명'] = df['사업장명'].apply(self.preprocessing)

    # 탈퇴일자_연도, 탈퇴일자_월 추가
    df['탈퇴일자_연도'] = pd.to_datetime(df['탈퇴일자']).dt.year
    df['탈퇴일자_월'] = pd.to_datetime(df['탈퇴일자']).dt.month

    # 주소 컬럼에서 시도 부분만 새 컬럼으로 추가
    df['시도'] = df['주소'].str.split(' ').str[0]

    # 탈퇴한 기업들은 drop
    df = df.loc[df['가입상태'] == 1].drop(['가입상태', '탈퇴일자'], axis=1)\
           .reset_index(drop=True)

    # 분석하고자 하는 컬럼 추가
    df['인당금액'] = df['금액'] / df['가입자수']
    df['월급여추정'] = df['인당금액'] / 9 * 100
    df['연간급여추정'] = df['월급여추정'] * 12

    # 원본변경
    self.df = df

  def preprocessing(self, x):
    x = re.sub(self.pattern1, '', x)
    x = re.sub(self.pattern2, '', x)
    x = re.sub(self.pattern3, ' ', x)
    x = re.sub(' +', ' ', x)
    return x.strip()

  # 주어진 company_name으로 검색하기
  def find_company(self, company_name):
    # 가입자가 많은 순으로 정렬하여 return
    return self.df.loc[
      self.df['사업장명'].str.contains(company_name),
      ['사업장명', '월급여추정', '연간급여추정', '업종코드', '가입자수']
    ].sort_values('가입자수', ascending=False)

  # 동종업계 정보(월급여추정액, 연간급여추정액) 비교
  def compare_company(self, company_name):
    company = self.find_company(company_name)
    code = company['업종코드'].iloc[0]
    df1 = self.df.loc[
      self.df['업종코드'] == code,
      ['월급여추정', '연간급여추정'].agg(['mean', 'count', 'min', 'max'])
    ]
    df1.columns = ['업종_월급여추정', '업종_연간급여추정']
    df1 = df1.T
    df1.columns = ['평균', '개수', '최소', '최대']
    df1.loc['업종_월급여추정', company_name] = company['월급여추정'].values[0]
    df1.loc['업종_연간급여추정', company_name] = company['연간급여추정'].values[0]
    return df1

  # 검색 기업 정보 출력
  def company_info(self, company_name):
    company = self.find_company(company_name)
    return self.df.loc[company.iloc[0].name]

  def get_data(self):
    return self.df
그리고 적용할 filePath를 가져옵니다.
file_path = r'https://drive.google.com/file/d/1kO8ojcPxzC_qEM1mQtp1LIEmOVsvJ688/view?usp=drive_link'이제 데이터를 읽어오는 함수를 작성합니다.
@st.cache_resource # 동일 함수 반복 호출되면 매번 실행하지 않고, 마지막으로 실행된 결과 리턴
def read_pensiondata():
  data = PensionData(file_path)
  return data
읽어온 데이터를 data 변수에 저장합니다.
data = read_pensiondata()회사를 입력하는 input 디자인을 만듭니다.
company_name = st.text_input("회사명을 입력해주세요", placeholder="검색할 회사명 입력")검색하면, 받아줄 UI를 작성합니다.
if data and company_name:
  output = data.find_company(company_name=company_name)
  if len(output) > 0:
    st.subheader(output.iloc[0]['사업장명'])

    info = data.company_info(company_name=company_name)

    st.markdown(
      f"""
      - `{info['주소']}`
      - 업종코드명 `{info['업종코드명']}`
      - 총 근무자 `{int(info['가입자수']):,}`
      - 신규 입사자 `{info['신규']:,}`
      - 퇴사자 `{info['상실']:,}`
      """
    )

    col1, col2, col3 = st.columns(3)

    col1.text('월급여추정')
    col1.markdown(f"`{int(output.iloc[0]['월급여추정']):,}` 원")

    col2.text('연봉 추정')
    col2.markdown(f"`{int(output.iloc[0]['연간급여추정']):,}` 원")

    col3.text('가입자수 추정')
    col3.markdown(f"`{int(output.iloc[0]['가입자수']):,}` 원")

    comp_output = data.compare_company(company_name=company_name)
    st.dataframe(comp_output.round(0), use_container_width=True)

    st.markdown(f'### 업종 평균 vs {company_name} 비교')

    # 검색은 회사의 월급여추정액과 업종평균을 비교
    percent_value = info['월급여추정'] / comp_output.iloc[0, 0] * 100 - 100
    diff_month = abs(comp_output.iloc[0, 0] - info['월급여추정'])
    diff_year = abs(comp_output.iloc[1, 0] - info['연간급여추정'])
    upordown = '높은' if percent_value > 0 else '낮은'

    st.markdown(
      f'''
      - 업종 **평균 월급여**는 `{int(comp_output.iloc[0, 0]):,} 원입니다.
      - 업종 **평균 연봉**은 `{int(comp_output.iloc[1, 0]):,}` 원입니다.
      - `{company_name}` 은 평균보다 `{int(diff_month):,}원 그리고
      약 :red[약 {percent_value:.2f} %] `{upordown}`
      `{int(info['월급여추정']):,}` 원을 **월 평균 급여**를 받는 것으로 추정됩니다.
      - `{company_name}`은 평균보다 `{int(diff_year):,} 원 그리고 `{upordown}`
      `{int(info['연간급여추정']):,} 원을 **연봉**을 받는 것으로 추정됩니다.
      '''
    )

    fig, ax = plt.subplots(1, 2)

    p1 = ax[0].bar(
      x=['Average', 'Your Company'],
      height=(comp_output.iloc[0, 0], info['월급여추정']),
      width=0.7
    )
    ax[0].bar_label(p1, fmt='%d')
    p1[0].set_color('black')
    p1[1].set_color('red')
    ax[0].set_title('Monthly Salary')

    p2 = ax[1].bar(
      x=['Average', 'Your Company'],
      height=(comp_output.iloc[1, 0], info['연간급여추정']),
      width=0.7
    )
    p2[0].set_color('black')
    p2[1].set_color('red')
    ax[1].bar_label(p2, fmt='%d')
    ax[1].set_title('Yearly Salary')

    ax[0].tick_params(axis='both', which='major', labelsize=8, rotation=0)
    ax[0].tick_params(axis='both', which='minor', labelsize=6)
    ax[1].tick_params(axis='both', which='major', labelsize=8)
    ax[1].tick_params(axis='both', which='minor', labelsize=6)

    st.pyplot(fig)

    st.markdown('### 동종업계')
    df = data.get_data()
    st.dataframe(
      df.loc[
        df['업종코드'] == info['업종코드'],
        ['사업장명', '월급여추정', '연간급여추정', '가입자수']
      ].sort_values('연간급여추정', ascending=False).head(10).round(0),
      use_container_width=True
    )
  else:
    st.subheader('검색결과가 없습니다')
최종 결과물은 아래에서 확인 가능합니다.
https://pynpsmcp2607-bzxvt3wzizjm6mdmv8ujb3.streamlit.app/
StreamlitThis app was built in Streamlit! Check it out and visit https://streamlit.io for more awesome community apps. 🎈pynpsmcp2607-bzxvt3wzizjm6mdmv8ujb3.streamlit.app