머신러닝 기초
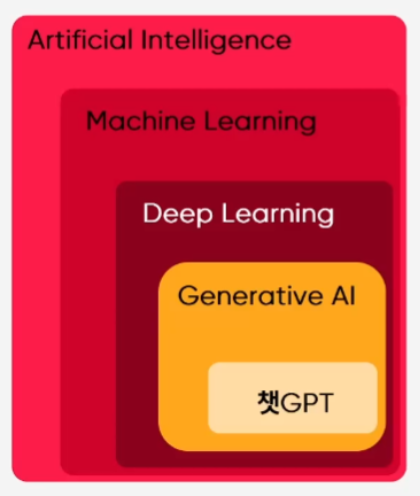
인공지능(Artificial Intelligence)을 구현하는 방법론들은 오래전부터 여러가지 방법론들이 있었습니다.
그 중에서 데이터와 알고리즘을 학습시켜 인공지능을 만드는 방법을 **머신 러닝(Machine Learning)**이라고 부릅니다.
그 다음에 배울 **딥 러닝(Deep Learning)**은 머신 러닝 방법론 중에 하나로써 신경망 네트워크를 통한 학습입니다.
그리고 딥 러닝에 사용하는 수많은 모델들 중에 생성형 모델을 Generative AI라고 부릅니다.
그 생성형 모델 중에 서비스 되는 것중 하나가 ChatGPT, Claude 등입니다.
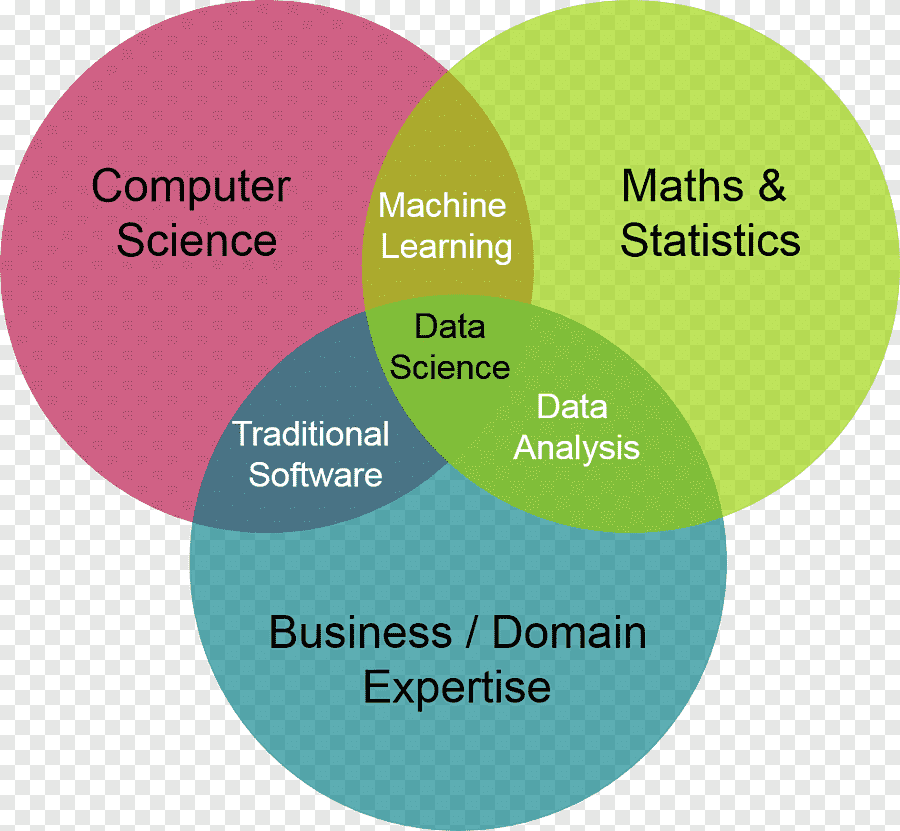
머신러닝을 자세히 살펴보면, 컴퓨터가 데이터를 학습하는 알고리즘과 기술을 통칭하는 것입니다.
머신러닝을 수행함에 있어서는 Computer Science 기술도 필요하고
수학과 통계학(Math & Statistics) 부분도 필요합니다.
머신러닝의 최종 목표는 현상을 설명하거나 미래를 예측하는 용도로 활용됩니다.
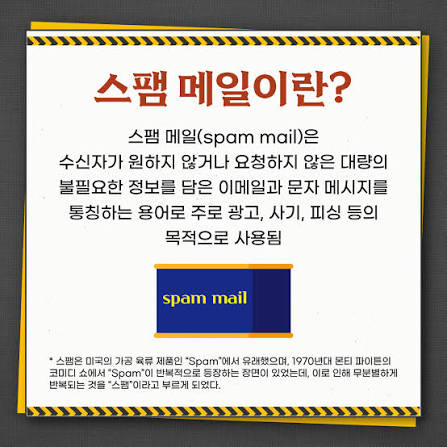
머신러닝을 비유적으로 설명하기 위해 스팸 메일을 예시로 설명하겠습니다.
스팸 메일 분류기로는 다음 3가지 방법이 있습니다.
- 사람이 직접 수행하는 스팸 필터링
- 규칙 기반의 스팸 필터링
- 머신 러닝 기반의 스팸 필터링
첫번째, 사람이 직접 수행하는 스팸 필터링입니다.
메일이 있다면, 스팸 메일 분류 전문가들이 이 메일을 읽어보고, 스팸인지 스팸이 아닌지를 분류합니다.
이런 방법으로는 굉장히 정확하게 분류를 해낼 수 있지만, 그러나 현실적으로 이 방식은 불가능합니다.
그래서 컴퓨터가 분류할 수 있도록 해야합니다.
두번째, 스팸을 분류하는 규칙을 만들어서 모델을 생성하는 방법입니다.
여러가지 규칙들을 만드는데, 예를 들어 특정 단어를 포함하는 경우라던지 같은 규칙들을 만듭니다.
결론적으로 스팸 메일 전문가들이 규칙들을 알고리즘화하여 이 알고리즘을 탑재한 모델을 스팸 분류기로 사용합니다.
이 스팸 메일 분류기는 메일이 올 때마다 스팸 메일을 자동으로 분류해주는 역할을 합니다.
그러나 이 방식에도 문제가 있습니다.
첫번째는 전문가들의 지식을 빈틈없이 규칙 집합으로 표현 가능한지 의문이 생깁니다.
두번째는 스팸 메일 진화에 따른 새로운 지식의 업데이트는 용이한지 의문이 생깁니다.
이로써 세번째, 머신러닝을 이용해 스팸 메일을 필터링하는 방법입니다.
머신 러닝을 통한 방법은 과거의 데이터를 학습을 하여, 기존의 축적된 메일들을 데이터 공간에 표현하고
이 데이터 공간 상의 분류 경계를 찾아냅니다. 그 경계선은 직선일수도 곡선일수도 있습니다.
나중에 새로운 데이터가 들어와도 추가된 데이터로 학습하여 예측할 수 있는 것입니다.
즉, 규칙 기반 알고리즘에 비해 여러 인자를 동시에 고려하며 스팸을 분류할 수 있습니다.
또, 새로운 유형의 스팸도 분류할 것을 기대하게 됩니다.
하지만, 단점 또한 있는데 많은 양의 데이터(빅데이터)가 필요하고, 더 많은 계산(컴퓨팅)이 필요합니다.
그러나 최근 생태계는 빅데이터가 축적되었고, 하드웨어 성능도 올라갔으며, 좋은 알고리즘이 많이 등장했습니다.
머신러닝의 여러가지 유형
첫번째는 지도 학습(Supervised Learning) 입니다.
모델이 입력할 데이터(X)와 타겟값 / 레이블 (y)를 알고 있는 데이터를 학습하여 모델링하는 방법입니다.
최종적으로 새로운 데이터에 대한 타겟값을 예측하는 데에 사용됩니다.
지도 학습은 y 값의 형태에 따라 분류 문제(Classification)인지 회귀 문제(Regression)인지 나뉩니다.
분류 문제는 y값이 이산형 변수, 특정한 값만 가질 수 있는 변수일 경우 분류형 문제입니다.
분류 문제의 예시로는 스팸 메일 분류, 개와 고양이 분류, 얼굴 인식 등이 있을 수 있습니다.
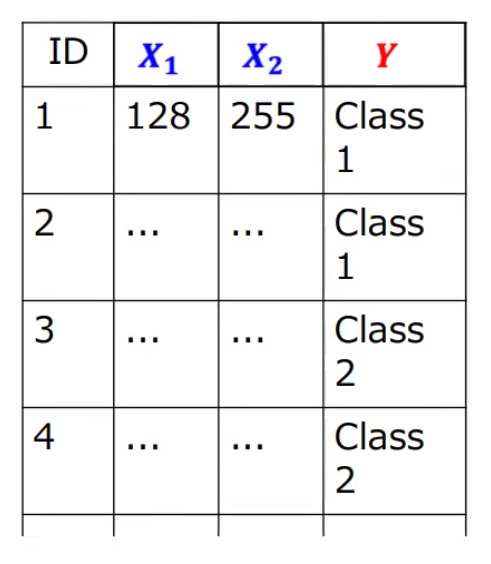
예를 들어 다음과 같은 2차원 데이터를 입력 데이터로 하는 경우가 있다고 가정해봅시다.
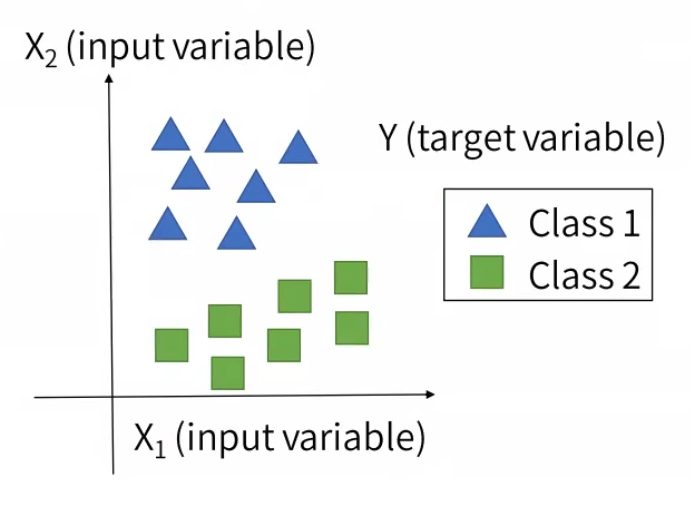
또한 이를 2차원 상(x,y축) 데이터 공간에 표현하면 다음과 같습니다.
분류의 최종 목표는 이들을 가를 수 있는 Decision Boundary를 찾는 것입니다.
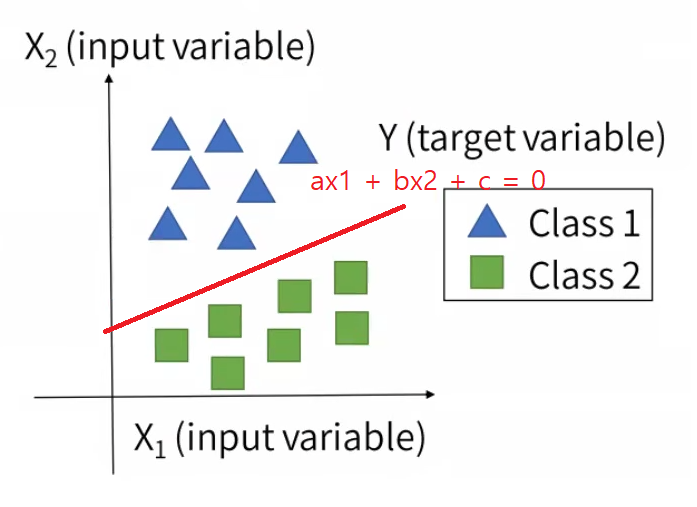
이 방정식을 사용하는 A 모델은 어떤 새로운 값이 관측이 되었을 때
Class 1에 해당하는지, Class 2에 해당하는지 분류할 수 있게 됩니다.
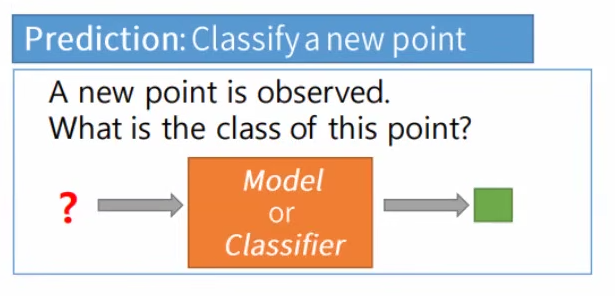
회귀 문제는 y값이 연속형 변수, 연속 범위 내에서 임의의 값을 가질 수 있는 변수일 경우 회귀 문제입니다.
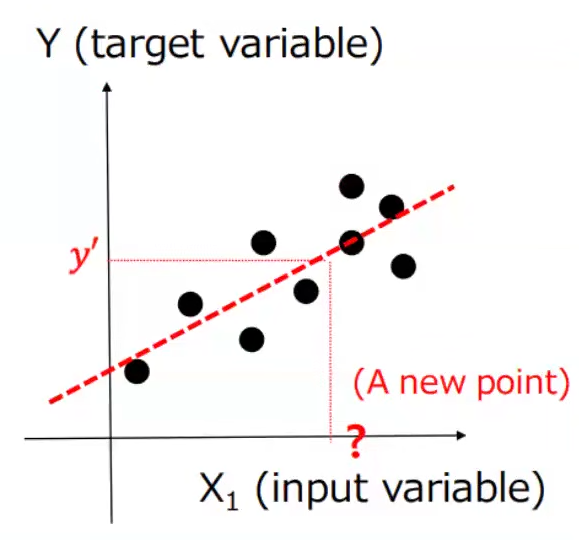
예를 들어 X가 1차원 데이터가 그에 따른 y값이 임의의 값이라고 해보겠습니다.
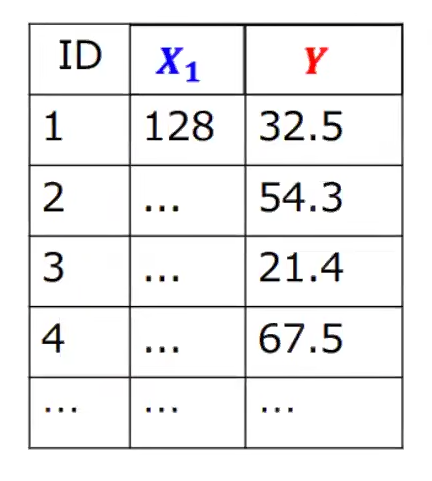
이것을 x축을 input 변수로, y축을 target 변수로 하는 데이터 공간에 함께 펼칩니다.
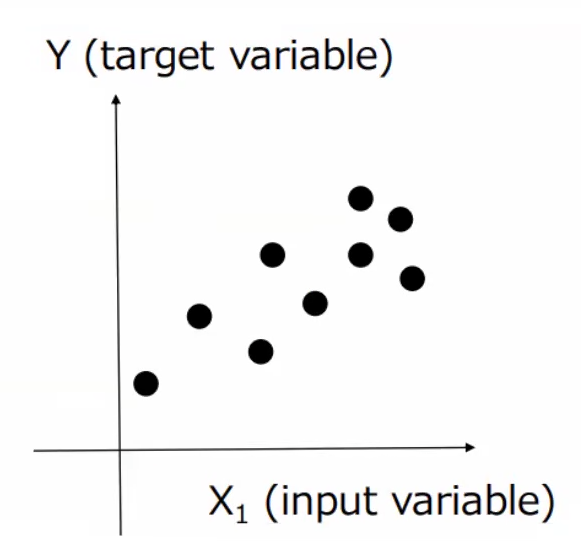
최종 목표는 이 데이터를 표현하는 가장 최적화된 Regression Line을 찾는 것입니다.
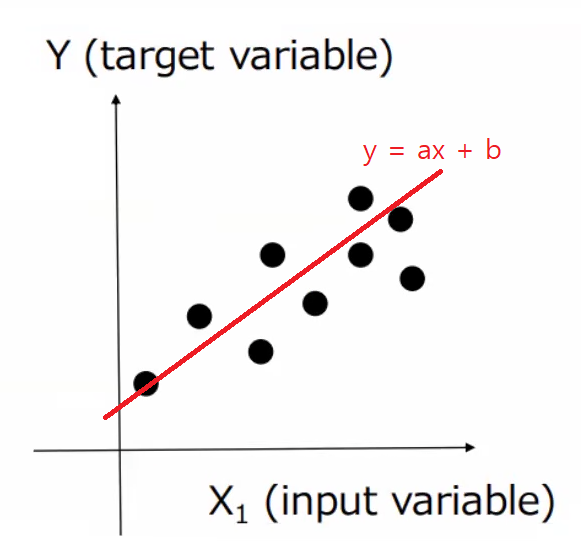
예측하는 방법은 새로운 X값이 들어왔을 때 방정식 모델을 통해 새로운 Y 값을 예측하는 것입니다.
두번째는 비지도학습(Unsupervised Learning)입니다.
지도학습과는 달리 타겟값(y)이 없는 학습입니다. 입력값(X)만을 학습하는 방법입니다.
입력 데이터에 내재되어 있는 특성을 찾아 답을 찾아내는 용도입니다.
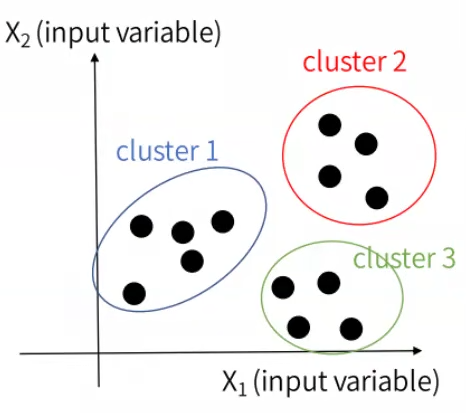
첫번째 예시로는 **군집화(Clustering)**가 있습니다. 유사한 포인트끼리 그룹을 만드는 방법입니다.
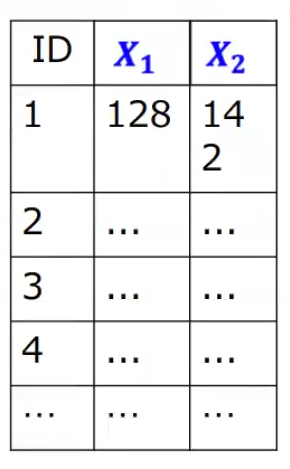
입력 데이터가 다음과 같다고 해봅시다.
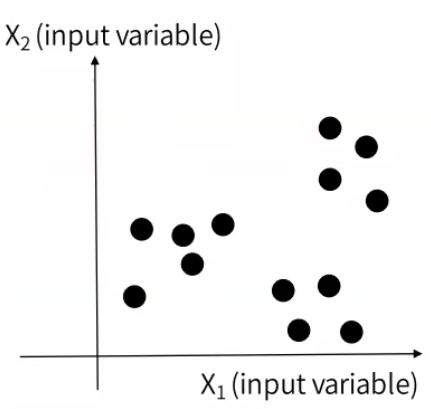
이것을 2차원 데이터 공간에 표현하면 아래와 같습니다.
그리고 이것을 유사한 클러스터(포인트)끼리 묶는 방식입니다.
두번째 예시로는 잠재 변수 모델(Latent Variable Model) 입니다.
표현된 데이터 속에 내재되어 있는 잠재변수를 찾는 것입니다.
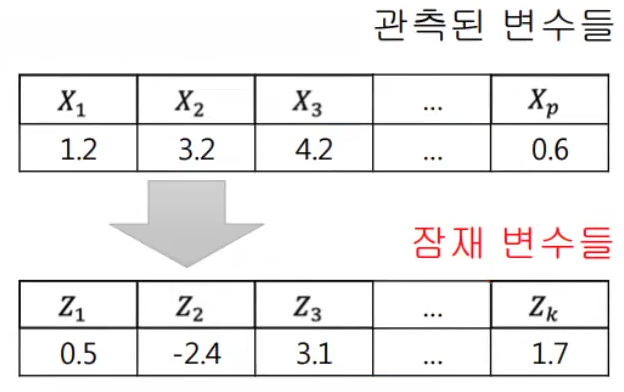
종류로는 주성분 분석(PCA), 특이값 분해(SVD), 비음수 행렬 분해(NMF), 잠재 디리슐레 할당(LDA) 등이 있습니다.
세번째 예시로는 밀도 추정(Density Estimation) 입니다.
관측된 데이터를 이용해 데이터 생성에 대한 확률밀도함수를 추정합니다.
네번째 예시로는 이상치 탐지(Novelty Dectection) 입니다.
다른 포인트들과 비교해 많이 벗어나있는 포인트를 찾아냅니다.
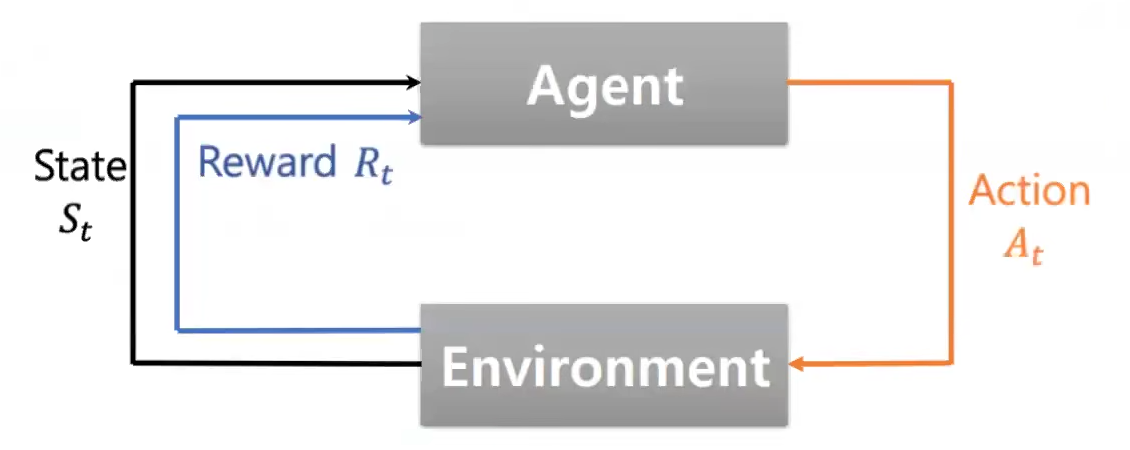
세번째 학습은 강화학습(Reinforcement Learning) 입니다. 자신이 한 행동에 대한 보상을 바탕으로 목적을 달성합니다.
어떤 액션(Action)이 있을 때 이 액션에 대한 보상(Reward)을 바탕으로 반복해 나가는 과정입니다.