주성분 분석(PCA)
주성분 분석(PCA)는 차원 축소 알고리즘 중에 하나입니다.
우리가 훈련에 사용하는 데이터는 계속해서 증가합니다. 그에 비해 저장 공간은 제한적입니다.
데이터 압축을 해도 군집이나 분류에 영향을 주지 않는 방법을 생각해봅니다. 그것이 차원 축소입니다.
여기서 말하는 차원은 axis 축을 의미하는 것이 아닙니다.
앞서 살펴본 fruits_300.npy 데이터에서는 10000개의 픽셀 즉 10000개의 특성이 있는 셈입니다.
머신 러닝에서는 이러한 특성을 차원(dimension)이라고도 부릅니다.
여기서 차원을 줄일 수 있다면, 저장공간도 크게 절약할 수 있을 것입니다.
차원 축소는 데이터를 잘 나타내는 일부 특성만 선택하는 것입니다. 데이터 크기 줄이고 overfit 억제하는 효과를 얻습니다.
줄어든 차원에서 최소 손실로 원래 차원으로 복구할 수도 있습니다.
이러한 차원 축소 알고리즘 중 대표적인 것이 주성분 분석(PCA) 입니다.
주성분 분석은 데이터에 있는 분산이 큰 방향을 찾는 것입니다.
분산이 큰 방향은 데이터를 잘 표현하는 어떤 벡터입니다.
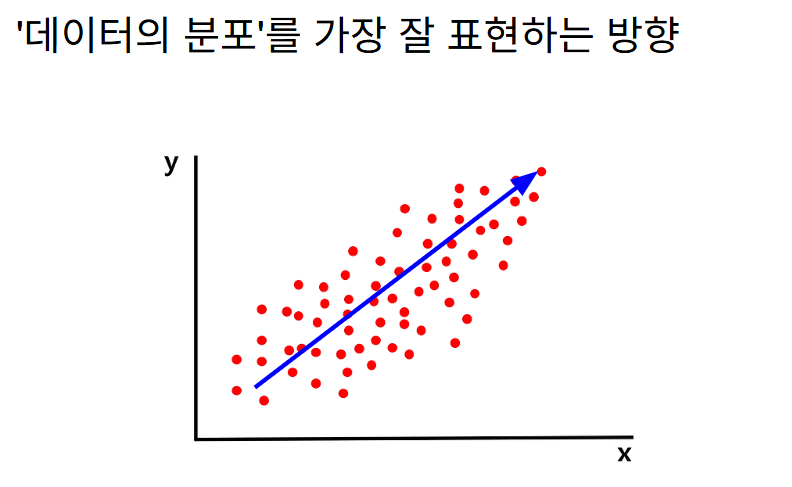
이 주성분 벡터의 원소의 개수는 데이터의 특성의 개수와 같습니다.
차원 축소 방법은 가령 모든 샘플들을 주성분에 지표화할 수 있도록 투영화합니다.
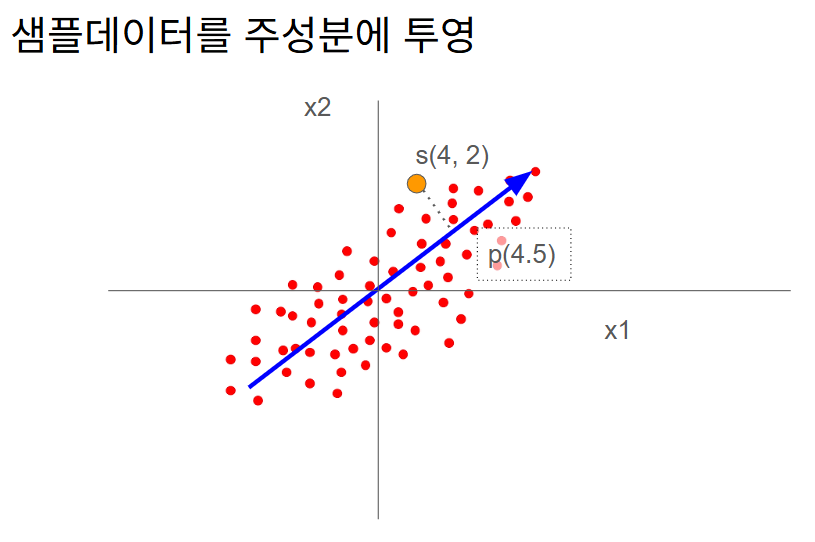
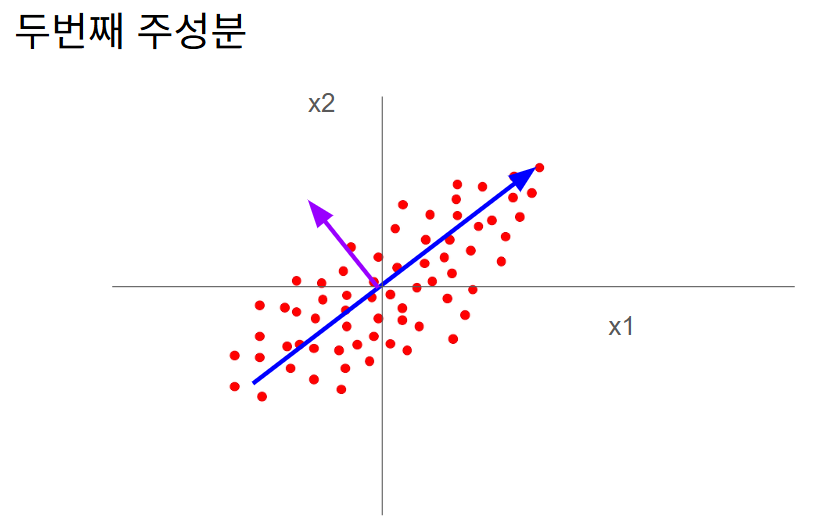
그리고, 이 벡터에 수직이고, 이 분산을 잘 표현하는 두번째 벡터를 찾습니다.
이제 데이터를 준비해보겠습니다.
먼저, 3차원 ndarray인 fruits 데이터를 2차원 ndarray로 변환합니다.
fruits_2d = fruits.reshape(-1, 100*100)사이킷런에서 제공하는 주성분 분석 알고리즘 클래스를 가져옵니다.
from sklearn.decomposition import PCA첫번째 매개변수인 n_components 에는 주성분 개수 혹은 설명된 분산의 비율을 적습니다.
pca = PCA(n_components=50)
pca.fit(fruits_2d)
PCA 클래스가 찾은 주성분을 components_ 라는 속성에서 확인할 수 있습니다.
print(pca.components_) # (50, 10000)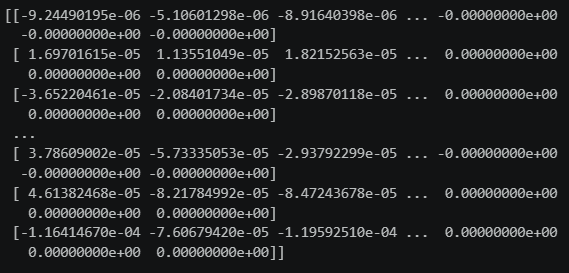
이전에 만들었던 시각화 함수를 가져옵니다.
def draw_fruits(arr, ratio=1):
  n = len(arr)
  rows = int(np.ceil(n/10))
  cols = n if rows < 2 else 10

  fig, axs = plt.subplots(rows, cols, figsize = (cols*ratio, rows*ratio), squeeze=False)

  for i in range(rows):
    for j in range(cols):
      if i * 10 + j < n:
        axs[i, j].imshow(arr[i * 10 + j], cmap='gray_r')
      axs[i, j].axis('off')
  plt.show()
그리고, 주성분을 100 x 100 이미지처럼 출력합니다.
draw_fruits(pca.components_.reshape(-1, 100, 100))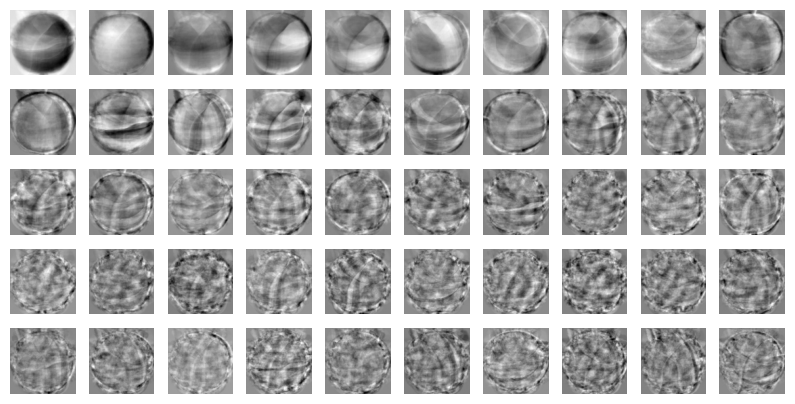
이제 transform() 함수로 주성분으로 분해하는 과정을 거쳐봅시다. 원본 데이터를 주성분에 투영하여 특성 개수를 줄입니다.
차원이 10,000개에서 50개로 줄어듭니다.
fruits_pca = pca.transform(fruits_2d) # (300, 50)이렇게 데이터 차원을 줄였다면 다시 최소한의 손실로 재구성할 수 있습니다.
fruits_inverse = pca.inverse_transform(fruits_pca) # (300, 10000)이 복원된 데이터를 시각화해보겠습니다.
fruits_reconstruct = fruits_inverse.reshape(-1, 100, 100)

for start in [0, 100, 200]:
  draw_fruits(fruits_reconstruct[start:start + 100])
  print('\n')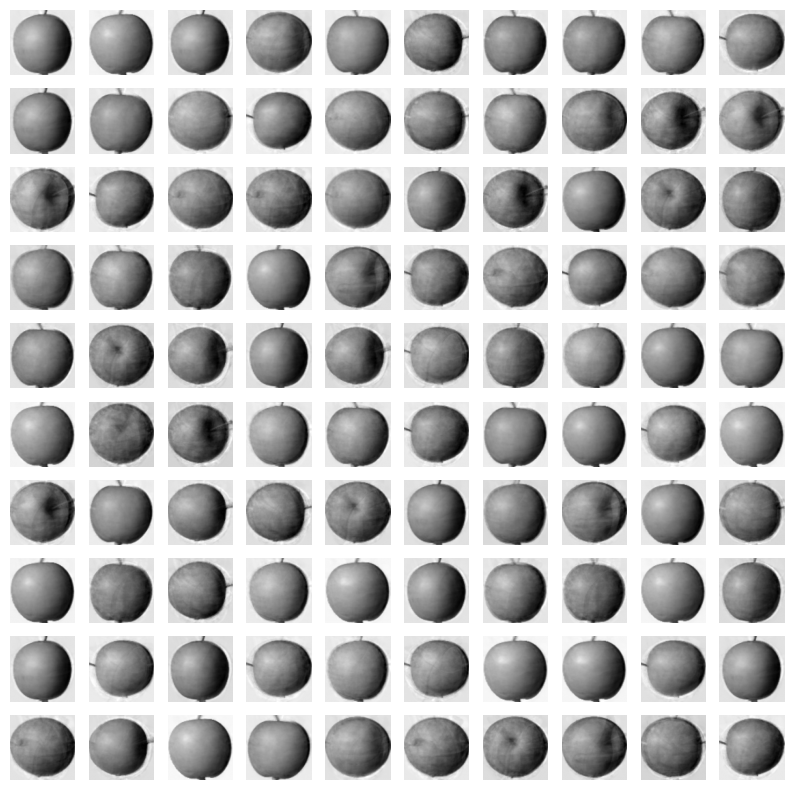
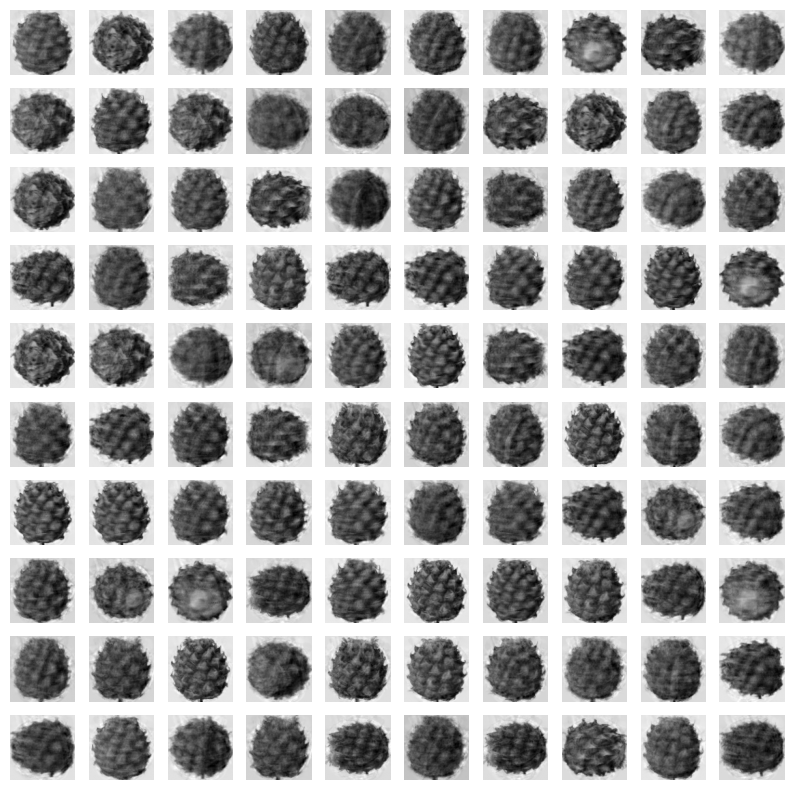
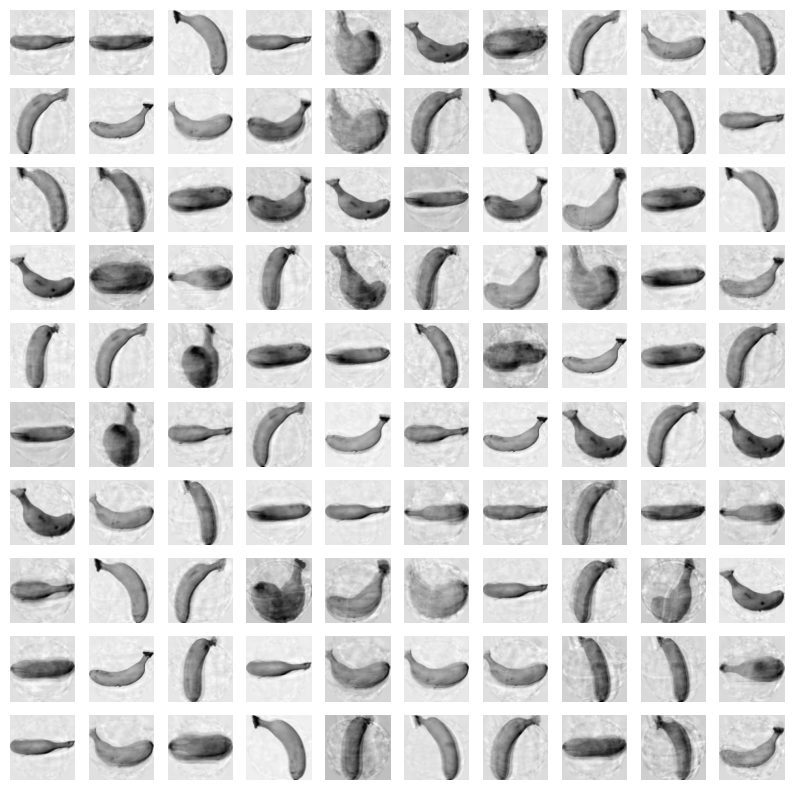
살짝 탁하고 번진 부분이 있지만 어느 정도 원복이 되었습니다.
그렇다면 차원 축소된 50개의 특성은 얼마나 분산을 잘 보존하고 있을까요?
여기서 사용되는 속성은 explained_variance_ratio_ 속성입니다. 원본 데이터의 분산값을 얼마나 잘 나타내는지 기록합니다.
pca.explained_variance_ratio_
# array([0.42357017, 0.09941755, 0.06577863, 0.04031172, 0.03416875,
#      0.03281329, 0.02573267, 0.02054963, 0.01372276, 0.01342773,
#      0.01152146, 0.00944596, 0.00878232, 0.00846697, 0.00693049,
#      0.00645188, 0.00578896, 0.00511202, 0.00486383, 0.00480346,
#      0.00447836, 0.00437318, 0.0040804 , 0.00389474, 0.00372443,
#      0.00359285, 0.00331465, 0.00317839, 0.00304314, 0.00303756,
#      0.0028891 , 0.00275745, 0.002648  , 0.00255949, 0.00252005,
#      0.00247363, 0.00239597, 0.00230914, 0.00221862, 0.00216902,
#      0.0021394 , 0.00194782, 0.00193262, 0.00191025, 0.00184647,
#      0.00182962, 0.00173503, 0.00168848, 0.00163037, 0.00160394])
이 분산 비율을 모두 더하면 50개의 주성분으로 표현하고 있는 총 분산 비율을 얻을 수 있습니다.
print(np.sum(pca.explained_variance_ratio_)) # 0.921582439466792492%가 넘는 분산을 유지하고 있습니다. 이 설명된 분산을 시각화 해봅시다.
plt.plot(pca.explained_variance_ratio_)
plt.show()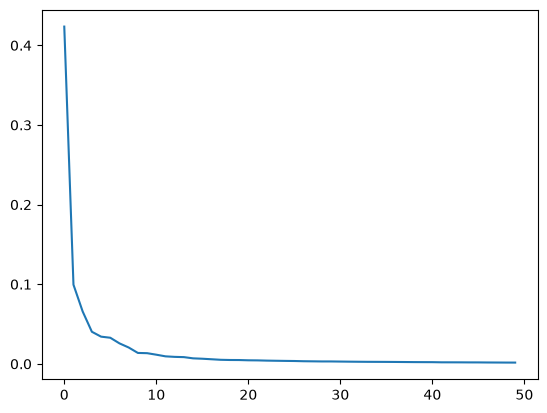
초반 10개 정도의 주성분이 대부분의 분산을 표현하고 있는 것 같습니다. 그 다음부터 주성분은 미미합니다.
그러면 PCA로 차원 축소된 데이터를 지도 학습 훈련해보겠습니다.
3개의 과일 사진을 분류해야 하므로 간단히 로지스틱 회귀 모델을 사용합니다.
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression()
그리고 타겟 값을 다음과 같이 구성합니다.
target = np.array([0]*100 + [1]*100 + [2]*100)그리고 cross_validate를 통해 교차 검증을 수행합니다. 먼저 원본 데이터로 수행합니다.
from sklearn.model_selection import cross_validate

scores = cross_validate(lr, fruits_2d, target)
print(np.mean(scores['test_score'])) # 0.99...
print(np.mean(scores['fit_time'])) # 0.25...
그리고 차원 축소한 데이터로 해봅니다.
scores = cross_validate(lr, fruits_pca, target)
print(np.mean(scores['test_score'])) # 0.99...
print(np.mean(scores['fit_time'])) # 0.02...
결과적으로 점수 지표는 거의 비슷한데, 시간은 12배 이상 빨라졌습니다.