비지도 학습과 군집 알고리즘
비지도 학습은 정답값이 없는 머신러닝 알고리즘입니다.
비지도 학습 중 군집(Clustering) 알고리즘의 목표는 정답이 없는 과일 사진들을 종류별로 모으는 것입니다.
우선 데이터를 준비하겠습니다.
https://www.kaggle.com/datasets/moltean/fruits
Fruits-360 datasetA dataset with 190876 images of 268 fruits, vegetables, nuts, seeds & mushroomswww.kaggle.com
위 링크에서 과일 데이터셋을 불러옵니다.
사과, 바나나, 파인애플을 담고 있는 Grayscale 이미지로써, numpy 저장 포맷 형태로 구성됩니다.
사과, 바나나, 파인애플이 각각 100개씩 들어있는 형태입니다.
file_path = os.path.join(base_path, 'fruits_300.npy')위 데이터의 형태를 알아보기 위해 shape를 출력해봅니다.
fruits = np.load(file_path)
fruits.shape # (300, 100, 100)
위는 샘플 갯수가 300개이고, 각각 width, height가 100 x 100임을 의미합니다.
그러면 첫번째 이미지의 첫번째 행 데이터를 확인해봅시다.
fruits[0, 0]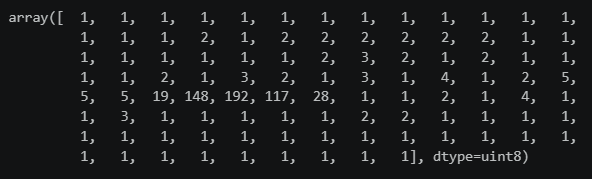
위는 RGB 컬러값으로써 0에 가까우면 검정색, 255에 가까우면 하얀색입니다.
grayscale 이미지이므로, 시각화해보겠습니다.
plt.imshow(fruits[0], cmap='gray')
plt.show()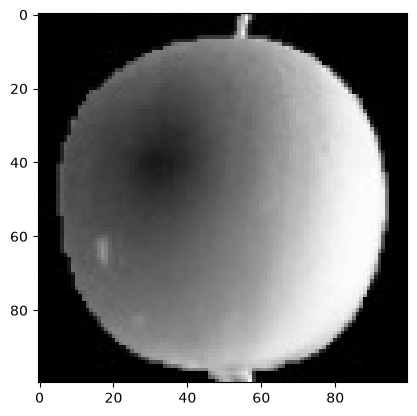
위 이미지는 배경을 검은색(0)으로 만들고, 물체를 밝은 색으로 만들었는데
실제 사진을 넘파이 배열로 변환할 때 반전시킨 것입니다. 즉, 이미지의 관심 대상인 사과에 집중하게 만들기 위해서입니다.
파인애플과 바나나 이미지도 출력해보겠습니다.
fig, axes = plt.subplots(1, 2)
axes[0].imshow(fruits[100], cmap='gray')
axes[1].imshow(fruits[200], cmap='gray')
plt.show()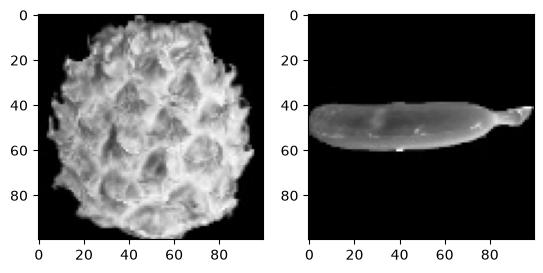
그렇다면 사진을 어떻게 분류해낼 수 있을까요?
픽셀값을 모두 평균 내면 비슷한 과일끼리 모을 수 있지 않을까? 에서 나온 것이 첫번째 아이디어입니다.
사용하기 쉽게 fruits 데이터를 사과, 파인애플, 바나나로 나눠보겠습니다.
apple = fruits[:100].reshape(-1, 100*100)
pineapple = fruits[100:200].reshape(-1, 100*100)
banana = fruits[200:].reshape(-1, 100*100)
먼저 100개의 사과 이미지의 픽셀 평균값을 알아봅니다.
apple.mean(axis=1)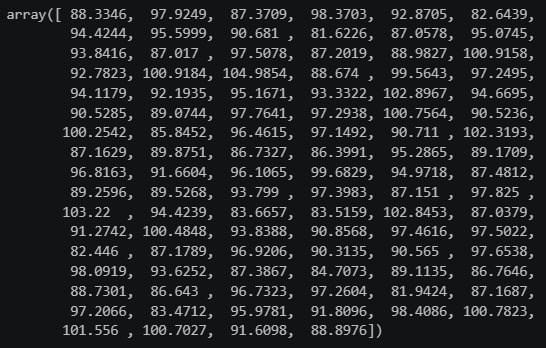
그리고, 히스토그램을 통해 평균값이 어떻게 분포되는지 확인합니다.
plt.hist(np.mean(apple, axis=1), alpha=0.8)
plt.hist(np.mean(pineapple, axis=1), alpha=0.8)
plt.hist(np.mean(banana, axis=1), alpha=0.8)
plt.legend(['apple', 'pineapple', 'banana'])
plt.show()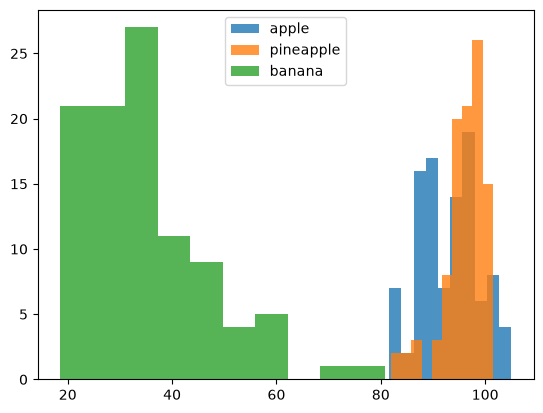
바나나는 사과, 파인애플과는 확실히 구분되지만, 사과와 파인애플은 구분이 쉽지 않습니다.
즉 픽셀 평균값으로는 분석이 쉽지 않겠습니다.
이제 두번째 아이디어로는 샘플의 평균값이 아니라, 픽셀 위치별 평균값을 생각해보겠습니다.
fig, axes = plt.subplots(1, 3, figsize=(20, 5))

axes[0].bar(range(10000), np.mean(apple, axis=0))
axes[1].bar(range(10000), np.mean(pineapple, axis=0))
axes[2].bar(range(10000), np.mean(banana, axis=0))

plt.show()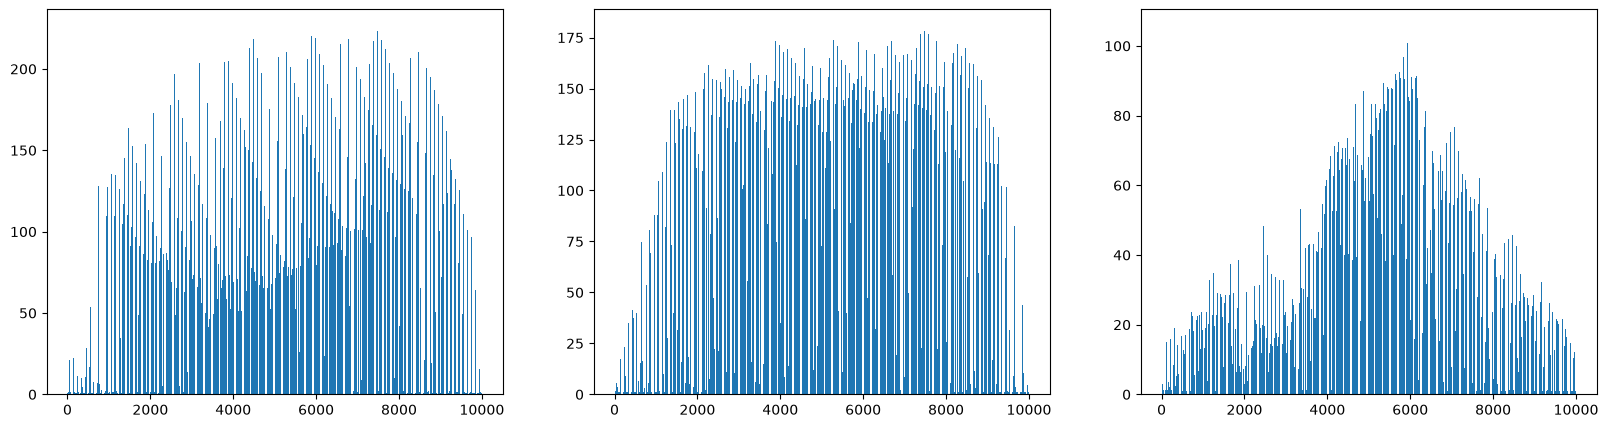
픽셀 평균값을 100x100 크기로 바꿔서 이미지처럼 출력해보겠습니다.
apple_mean = np.mean(apple, axis=0).reshape(100, 100)
pineapple_mean = np.mean(pineapple, axis=0).reshape(100, 100)
banana_mean = np.mean(banana, axis=0).reshape(100, 100)

fig, axs = plt.subplots(1, 3, figsize=(20, 5))

axs[0].imshow(apple_mean, cmap='gray_r')
axs[1].imshow(pineapple_mean, cmap='gray_r')
axs[2].imshow(banana_mean, cmap='gray_r')
plt.show()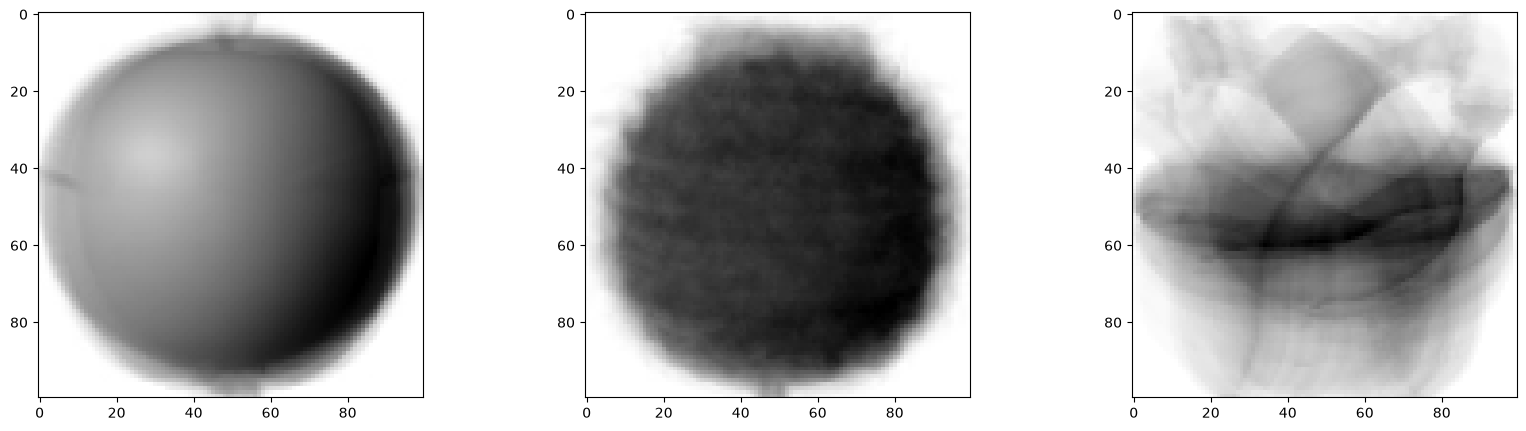
이것은 각 과일별 대표 이미지라고 볼 수 있을 것 같습니다.
이제 평균값에 가까운 사진을 골라보겠습니다.
이 때 절대값 오차를 사용해 샘플에서 apple_mean을 뺀 절대값의 평균을 계산합니다.
abs_diff = np.absolute(fruits - apple_mean)각 샘플에 대한 오차 평균을 구하기 위해 axis에 두번째, 세번째 차원을 모두 지정하겠습니다.
abs_mean = np.mean(abs_diff, axis=(1, 2))이러면 총 300개의 평균이 나옵니다.
np.argsort() 함수를 이용해 작은 것에서 큰 순서대로 나열한 abs_mean 배열의 인덱스를 반환합니다.
np.argsort(abs_mean)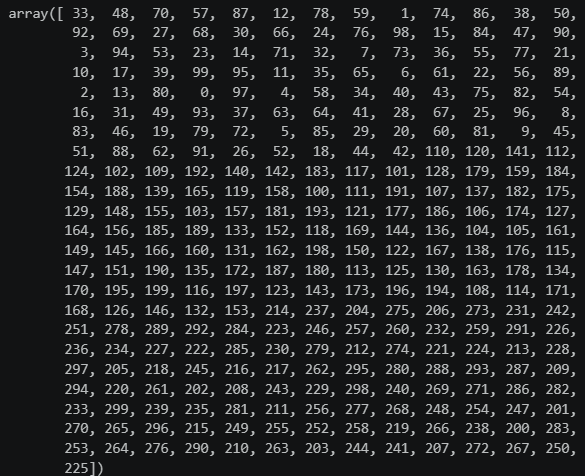
초반 100개를 시각화해보겠습니다. 사과를 잘 분류해냈는지 확인합니다.
apple_index = np.argsort(abs_mean)[:100]

fig, axs = plt.subplots(10, 10, figsize=(10, 10))

for i in range(10):
  for j in range(10):
    axs[i, j].imshow(fruits[apple_index[i*10 + j]], cmap='gray_r')
    axs[i, j].axis('off')

plt.show()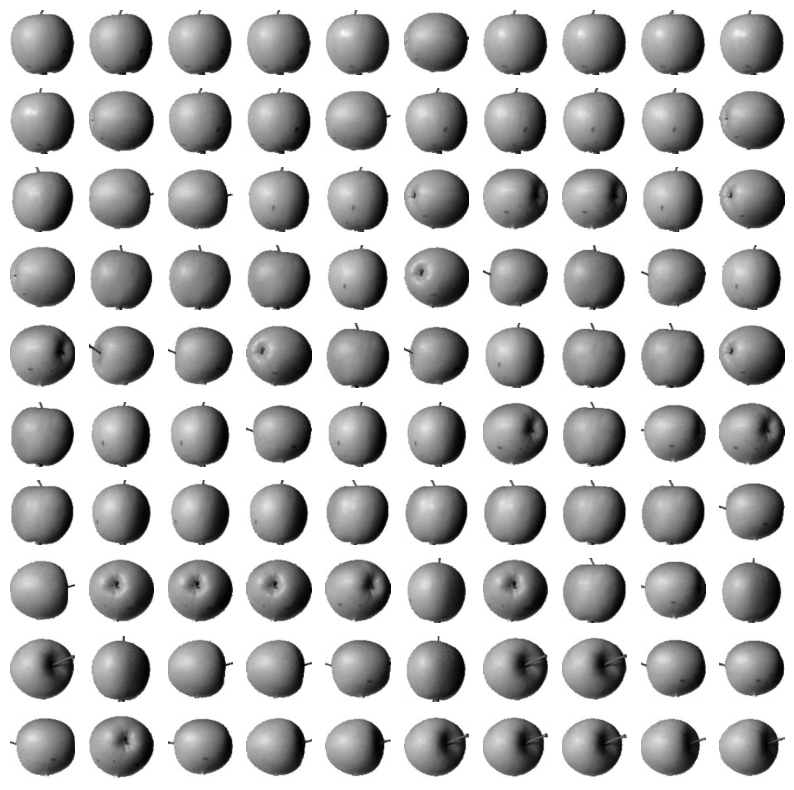
이렇게 비슷한 것끼리 묶는 클러스터링(군집) 알고리즘 중 k-means 군집 알고리즘을 실습으로 알아본 겁니다.
여기서 평균값은 클러스터의 중심에 위치하므로, 클러스터 중심 혹은 센트로이드 라고도 합니다.
본격적으로 k-평균 알고리즘의 동작 방식을 살펴보겠습니다.
첫번째, 무작위로 k개의 클러스터 중심을 정합니다.
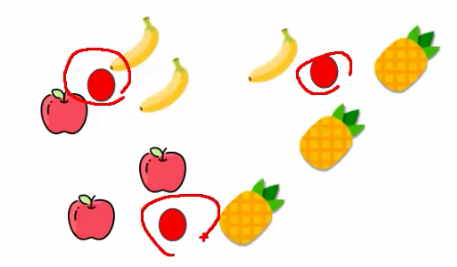
두번째, 각 샘플에서 가까운 클러스터 중심을 찾아 해당 클러스터의 샘플로 지정합니다.
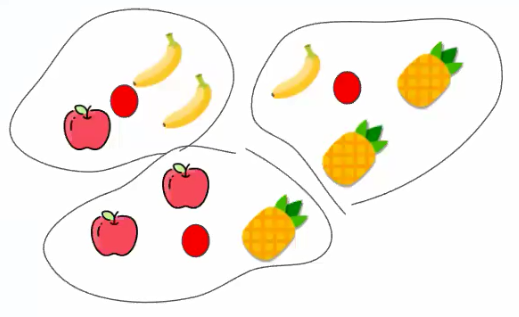
세번째, 클러스터에 속한 샘플의 평균값으로 클러스터 중심을 옮깁니다.
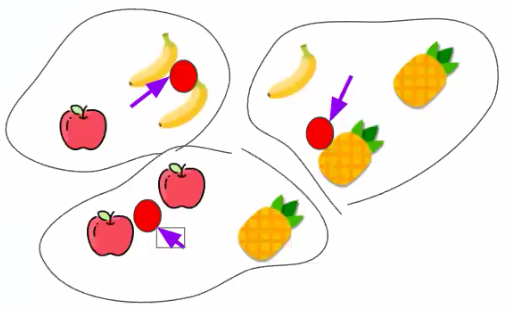
네번째, 클러스터 중심에 변화가 없을 때까지 2번째 방식으로 돌아가 반복합니다.
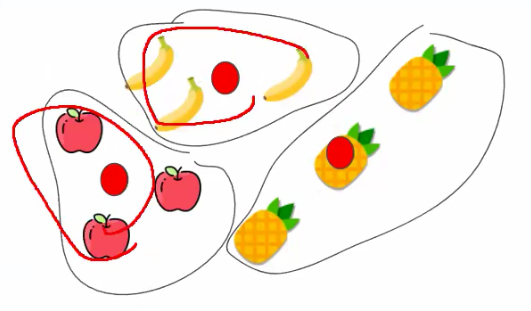
본격적으로 k-평균 모델을 훈련하기 위해 (샘플 개수, 높이, 너비)의 3차원 배열을 (샘플 개수, 높이 x 너비)로 변환합니다.
fruits_2d = fruits.reshape(-1, 100*100)k-means 알고리즘 클래스를 불러옵니다.
from sklearn.cluster import KMeans첫번째 매개변수 n_cluster는 클러스터 개수입니다. 기본값은 8입니다.
km = KMeans(n_clusters=3, random_state=42)
km.fit(fruits_2d)
군집된 결과는 labels_ 속성에 저장됩니다.
km.labels_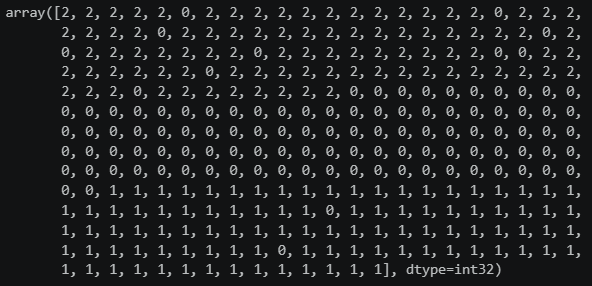
클러스터가 어떤 이미지를 나타내는지 그림으로 출력하기 위해 함수를 만듭니다.
def draw_fruits(arr, ratio=1):
  n = len(arr)
  rows = int(np.ceil(n/10))
  cols = n if rows < 2 else 10

  fig, axs = plt.subplots(rows, cols, figsize = (cols*ratio, rows*ratio), squeeze=False)

  for i in range(rows):
    for j in range(cols):
      if i * 10 + j < n:
        axs[i, j].imshow(arr[i * 10 + j], cmap='gray_r')
      axs[i, j].axis('off')
  plt.show()
fruits에서 label이 0인 과일들만 그립니다.
draw_fruits(fruits[km.labels_ == 0])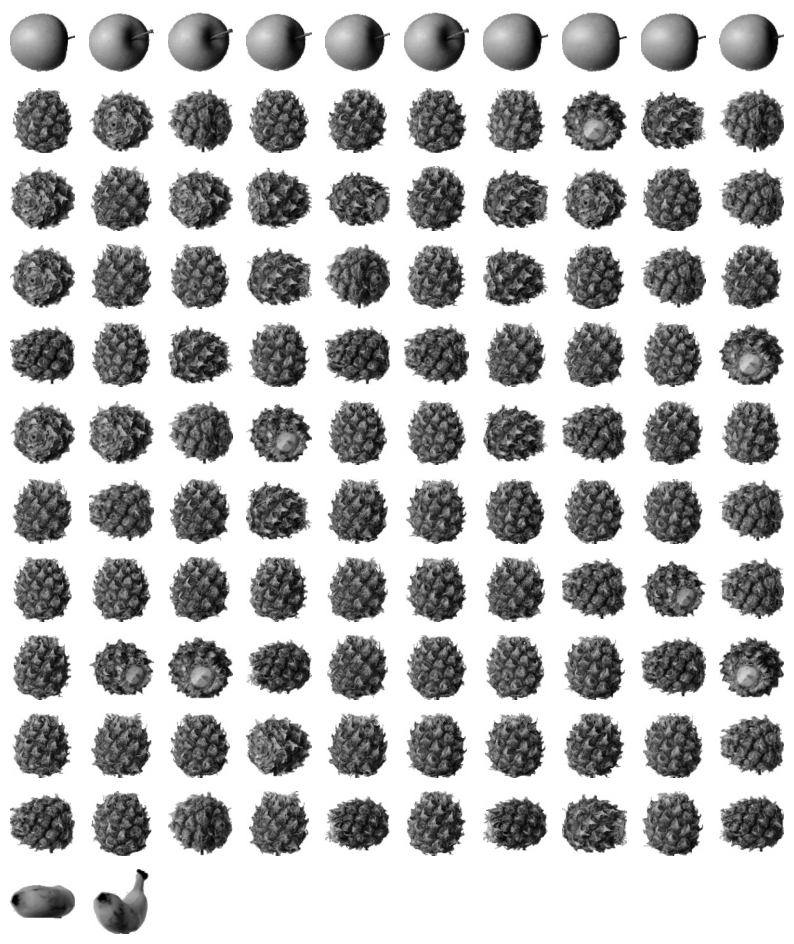
fruits에서 label이 1인 과일들만 그립니다.
draw_fruits(fruits[km.labels_ == 1])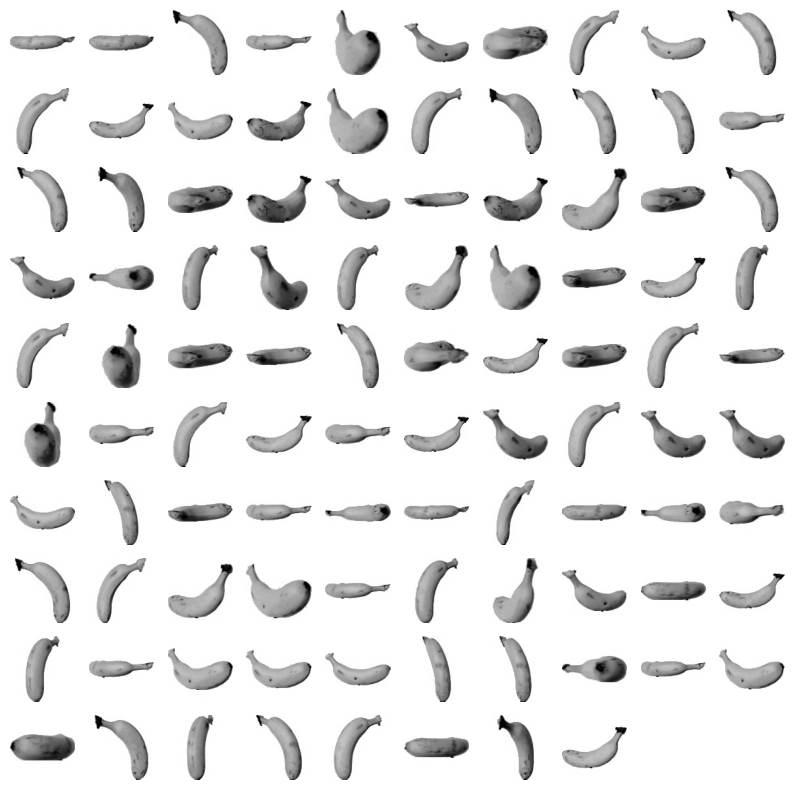
fruits에서 label이 2인 과일들만 그립니다.
draw_fruits(fruits[km.labels_ == 2])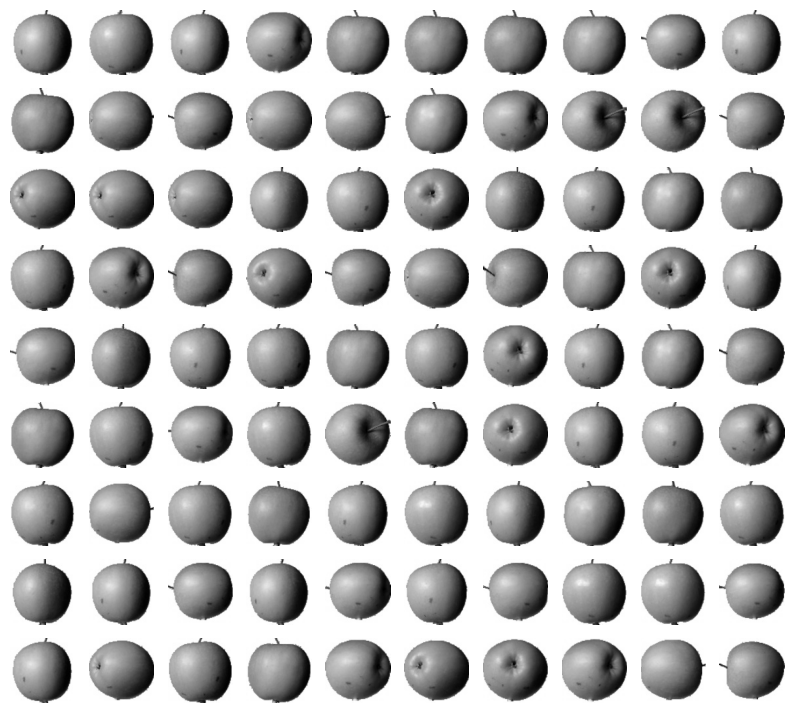
여기서 클러스터 중심은 cluster_centers_ 속성에 저장되어 있습니다.
먼저 shape을 찍어보겠습니다.
print(km.cluster_centers_.shape) # (3, 10000)클러스터 중심을 시각화해봅니다.
draw_fruits(km.cluster_centers_.reshape(-1, 100, 100), ratio=3)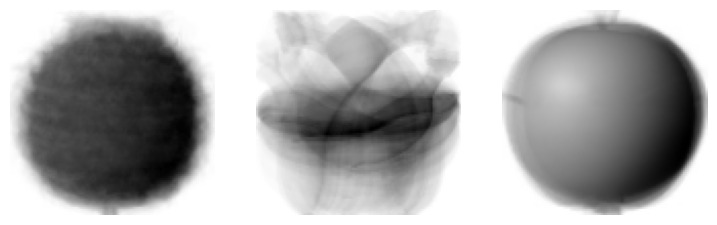
각 과일의 픽셀 위치별 평균값을 합친것과 비슷한 모습입니다.
그리고, transform() 함수를 통해 훈련 데이터 샘플에서 클러스터 중심까지의 거리로 변환해줍니다.
인덱스 100짜리 샘플을 transform 적용해봅시다.
km.transform(fruits_2d[[100]])
이번엔 가장 가까운 클러스터 중심을 예측해보겠습니다.
km.predict(fruits_2d[100:101]) # array([0], dtype=int32)실제로 확인해보면 0번이 나옵니다.
draw_fruits(fruits[100:101])
그리고, 클러스터 중심을 이동했던 횟수가 n_iter_ 속성에 저장됩니다.
km.n_iter_ # 4그렇다면, 지금은 애초에 데이터셋에 대한 정보가 파악돼 n_cluster=3으로 지정한 것입니다.
실전의 데이터는 이러한 정보도 없을 텐데 어떤 값을 지정하면 될까요? 그 중 대표적인 방법인 elbow 방법을 소개합니다.
k-평균 알고리즘은 클러스터 중심과 클러스터의 샘플 간의 거리를 잴 수 있는데 이 거리의 제곱합을 이너셔 라고 합니다.
이너셔는 클러스터에 속한 샘플이 얼마나 가깝게 모여있는지 나타내는 값으로 활용합니다.
클러스터의 개수가 늘어나면, 클러스터 개개의 크기는 줄어들기 때문에 이너셔도 줄어듭니다.
엘보우 방법은 클러스터의 개수를 증가시킬 때 이너셔 값이 낮아지는데 어느 순간 낮아짐이 둔해지는 구간이 있습니다.
이 때의 클러스터의 개수를 최적의 클러스터의 개수라고 합니다.
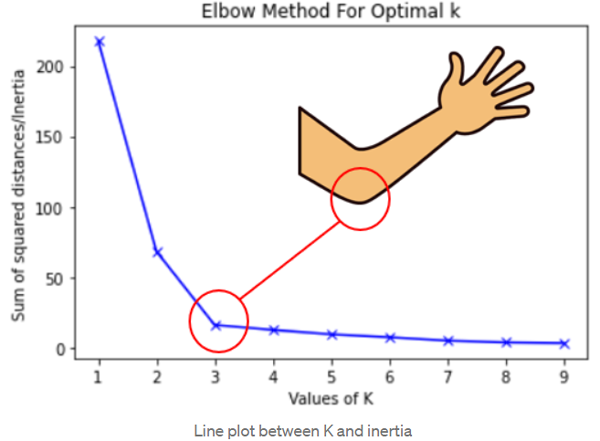
그래서 클러스터 개수를 2번부터 6번까지 바꾸어가며 훈련해봅니다.
inertia = []

for k in range(2, 7):
  km = KMeans(n_clusters=k, random_state=42)
  km.fit(fruits_2d)
  inertia.append(km.inertia_)

plt.plot(range(2, 7), inertia)
plt.xlabel('k')
plt.ylabel('inertia')
plt.show()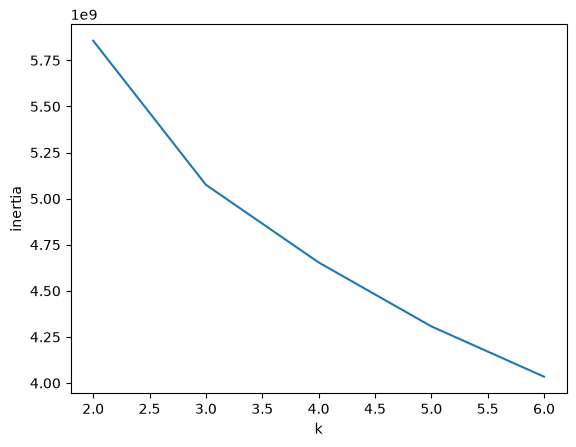
k 값이 3일 때가 최적의 k값임을 알 수 있습니다.