사이킷런을 이용한 분류문제
분류 문제(Classification)는 여러 개의 종류 중 하나를 구별해내는 문제입니다.
먼저 기본적으로 import할 기본 라이브러리를 불러옵니다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import os
다음 링크에서 Fish.csv 데이터셋을 가져와서 생선 분류 문제를 해결해봅시다.
https://www.kaggle.com/datasets/vipullrathod/fish-market
Fish MarketEstimate the weight of a fish based on its species and the physical measurementswww.kaggle.com
먼저 base_path 경로를 잡아 csv 파일이 있는 path 경로를 잡습니다.
base_path = r'C:\Users\haruka\Desktop\AI수업\mcp-month-2\data'다음에 이제 DataFrame으로 읽어들입니다.
file_path = os.path.join(base_path, 'fish.csv')
fish_df = pd.read_csv(file_path)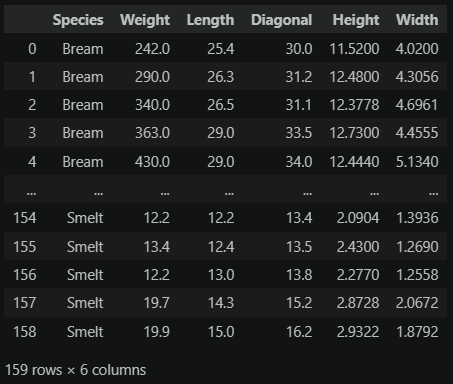
그리고, info() 통해 결측값 여부를 확인합니다. 확인 결과 null 값은 없습니다.
fish_df.info()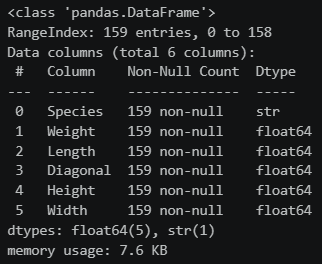
컬럼 중에 하나인 Species의 유니크 값을 살펴봅니다.
fish_df.Species.unique() # ['Bream', 'Roach', 'Whitefish', 'Parkki', 'Perch', 'Pike', 'Smelt']각 Species 별 데이터의 개수를 살펴봅니다.
fish_df.Species.value_counts()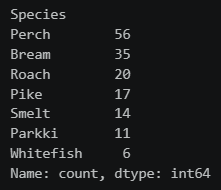
이제 이 데이터를 바탕으로, 생선의 길이(Length), 무게(Weight)만으로 생선의 종류(Species)를 분류해볼 것입니다.
분류할 생선은 Bream(도미), Smelt(빙어)이며, 이것이 이진 분류입니다.
먼저 원본 데이터프레임에서 Bream의 Length 컬럼만 뽑아내겠습니다.
bream_length = fish_df[fish_df.Species == 'Bream']['Length'].to_list()
# [25.4, 26.3, 26.5, 29.0, 29.0, 29.7, 29.7, 30.0, 30.0, 30.7, 31.0, 31.0, 31.5, 32.0, ...]
그리고 원본 데이터프레임에서 Bream의 Weight 컬럼만 뽑아내겠습니다.
bream_weight = fish_df[fish_df.Species == 'Bream']['Weight'].to_list()
# [242.0, 290.0, 340.0, 363.0, 430.0, 450.0, 500.0, 390.0, 450.0, 500.0, ...]
Smelt의 Length 컬럼만 뽑아냅니다.
smelt_length = fish_df[fish_df.Species == 'Smelt']['Length'].to_list()
# [9.8, 10.5, 10.6, 11.0, 11.2, 11.3, 11.8, 11.8, 12.0, 12.2, ...]
Smelt의 Weight 컬럼만 뽑아냅니다.
smelt_weight = fish_df[fish_df.Species == 'Smelt']['Weight'].to_list()
# [6.7, 7.5, 7.0, 9.7, 9.8, 8.7, 10.0, 9.9, 9.8, 12.2, 13.4, 12.2, 19.7, 19.9]
길이(Length), 무게(Weight)은 생선 데이터의 특징 및 특성(feature) 입니다.
도미 데이터의 길이를 x축으로, 무게를 y축으로 정하여 Scatter Plot으로 표시해봅니다. (관계 파악)
결과적으로 두 특성 간에는 상관관계가 있습니다.
plt.scatter(bream_length, bream_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()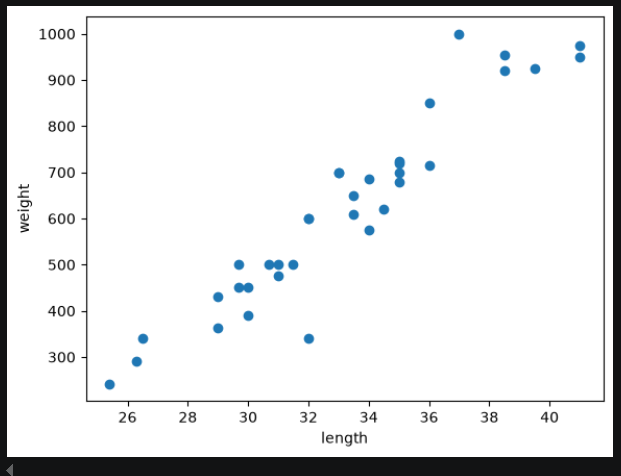
이번엔 두 생선의 데이터를 한번에 ScatterPlot으로 보겠습니다.
도미(Bream)가 길이에 대비해 늘어나는 무게가 빙어(Smelt)가 길이에 대비해 늘어나는 무게보다 더 큽니다.
plt.scatter(bream_length, bream_weight)
plt.scatter(smelt_length, smelt_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()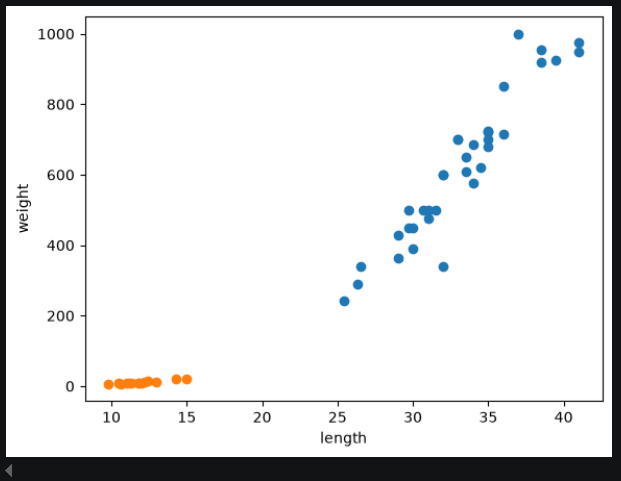
이제 머신러닝의 입력 데이터(input)와 답안 데이터(label)를 준비해봅시다.
먼저 입력 데이터를 준비하는데 있어 도미(Bream)와 빙어(Smelt) 데이터를 하나로 합칩니다.
length = bream_length + smelt_length
weight = bream_weight + smelt_weight
사이킷런(Scikit Learn)에서는 입력 데이터를 각 특성들의 배열 형태 (2차원 형태)로 만들어야 합니다.
이것을 입력(input)이라고도 하고 특성 벡터(feature vector)라고도 합니다.
fish_data = [[l, w] for l, w in zip(length, weight)]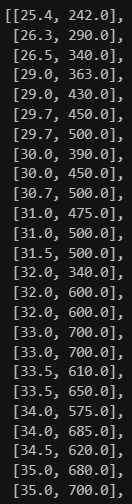
그리고 답안 데이터(label)를 준비하는데 지도학습에서는 입력 데이터에 대한 답안 데이터입니다.
머신러닝 알고리즘은 이를 계산 가능한 숫자 형태로 알려주어야 합니다.
도미(Bream)는 1로, 빙어(Smelt)는 0으로 표현된 답안을 준비해봅시다.
fish_target = [1] * 35 + [0] * 14
입력 데이터는 X로 타겟 데이터는 y로 표현하겠습니다.
이제 머신러닝 모델을 준비해야 합니다. 이번에 사용할 모델은 KNN이라는 k-최근접 이웃 알고리즘 클래스입니다.
from sklearn.neighbors import KNeighborsClassifier이제 모델 클래스 객체를 생성하겠습니다.
kn = KNeighborsClassifier()사이킷런에서는 지도학습의 모델을 estimator라고 통칭하고, 그 중 분류 모델을 classifier라고 합니다.
KNN 알고리즘이란, 어떤 답을 구할 때 주변에 있는 다른 데이터를 보고 다수를 차지하는 것을 정답으로 봅니다.
아까 도미(Bream)와 빙어(Smelt)를 ScatterPlot으로 산점도로 그린 것을 한번 더 보겠습니다.
plt.scatter(bream_length, bream_weight)
plt.scatter(smelt_length, smelt_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()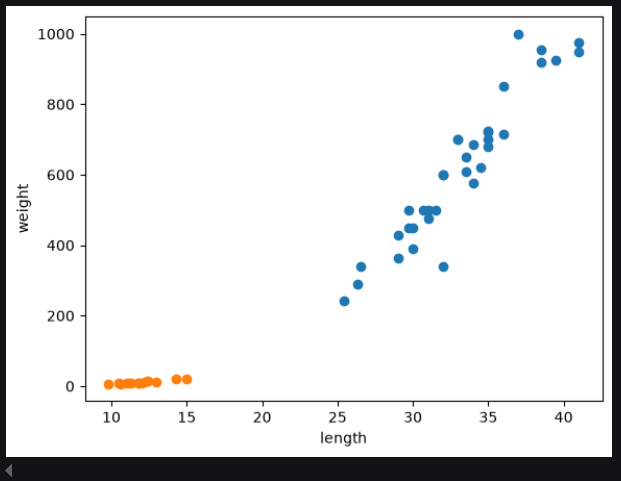
여기서 길이가 30이고, 무게가 600인 데이터를 추가로 찍습니다.
plt.scatter(30, 600, marker='^')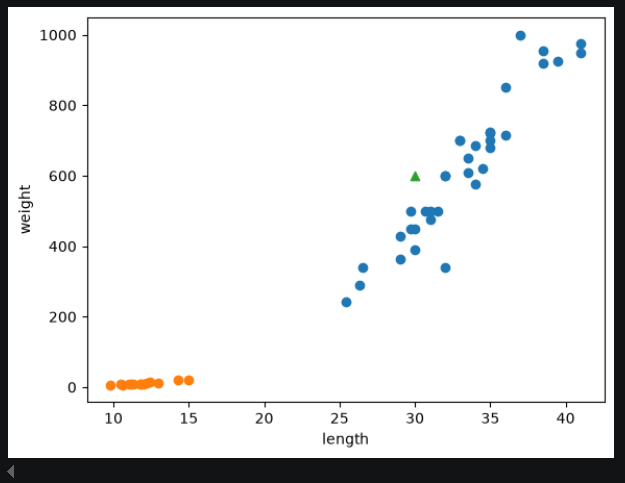
현재 marker ^으로 찍은 데이터 주변의 이웃들을 보세요.
도미(Bream)가 많나요? 빙어(Smelt)가 많나요? 현재는 전부 도미(Bream)입니다. 따라서 도미(Bream)으로 예상합니다.
이제 이 KNN 알고리즘을 기반으로 학습해보겠습니다. 이것을 훈련(train)한다고 하기도 하고, 적합(fit)한다라고도 합니다.
지도학습은 fit(입력데이터, 타겟데이터)로 학습을 진행합니다.
kn.fit(fish_data, fish_target)여기서 학습의 정확도(accuracy)를 점수로 확인할 수 있습니다. score() 함수로 점수를 산출합니다.
여기서는 100%로 산출됩니다.
kn.score(fish_data, fish_target) # 1.0이제 이 학습된 모델을 통해 새로운 데이터를 예측해보겠습니다.
predict() 함수를 통해 새로운 관측 데이터를 넣고, 예측결과를 반환합니다.
predict()에서 입력데이터는 feature들의 배열로 넣어주어야 합니다.
kn.predict([[30, 600]]) # array([1])
kn.predict([[30, 600], [16, 30]]) # array([1, 0])
이제 KNN 알고리즘의 속성들을 들여다보겠습니다.
_fit_X는 전달한 인풋 데이터를 가지고 있습니다.
print(kn._fit_X)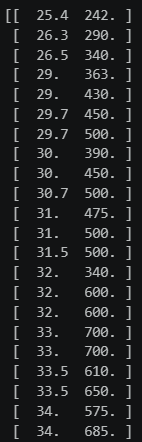
_y는 타겟값을 가지고 있습니다.
print(kn._y)
n_neighbors 옵션은 가장 가까운 몇개의 데이터(기본값 5)를 참고하게 될지 n_neighbors 값으로 정해줄 수 있습니다.
49개의 참조 데이터를 사용하는 모델을 설정하겠습니다.
kn49 = KNeighborsClassifier(n_neighbors=49)이제 훈련하고 점수까지 확인해보겠습니다.
kn49.fit(fish_data, fish_target)
kn49.score(fish_data, fish_target) # 0.7142857142857143
이 점수값은 도미(Bream)의 개수 / 전체의 개수가 될 것입니다. 즉, 도미(Bream)만 맞추고 빙어(Smelt)는 다 틀린 겁니다.
print(35/49) # 0.714857142857143따라서, KNN 알고리즘은 입력 데이터가 너무 많으면 오히려 정확도가 떨어질 수 있다는 것이 결론입니다.
그렇다면, n_neighbors가 몇개일 때부터 정확도가 100%에 미치지 못하는지 직접 확인해봅시다.
kn = KNeighborsClassifier()
kn.fit(fish_data, fish_target)

for n in range(5, 50):
  kn.n_neighbors = n
  score = kn.score(fish_data, fish_target)
  if score < 1:
    print(n, score) # 18 0.989581836736939
    break
결론적으로 18개일때부터, 정확도 100%가 깨집니다.
하지만, 주어진 문제와 답안지로 열심히 공부해서 100점을 맞는다고 잘한다는 보장은 없습니다.
진짜 잘하는지는 문제집에 없는 문제를 풀어도 점수가 좋아야 하는 것처럼
data와 target을 학습하는데 다 집어넣는 것이 아니라, 훈련 세트와 **테스트 세트(검증 세트)**를 나누어서
모델 훈련 및 검증에 사용해야 합니다.
현재 우리가 가진 데이터는 Bream(1)과 Smelt(0)가 각각 35마리, 14마리가 있습니다.
여기서 데이터의 처음 35개를 훈련 세트, 나머지 14개를 테스트 세트를 사용해보겠습니다.
train_input = fish_data[:35]
train_target = fish_target[:35]

test_input = fish_data[35:]
test_target = fish_target[35:]
이것을 훈련용 데이터로 학습하고, 테스트용 데이터로 평가해보겠습니다.
kn.fit(train_input, train_target)
kn.score(test_input, test_target) # 0.0
결과적으로 점수는 0점이 나옵니다.
이유는 테스트 데이터는 죄다 빙어(Smelt)는 훈련용 데이터는 죄다 도미(Bream)이기 때문입니다.
이것을 샘플링 편향(Sampling Bias) 문제라고 합니다. 데이터가 골고루 섞여야 하는 것입니다.
우선 수동으로 numpy를 이용해 섞어보겠습니다. 먼저 data와 target을 ndarray로 변환합니다.
input_arr = np.array(fish_data)
target_arr = np.array(fish_target)
동일한 실습 결과를 얻기 위해 Seed값을 설정하고 shuffle() 함수로 섞어줍니다.
np.random.seed(42)
index = np.arange(49)
np.random.shuffle(index)
이제 인덱스가 랜덤으로 섞였으므로, 35개를 기준으로 train 세트를 만들어줍니다.
train_input = input_arr[index[:35]]
train_target = target_arr[index[:35]]
이제 나머지로 test 세트를 만듭니다.
test_input = input_arr[index[35:]]
test_target = target_arr[index[35:]]
이제 잘 섞였는지 시각화를 통해 확인하겠습니다.
plt.scatter(train_input[:, 0], train_input[:, 1])
plt.scatter(test_input[:, 0], test_input[:, 1])
plt.xlabel('length')
plt.ylabel('weight')
plt.show()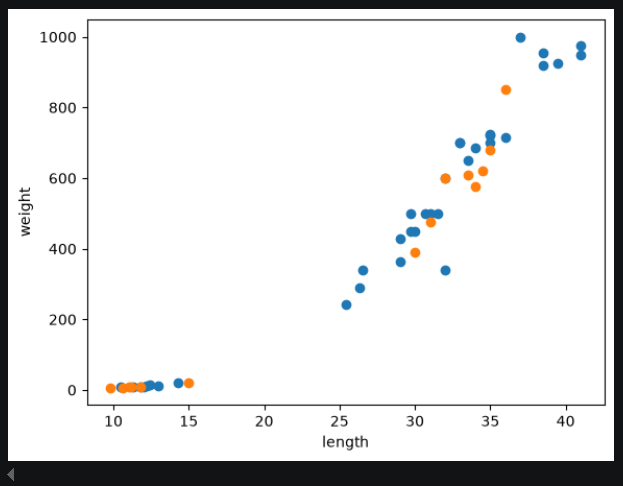
잘 섞인 것 같으니 이 훈련용 데이터로 다시 훈련을 해보겠습니다.
kn = KNeighborsClassifier()
kn.fit(train_input, train_target)
평가는 테스트용 데이터로 합니다.
kn_score(test_input, test_target) # 1.0점수가 1.0으로 나와, 샘플링 편향 문제가 사라졌습니다.
그래서, 테스트 인풋 데이터로 예측해보겠습니다.
kn.predict(test_input) # array([0, 0, 1, 0, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0])이것을 정답과 비교해볼까요? 정답과 정확히 일치합니다.
test_target # array([0, 0, 1, 0, 1, 1, 1, 0, 1, 1, 0, 1, 1, 0])그러면 이것은 잘 학습된 모델인건지, 길이 25cm, 무게 150g 데이터를 예측해보겠습니다.
kn.predict([[25, 150]]) # array([0])이 데이터는 현재 기준대로라면, 도미(Bream, 1)이어야 하지만 결과는 빙어(Smelt, 0)으로 뜹니다.
왜 이런 일이 일어나는지 살펴보기 위해 넘파이의 column_stack() 함수 통해서
전달받은 리스트를 일렬로 세운 다음 차례로 나란히 연결하는 기능을 사용해야 합니다.
예시를 살펴보겠습니다.
np.column_stack(([1, 2, 3], [4, 5, 6])) # array([[1, 4], [2, 5], [3, 6]])확인하기 위해 도미(Bream)의 feature와 빙어(Smelt)의 feature를 다 합쳐봅니다.
fish_length = bream_length + smelt_length
fish_weight = bream_weight + smlet_weight
이것을 column_stack() 함수를 통해 length와 weight을 합칩니다.
fish_data = np.column_stack(fish_length, fish_weight)그리고 초반 5개만 살펴봅니다.
fish_data[:5]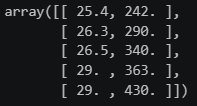
또, np.ones()와 np.zeros() 함수 이용해 타겟 데이터도 합쳐봅니다.
fish_target = np.concatenate((np.ones(35), np.zeros(14)))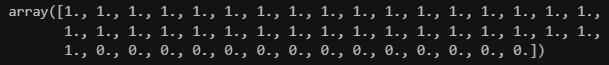
이것을 훈련용, 테스트용으로 쪼개기 위해 사이킷런의 train_test_split를 사용해야 합니다.
from sklearn.model_selection import train_test_split이것은 주어진 데이터와 타겟 데이터를 무작위로 섞은 뒤(shuffle) 3:1로 분리합니다.
예제에선 동일값을 내기 위해, random_state=42로 셋팅합니다.
train_input, test_input, train_target, test_target=\
train_test_split(fish_data, fish_target, random_state=42)
이것은 튜플을 리턴하는데
(훈련용 입력 데이터, 테스트용 입력 데이터, 훈련용 타겟 데이터, 테스트용 타겟 데이터) 를 리턴합니다.
각 데이터의 shape을 찍어보겠습니다.
print(train_input.shape, test_input.shape) # (36, 2) (13, 2)
print(train_target.shape, test_target.shape) # (36,) (13,)
여기서 test_target만 보았을 때는 다음과 같습니다.
test_target # array([1., 0., 0., 0., 1., 1., 1., 1., 1., 1., 1., 1.])아직 데이터간 비율이 3.3 : 1이므로 편향될 가능성이 있습니다.
이를 방지하기 위해 split 할 때 stratify 파라미터에 target 데이터를 전달하면 비율에 맞게 데이터를 나눕니다.
train_input, test_input, train_target, test_target=\
train_test_split(fish_data, fish_target, stratify=fish_target, random_state=42)
그리고 test_target을 다시 보겠습니다.
test_target # array([0., 0., 1., 0., 1., 0., 1., 1., 1., 1., 1., 1., 1.])이제 데이터간 비율이 2.25 : 1이므로, 실제 데이터 비율과 비슷하게 됐습니다.
그러므로, 이제 다시 학습을 시켜보겠습니다.
kn = KNeighborsClassifier()
kn.fit(train_input, train_target)
kn.score(test_input, test_target)
그리고 길이가 25cm이고, 무게가 150g인 생선을 예측해봅니다.
kn.predict([[25, 150]]) # array([0])하지만 그래도 여전히 0 입니다.
다시 원인을 파악하기 위해 kneighbors() 함수를 이용해 이웃까지의 거리들과 이웃 샘플에 대한 인덱스를 리턴해봅니다.
distances, indexes =  kn.kneighbors([[25, 150]])

print(distances) # [[ 92.00086956 130.48375378 130.73859415 138.32150953 138.39320793]]
print(indexes) # [[21 33 19 30  1]]
이것을 시각화해보겠습니다.
plt.scatter(train_input[:, 0], train_input[:, 1])
plt.scatter(25, 150, marker='^')
plt.scatter(train_input[indexes, 0], train_input[indexes, 1], marker='D')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()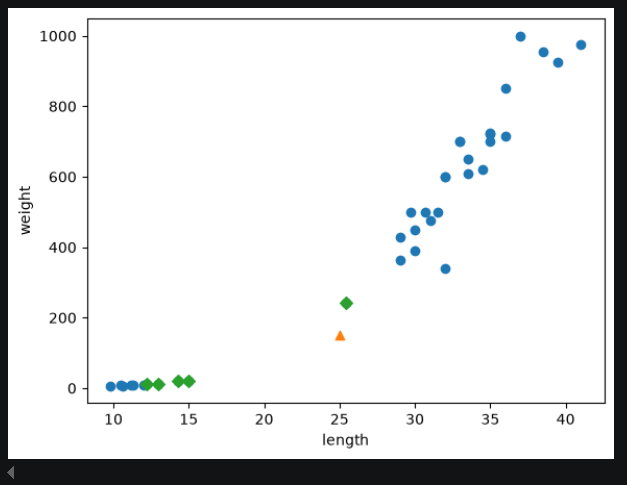
실제로 판단에 사용된 이웃 데이터 대부분이 빙어(Smelt)에 모여있는 모습입니다.
거리가 맞는지 거리 변수의 값을 찍어보겠습니다.
print(distances) # [[ 92.00086956 130.48375378 130.73859415 138.32150953 138.39320793]]그러나 시각화를 통해 본 거리 차이를 비교했을 때는 이해가 안되는 결과로 보입니다.
이 이유는 x축과 y축의 범위가 다르기 때문입니다. 우리가 표현하는 feature들의 값의 범위가 다르면 원하는 동작이 안 됩니다.
그래서 다시 시각화를 하되, x축과 y축을 0부터 1000까지로 다 맞추어보겠습니다.
plt.scatter(train_input[:, 0], train_input[:, 1])
plt.scatter(25, 150, marker='^')
plt.scatter(train_input[indexes, 0], train_input[indexes, 1], marker='D')

plt.xlim((0, 1000))
plt.xlabel('length')
plt.ylabel('weight')
plt.show()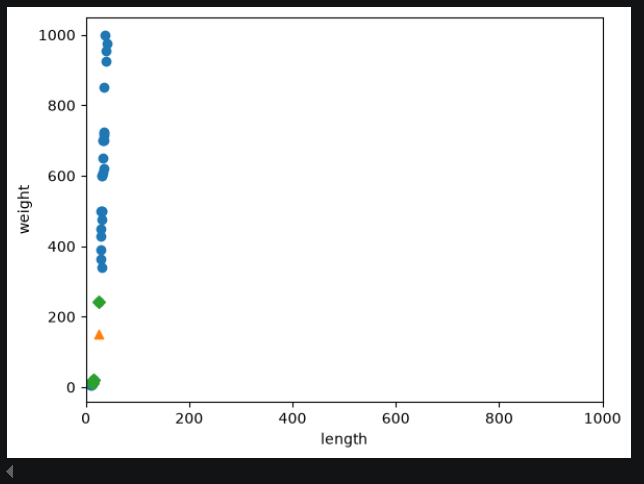
이제 거리를 비교했을 때 빙어(Smelt)로 예상되는게 이해될만 합니다.
따라서 데이터의 입력 feature의 범위가 다른 것을 스케일이 다르다고도 표현합니다.
즉, 머신러닝에서 서로 동등한 영향력을 행사하도록 하려면 일정 기준으로 맞추는 스케일링 작업을 해야 합니다.
하지만, 트리 기반 알고리즘은 서로 스케일이 다르더라도 잘 동작할 수도 있습니다.
이제 스케일링의 2가지 방법에 대해 알아보겠습니다. 표준화와 정규화가 있습니다.
여기서는 표준화를 쓸텐데, 분산과 표준편차를 사용해 표준점수를 뽑아냅니다.
평균을 빼고 표준편차로 나누는 값입니다.
mean = np.mean(train_input, axis=0)
std = np.std(train_input, axis=0)
이제 데이터를 스케일링해봅시다.
train_scaled = (train_input - mean) / std이 데이터와 (25, 150)을 다시 시각화 해봅니다.
plt.scatter(train_scaled[:, 0], train_scaled[:, 1])
plt.scatter(25, 150, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()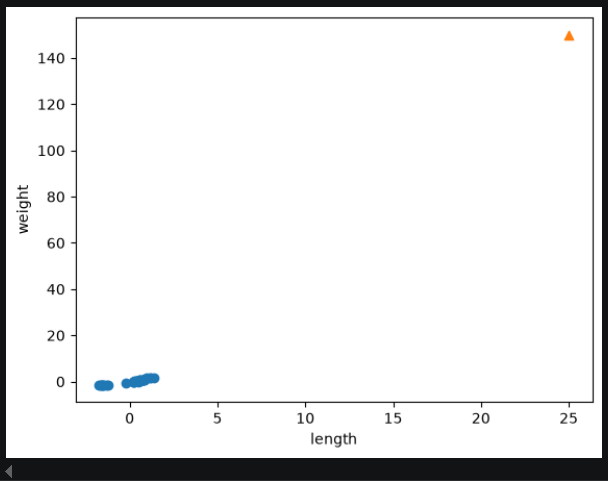
이 결과를 보면 알 수 있듯이 확인할 데이터도 스케일링 해줘야 합니다.
new = ([25, 150] - mean) / std그리고, 다시 시각화합니다.
plt.scatter(train_scaled[:, 0], train_scaled[:, 1])
plt.scatter(new[0], new[1], marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()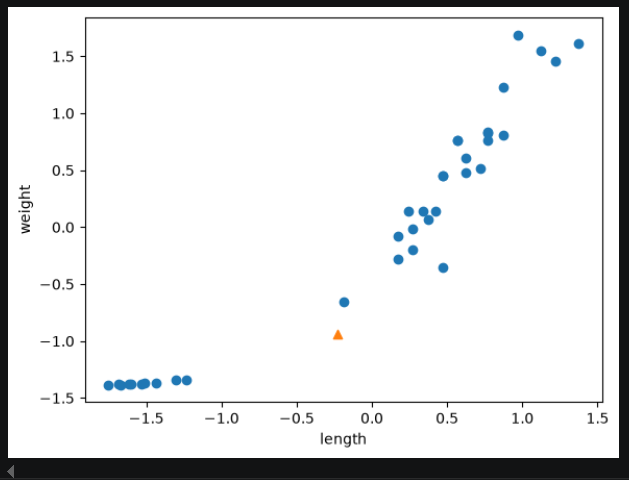
따라서 스케일링된 데이터셋으로 모델을 다시 훈련시키겠습니다.
kn.fit(train_scaled, train_target)그리고 테스트 세트도 평균과 표준편차로 변환합니다.
test_scaled = (test_input - mean) / std그리고, 모델을 평가하면 1.0이 찍힙니다.
kn.score(test_scaled, test_target) # 1.0이제 아까 수상한 데이터를 예측해보겠습니다. 결과값으로 이제 1이 뜹니다.
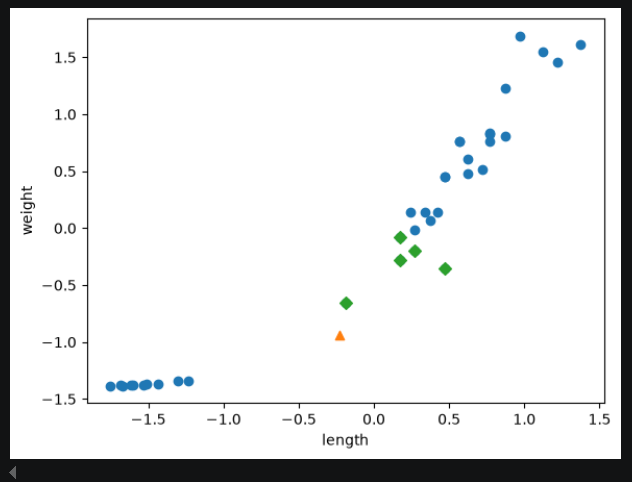
print(kn.predict([new]))이제 이웃들은 어떻게 구성되었는지 시각화해보겠습니다.
distances, indexes = kn.kneighbors([new])

plt.scatter(train_scaled[:, 0], train_scaled[:, 1])
plt.scatter(new[0], new[1], marker='^')
plt.scatter(train_scaled[indexes, 0], train_scaled[indexes, 1], marker='D')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()