사이킷런을 이용한 회귀 문제
회귀는 임의의 어떤 숫자를 예측하는 문제로써, 여기서는 농어(Perch)의 길이, 높이, 두께로 무게로 예측합니다.
KNN 회귀(Regression) 알고리즘을 사용하며 분류(Classification) 알고리즘과 비슷한 방식입니다.
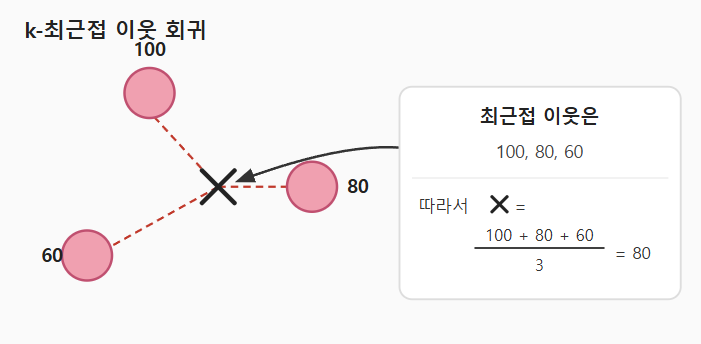
예측하려는 샘플에 가까운 샘플 k개를 선택하고, 이 타겟들의 평균값을 구하면 됩니다.
먼저 임포트할 라이브러리들을 임포트합니다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import os
데이터셋을 불러올 베이스 폴더 path를 불러옵니다.
base_path = r'C:\Users\haruka\Desktop\AI수업\mcp-month-2\data'이를 바탕으로 데이터셋을 DataFrame 형태로 불러옵니다.
file_path = os.path.join(base_path, 'fish.csv')
fish_df = pd.read_csv(file_path)
이제 농어의 길이(Length, feature)가 주어졌을 때 무게(weight, target)을 예측해보겠습니다.
먼저 농어의 길이와 농어의 무게를 각각 feature, target으로 뽑아오겠습니다.
perch_length = fish_df[fish_df.Species == 'Perch']['Length'].values
perch_weight = fish_df[fish_df.Species == 'Perch']['Weight'].values
이 데이터들을 산점도로 시각화해보겠습니다.
plt.scatter(perch_length, perch_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()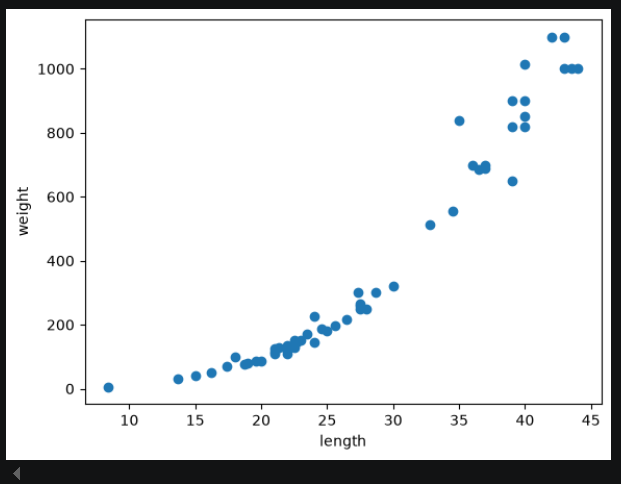
연관성이 포물선 형태의 관계로 나타남을 확인했습니다.
이제 데이터를 train과 test 셋으로 나누겠습니다.
from sklearn.model_selection import train_test_spli

train_input, test_input, train_target, test_target=\
train_test_split(perch_length, perch_weight, random_state=42)
여기서 기본적으로 train : test 비율은 3 : 1입니다. 실제로 맞는지 확인해봅니다.
print(train_input.shape, test_input.shape) # (42,) (14,)여기서 또 명심할 점은 사이킷런에서 입력할 데이터는 항상 features들의 벡터여야 합니다.
즉 2차원 배열 형태여야 합니다.
train_input = train_input.reshape(-1, 1) # (42, 1)
test_input = test_input.reshape(-1, 1) # (14, 1)
진행하기에 앞서 나중에 점수를 매길 때 영향을 받는 결정 계수에 대해 알아보겠습니다.
먼저 여기서 점수를 확인하는데 사용할 클래스는 KNeighborsRegressor 회귀 클래스입니다.
여기서도 n_neighbors의 기본값은 5입니다.
from sklearn.neighbors import KNeighborsRegressor이제 모델을 생성합니다.
knr = KNeighborsRegressor()이제 fit() 함수를 통해 K-최근접 이웃 회귀 모델을 통해 학습합니다.
knr.fit(train_input, train_target)이제 test 점수를 확인합니다.
knr.score(test_input, test_target) # 0.992809406101064이 점수에 정체에 대해 알아보면, 분류 문제 같은 경우 test 세트의 샘플을 정확하게 분류한 개수의 비율입니다.
하지만 회귀 문제는 정확한 숫자를 맞춘다는 것이 거의 불가능하여 이 평가방식을 결정계수라고 부릅니다.
간단히 R² 이라고도 부릅니다. 이 값은 다음과 같이 계산합니다.
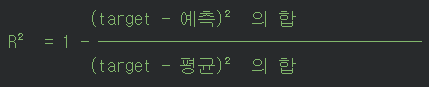
만약 타겟의 평균 정도를 예측하는 숫자이라면 분자와 분모가 비슷해져, R²은 0에 가까워집니다.
만약 예측이 타겟에 가까워지면 분자가 0에 가까워져 R²은 1에 가까워집니다.
그렇다면, train 데이터를 사용하여 R²의 점수를 확인해보겠습니다.
knr.score(train_input, train_target) # 0.9698823289099254훈련 데이터 점수가 테스트 데이터 점수보다 더 낮게 나옵니다. 이것을 과소적합(underfit) 되었다고 합니다.
사실 머신러닝 학습의 목표는 테스트 세트의 높은 점수지만
훈련 데이터에서의 점수가 높았는데 테스트 세트에서의 점수가 그보다 낮다면 이것은 **과대적합(overfit)**입니다.
즉, 모델이 훈련 세트에만 잘 맞는 모델로 학습된 것으로, 새로운 데이터에 대한 예측할 때 잘 동작하지 않습니다.
반대로, 훈련 데이터보다 테스트 세트의 점수가 높거나, 두 점수가 너무 낮은 경우는 **과소적합(underfit)**입니다.
즉, 모델이 너무 단순하여 훈련 세트에 적절히 훈련되지 않은 경우입니다.
해결을 위해 knn 알고리즘에서 모델의 복잡도를 높이는 방법은 이웃의 개수를 좀 더 줄이는 것입니다.
이웃의 개수를 줄이면 훈련 세트에 있는 가까운 곳에 있는 패턴에 더 민감하게 반응하기 때문입니다.
따라서 이웃의 개수를 3으로 줄이겠습니다.
knr.n_neighbors = 3다시 모델을 훈련하고, 훈련 데이터의 점수를 확인해보겠습니다.
knr.fit(train_input, train_target)
print(knr.score(train_input, train_target)) # 0.9804899950518966
k값을 줄였더니 훈련 데이터의 점수가 올라갔습니다. 이제 테스트 데이터의 점수도 확인해봅니다.
knr.score(test_input, test_target) # 0.9746459963987609결과적으로 높으면서도 훈련 데이터보다는 낮은 점수로 나왔습니다. 따라서 underfit 문제를 해결했습니다.
그래서 단순한 모델과 복잡한 모델에 따른 변화를 시각화해보겠습니다.
먼저 k-최근접 이웃 회귀 객체를 만들고 농어(Perch)의 Length를 5에서 45까지 x좌표를 만듭니다.
knr = KNeighborsRegressor()
x = np.arange(5, 45).reshape(-1, 1)
그리고, n값을 1일 때 5일 때 10일 때 예측 결과를 그래프로 그립니다.
for n in [1, 5, 10]:
  knr.n_neighbors = n
  knr.fit(train_input, train_target)
  prediction = knr.predict(x)

  plt.scatter(train_input, train_target)
  plt.plot(x, prediction)

  plt.title('n_neighbors = {}'.format(n))
  plt.xlabel('length')
  plt.ylabel('weight')
  plt.show()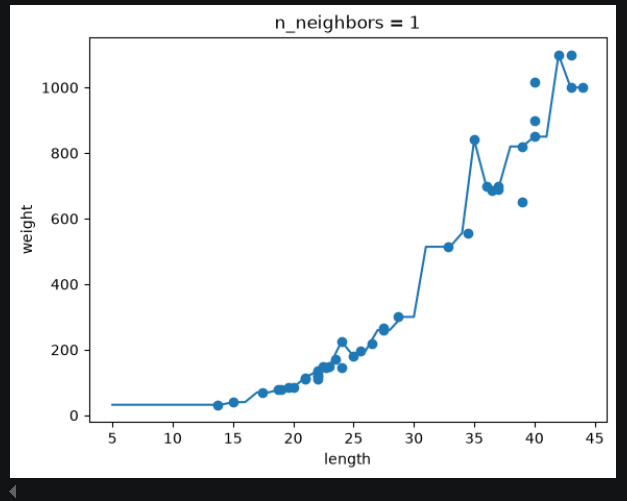
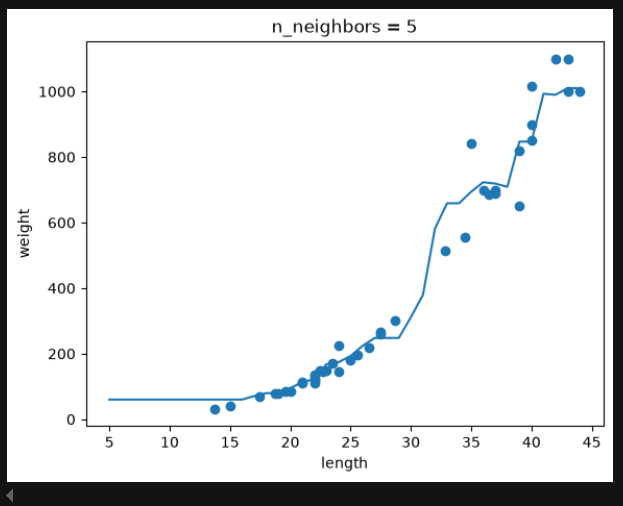
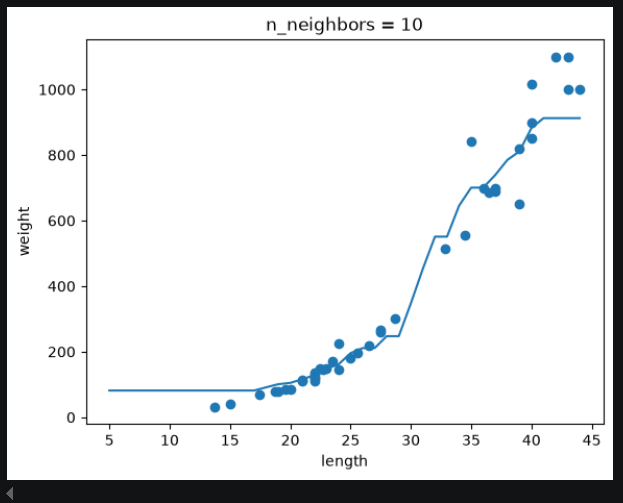
n = 1 일때는 국지적인 패턴 (이웃값의 패턴)을 잘 따르는 모습입니다. 모델의 복잡도가 올라간 겁니다.
n = 5 일 때는 조금 더 일반적인 패턴으로 갑니다.
n = 10 일 때는 더 일반화가 됩니다.
이를 바탕으로, 길이가 50cm인 농어(Perch)를 예측해봅니다.
이웃의 개수를 3으로 하는 회귀 모델로 예측해보겠습니다.
knr = KNeighborsRegressor(n_neighbors=3)
knr.fit(train_input, train_target)
그리고 길이가 50cm인 농어를 예측합니다.
print(knr.predict([[50]])) # 1033.3333333그러나 실제로는 무게가 훨씬 더 많이 나간다고 합니다. 이렇게 정확도가 낮은 이유는 무엇일까요?
그래서 train 세트와 50cm 농어, 농어의 knn 이웃들을 scatterplot으로 시각화해보겠습니다.
distances, indexes = knr.kneighbors([[50]])

plt.scatter(train_input, train_target)
plt.scatter(train_input[indexes], train_target[indexes], marker='D')
plt.scatter(50, 1033.33333, marker='^')

plt.xlabel('length')
plt.ylable('weight')
plt.show()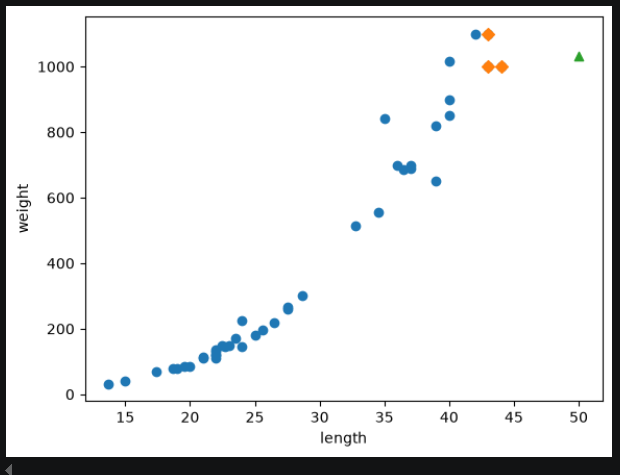
가장 가까운 이웃들 3개의 평균이 1033이 나와 1033으로 예측한 겁니다.
하지만 농어의 데이터 증가 추세를 반영하지 못하는 모습입니다.
그래서, 길이가 100cm인 농어도 이웃값이 동일할 것이므로 이것 역시 1033으로 예측할 것입니다.
따라서 이것이 knn Regressor의 한계입니다. 즉 이 문제를 해결하려면 length가 더 큰 농어의 데이터를 포함하여 구성해야 합니다.
그래서 알고리즘을 **선형 회귀 알고리즘(Linear Regression)**으로 바꾸어 보겠습니다.
어떤 특성을 잘 나타내는 직선의 방정식을 학습함으로써 최적의 기울기값과 최적의 절편값을 찾아내는 것입니다.
LinearRegression을 먼저 임포트합니다.
from sklearn.linear_model import LinearRegression선형 회귀 모델로 훈련하겠습니다.
lr = LinearRegression()
lr.fit(train_input, train_target)
이제 50cm 농어에 대해 예측해보겠습니다.
print(lr.predict([[50]])) # [1241.83860323]아까 1033g에 비해 1241g으로 더 무거운 무게로 예측되었습니다.
이 원리는 농어의 무게를 예측하는 직선을 학습하고 그것은 아래와 같습니다.
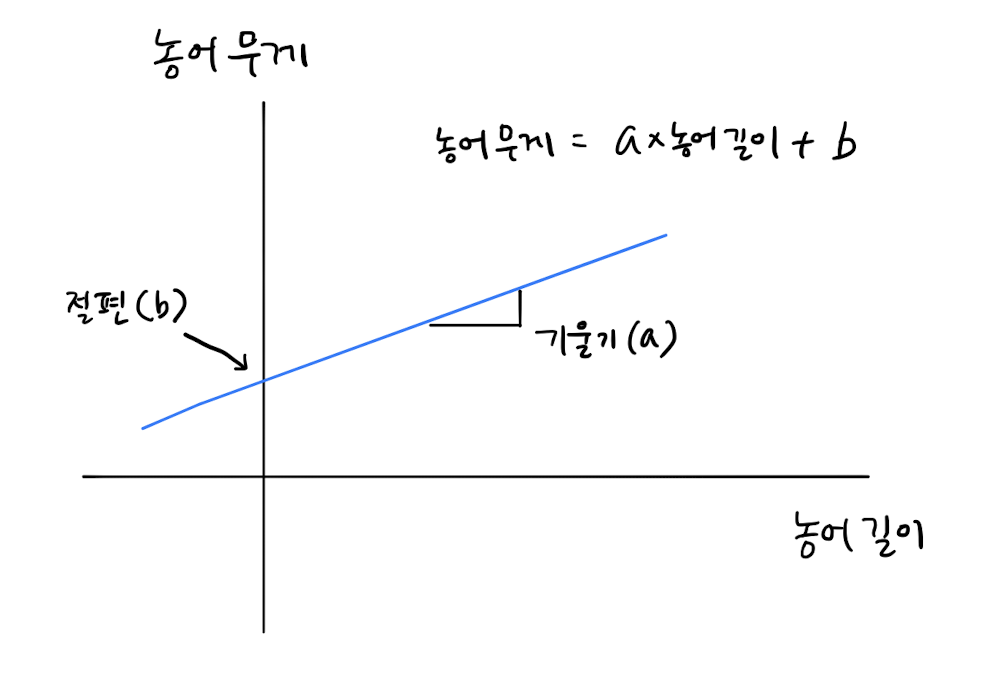
LinearRegrssion이 찾은 기울기는 coef_로 찾을 수 있고, 이는 가중치(Weight)이라고도 부릅니다.
print(lr.coef_) # [39.01714496]LinearRegression이 찾은 절편은 intercept_로 찾을 수 있습니다.
print(lr.intercept_) # -709.0186449535474이 직선을 한번 시각화해보겠습니다.
plt.scatter(train_input, train_target)
plt.plot([15, 50], [15 * lr.coef_ + lr.intercept_, 50 * lr.coef_ + lr.intercept_ ])
plt.scatter(50, 1241.8, marker='^')

plt.xlabel('length')
plt.ylabel('weight')
plt.show()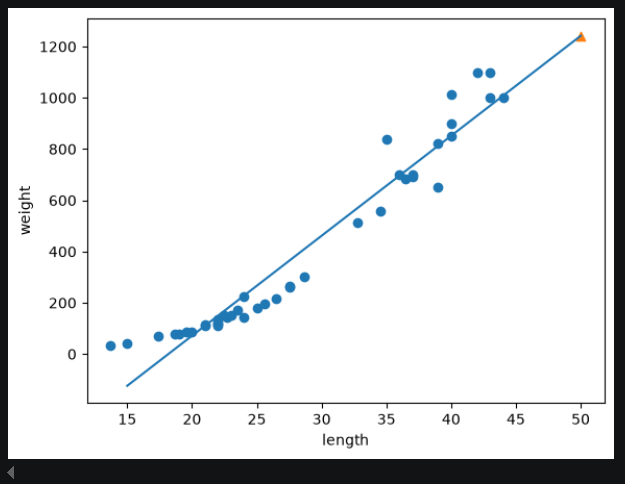
여러가지 데이터를 표현하는 직선을 학습한 후 그 직선에 따라 데이터를 예측하는 형태가 됩니다.
이제 점수를 확인해보겠습니다.
print(lr.score(train_input, train_target)) # 0.9398463339976041
print(lr.score(test_input, test_target)) # 0.824750312331356
너무 훈련 데이터와 테스트 데이터의 점수 차이가 너무 많이 납니다. 그리고 훈련 데이터 점수도 높지 않습니다.
따라서 둘다 낮은 점수이므로, underfit이라고 보는 것이 적합합니다.
위의 시각화 그래프를 다시 봤을 때 데이터 분포도를 보면 직선보다는 곡선에 가깝습니다.
따라서, 직선의 방정식으로는 곡선을 표현하기엔 부족함이 많다는 것입니다.
즉, 2차 방정식의 곡선을 생각해보겠습니다.
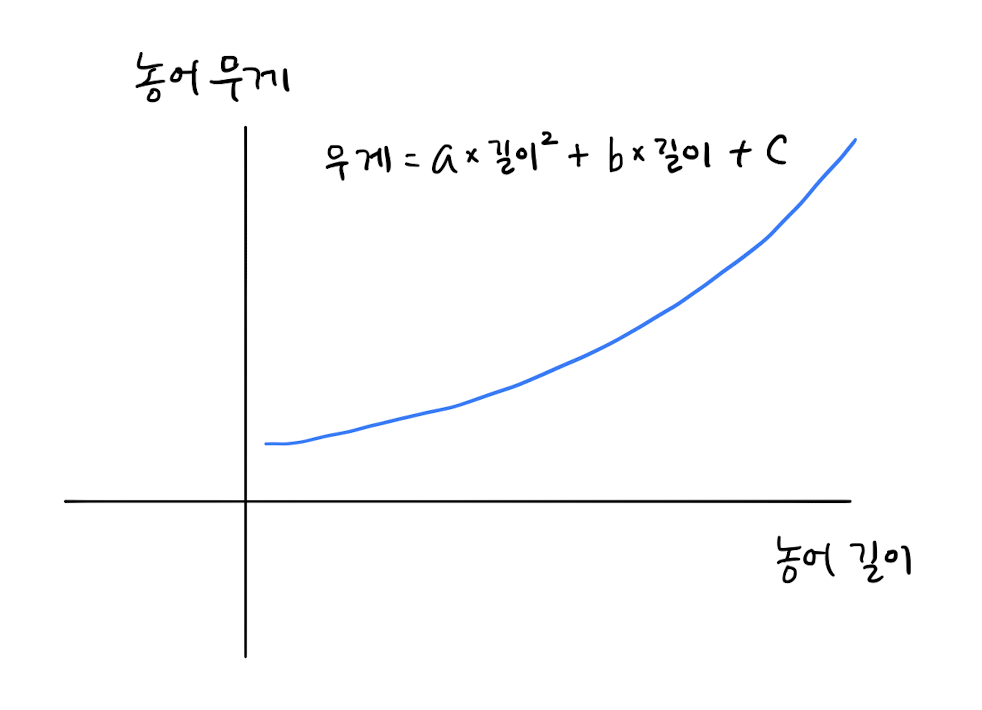
여기서 길이의 항 뿐만 아니라 길이의 제곱에 대한 항도 생겨야 합니다. 넘파이를 이용해 튜플 형태로 만듭니다.
train_poly = np.column_stack((train_input ** 2, train_input))
test_poly = np.column_stack((test_input ** 2, test_input))
shape를 확인해보면 다음과 같습니다.
print(train_poly.shape, test_poly.shape) # (42, 2) (14, 2)이제 train_poly를 활용해 선형 회귀 모델을 다시 훈련해봅니다. 타겟값만 그대로 사용합니다.
lr = LinearRegression()
lr.fit(train_poly, train_target)
이제 다시 농어(Perch)를 예측해봅니다. 전달할 때도 2개를 입력해야합니다.
print(lr.predict([[50 ** 2, 50]])) # [1573.98423528]이렇게 2차 방정식은 직선 형태가 아니지만 선형식으로 표현할 수 있으므로 다항회귀라고 부릅니다.
이것을 시각화해보겠습니다.
point = np.arange(15, 50)

plt.scatter(train_input, train_target)

plt.plot(point, 1.01 * point ** 2 - 21.6 * point + 116.05)

plt.scatter([50], [1574], marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()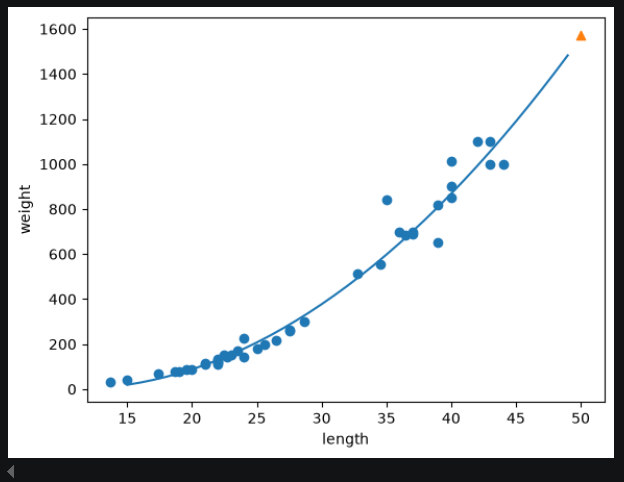
포인트들을 잘 표현하는 이차방정식 곡선이 잘 만들어졌습니다.
이것을 기반으로 점수들을 확인해보겠습니다.
print(lr.score(train_poly, train_target)) # 0.9706807451768623
print(lr.score(test_poly, test_target)) # 0.9775935108325122
전반적으로 점수가 1.0에 가까워지고, 점수도 비슷해졌습니다.
추가적으로, 무게 예측에 영향을 주는 건 Length 뿐만 아니라 Height 및 Width도 있습니다.
이것 처럼 여러개의 특성을 사용한 선형 회귀를 다중 회귀라고 하고, 특성이 2개이면 평면을 학습하게 됩니다.
이 때 선형회귀 방정식은 a * feature1 + b * feature2 + c의 평면이 될 것입니다.
특성이 3개 이상이면, 그림으로는 그릴 수 없는 초평면이 될 것입니다.
또한, 하나의 특징을 사용해 기존의 특성을 뽑아내는 작업 즉, 앞서 보았던 특성의 제곱 같은 것을 특성 공학이라고 합니다.
예를 들어 농어(Perch)의 길이 뿐만 아니라 높이와 두께도 함께 사용하는데
각 특성을 서로 곱해서 또 다른 특성도 만들어볼 수 있습니다.
먼저 농어의 길이, 높이, 두께를 가져옵니다.
perch_df = fish_df.loc[fish_df.Species == 'Perch', ['Length', 'Height', 'Width']]이것을 넘파이 배열로 변환합니다.
perch_full = perch_df.to_numpy()정답 데이터는 다음과 같습니다.
perch_weight그리고, perch_full을 쪼개보겠습니다.
train_input, test_input, train_target, test_target=\
train_test_split(perch_full, perch_weight, random_state=42)
shape를 확인하면 feature가 3개임을 확인가능합니다.
print(train_input.shape, test_input.shape) # (42,3) (14,3)추가적으로 사이킷런에서 특성을 만들거나 전처리하기 위해 transformer 클래스를 제공합니다.
transformer 클래스도 fit() 함수와, transform() 함수가 있습니다.
이를 기반으로, PolynomialFeatures 클래스 변환기를 불러옵니다.
from sklearn.preprocessing import PolynomialFeatures일단 이 클래스가 어떻게 동작하는지 관찰해보기 위해 2개의 특성인 2, 3으로 이루어진 샘플을 적용시켜봅니다.
먼저 클래스를 저장합니다.
poly = PolynomialFeatures()그리고, 2개의 샘플 특성들을 적용해보겠습니다.
poly.fit([[2, 3]])적용한 데이터를 가지고 변환기를 작동합니다.
print(poly.transform([[2, 3]])) # [[1. 2. 3. 4. 6. 9.]]최종적으로 [2, 3] 이 [1, 2, 3, 4, 6, 9]로 변환된 것입니다.
기본적으로 각 특성을 제곱한 항을 추가하고, 특성끼리 곱한 항을 추가하고 절편까지 추가하는 것입니다.
만약 1인 절편을 빼고 싶다면 include_bias = False를 지정하세요.
poly = PolynomialFeatures(include_bias=False)
poly.fit([[2, 3]])
print(poly.transform([[2, 3]])) # [[2. 3. 4. 6. 9.]]
이제 이 방식으로 train_input에 적용합니다.
poly = PolynomialFeatures(include_bias=False)
poly.fit(train_input)
이제 데이터를 변환기에 넣어 저장하고 확인해보겠습니다.
train_poly = poly.transform(train_input)
train_poly.shape # (42, 9)
이 PolynomialFeatures 클래스는 9개의 특성이 어떻게 만들어졌는지도 제공합니다.
poly.get_feature_names_out()
이렇게 변환기는 전처리 관련된 것들인데, 이것을 다룰 때는 항상 훈련 세트를 기준으로 fit()를 수행하고
그렇게 Fitting된 객체로 나머지 테스트 세트를 변환하는 습관을 들여야 합니다.
최종적으로 점수를 확인해보겠습니다.
lr = LinearRegression()
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target)) # 0.9903557670312702
print(lr.score(test_poly, test_target)) # 0.971376207461857
여러 개의 특성을 추가하고, 조합하니 점수가 더 올라간 모습을 볼 수 있었습니다.
그러면 5제곱까지 늘려서 특성을 만들어보겠습니다.
poly = PolynomialFeatures(degree=5, include_bias=False)
poly.fit(train_input)
train_poly = poly.transform(train_input)
test_poly = poly.transform(test_input)

print(train_poly.shape) # (42, 55)
print(test_poly.shape) # (14, 55)
이제 점수를 확인해봅니다.
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target)) # 0.9999999999
print(lr.score(test_poly, test_target)) # -129.xxxxxxx
훈련 데이터는 잘 맞추지만, 테스트 데이터에는 잘 적응하지 못하는 모습으로, 이를 과적합(overfit)이라고 합니다.
즉, 머신러닝 모델 개발에 있어서 자주 overfit되는 경우 어떻게 안정화 시킬 수 있을지 고민하게 됩니다.
그로 인해 나온 개념이 규제(Regularization)입니다.
머신러닝 모델이 훈련 세트를 너무 과도하게 학습하지 못하도록 훼방하는 것입니다.
선형 회귀 모델의 경우 특성에 곱해지는 계수, 즉 기울기의 크기를 작게 만드는 것입니다.
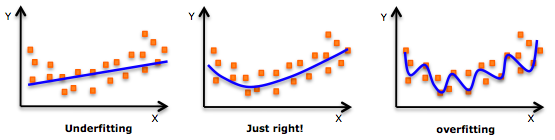
그리고 고려해야 할 것이 특성의 스케일(Scale)도 고려를 해야 합니다.
스케일(Scale)이 정규화되지 않으면, 여기에 곱해지는 계수 값 즉 기울기의 값도 차이가 나지 않고
계수의 값의 크기가 너무 다르면 공정하게 제어되지 않습니다. 따라서 먼저 정규화가 필요합니다.
여기서는 StandardScaler 변환기를 사용하겠습니다.
from sklearn.preprocessing import StandardScaler스케일러 변환기 클래스를 가져온 후, 훈련 데이터에 대해 fit()을 합니다.
ss = StandardScaler()
ss.fit(train_poly)
이제 Scaler 객체는 각 feature에 대한 표준화된 점수를 가지게 됩니다.
이제 Scaler의 transform() 함수로 변환을 합니다.
train_scaled = ss.transform(train_poly)
test_scaled = ss.transform(test_poly)
이제 학습한 평균과 표준편차는 이 객체의 mean_과 scale_ 속성에 저장됩니다.
따라서 총 55개의 평균과 표준편차가 들어있습니다.
이제 이걸 기반으로 규제 알고리즘을 적용하는데 릿지 모델과 라쏘 모델이 있습니다.
릿지는 계수의 제곱한 값을 기준으로 규제를 적용하고, 라쏘는 계수의 절댓값을 기준으로 규제를 적용합니다.
먼저 릿지 회귀(Ridge Regression)을 적용합니다.
from sklearn.linear_model import Ridge릿지 객체를 불러온 후 fit() 함수를 통해 학습합니다. 또한, 점수까지 확인합니다.
ridge = Ridge()
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target)) # 0.9896217956447125
print(ridge.score(test_scaled, test_target)) # 0.9788853860988027
점수가 비슷하게 조절되므로, 규제가 정확히 적용되었습니다.
그리고, 규제의 강도 조절을 위해 alpha 파라미터를 사용할 수 있습니다. 이를 하이퍼파라미터라고 합니다.
하이퍼파라미터는 훈련 전에 직접 지정해주어야 하는 셋팅값입니다.
적절한 aplha 값을 찾는 한 가지 방법은 aplha 값에 대한 결정계수 값의 그래프를 그려보고
훈련 세트와 테스트 세트의 점수가 가장 가까운 지점의 최적의 alpha 값이 되는 것입니다.
alpha 값을 0.001에서부터 100까지 10배씩 늘려가며 릿지 모델을 훈련한 다음
훈련 세트와 테스트 세트의 점수를 파이썬 리스트에 저장해보겠습니다.
먼저 저장할 리스트 변수를 준비합니다.
train_score = []
test_score = []
이제 alpha_list를 바꿔가며 훈련합니다.
alpha_list = [0.001, 0.01, 0.1, 1, 10, 100]

for alpha in alpha_list:
  ridge = Ridge(alpha=alpha)
  ridge.fit(train_scaled, train_target)
  train_score.append(ridge.score(train_scaled, train_target))
  test_score.append(ridge.score(test_scaled, test_target))
그리고 이것을 시각화 해보겠습니다.
plt.plot(np.log10(alpha_list), train_score)
plt.plot(np.log10(alpha_list), test_score)

plt.xlabel('alpha')
plt.ylabel('R^2')
plt.show()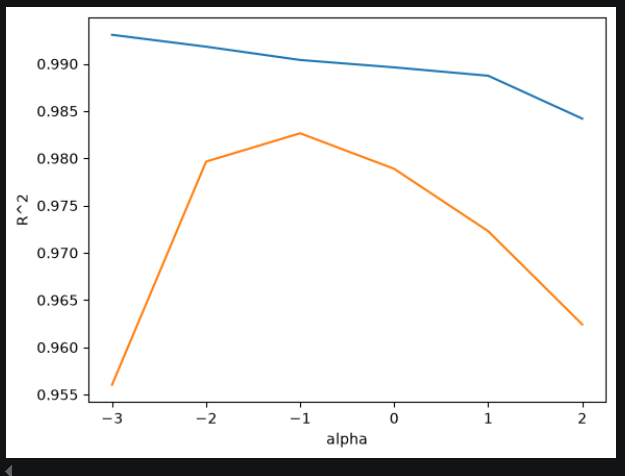
가장 왼쪽 부분은 훈련 데이터 점수는 높고, 테스트 데이터 점수는 낮은 overfit 부분입니다.
가장 오른쪽 부분은 둘다 점수가 낮아지므로, underfit 부분입니다.
가장 좋은 alpha 값은 둘의 간극이 제일 좁혀지는 log10(alpha)값이 -1인 경우입니다.
이렇게 찾은 최적의 alpha 값을 Ridge 규제 클래스에 적용시킵니다.
ridge = Ridge(alpha=0.1)
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target)) # 0.99....
print(ridge.score(test_scaled, test_target)) # 0.98....
어느 정도 균형이 맞혀진 모습을 확인할 수 있었습니다.
두번째는 라쏘 모델(Lasso Regression) 입니다.
from sklearn.linear_model import Lasso이번에도 적절한 alpha 값을 찾아보겠습니다.
여기서 max_iter 파라미터는 라쏘 모델이 최적의 계수를 찾기 위해 수행하는 반복적인 계산의 횟수입니다.
train_score = []
test_score = []

alpha_list = [0.001, 0.01, 0.1, 1, 10, 100]

for alpha in alpha_list:
  lasso = Lasso(alpha=alpha, max_iter=10000)
  lasso.fit(train_scaled, train_target)
  train_score.append(lasso.score(train_scaled, train_target))
  test_score.append(lasso.score(test_scaled, test_target))
이것을 시각화합니다.
plt.plot(np.log10(alpha_list), train_score)
plt.plot(np.log10(alpha_list), test_score)
plt.xlabel('alpha')
plt.ylabel('R^2')
plt.show()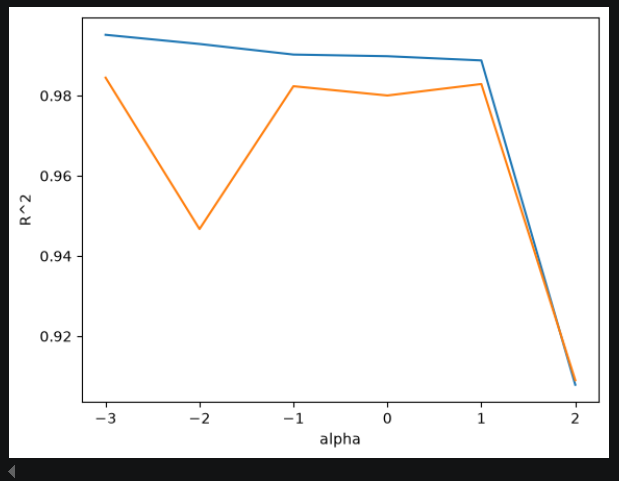
앞서 살펴본 것과 같이 log 값이 1일 때 둘이 차이가 가장 줄어드므로, 이때가 최적의 값입니다.
그래서 최적의 alpha 값으로 훈련하겠습니다.
lasso = Lasso(alpha=10)
lasso.fit(train_scaled, train_target)

print(lasso.score(train_scaled, train_target)) # 0.9888...
print(lasso.score(test_scaled, test_target)) # 0.9823...
따라서 이 때 점수값이 거의 차이가 없음을 확인했습니다.
이렇게 학습된 모델의 모델 계수 값을 아예 0으로 만들수도 있는데, 그 개수를 살펴봅시다.
print(np.sum(lasso.coef_ == 0)) # 40즉 앞서 살펴본 55개의 항중에 40개는 쓸모없는 항이었다는 뜻입니다.
최종적으로 필요한 항과 필요하지 않은 항을 구분해내는데에도 도움이 되었습니다.