로지스틱 회귀(Logistic Regression)
로지스틱 회귀 알고리즘을 통해 이진 및 다중 분류 문제에서 확률을 예측해야 합니다.
생선의 특성들 즉, 길이 / 높이 / 두께 / 대각선 / 무게 등을 활용하여 생선의 종류를 예측할 것입니다.
일단 이전 포스팅에서 배웠던 kNN 알고리즘을 살펴보겠습니다.
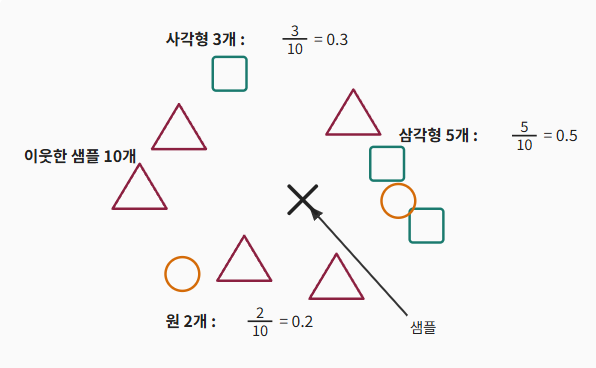
kNN 알고리즘은 주변의 이웃을 찾아주므로, 이웃의 클래스 비율을 분류 확률로 삼아도 되는지 살펴봅니다.
먼저 데이터를 준비해보겠습니다.
생선은 현재 7가지 종류였습니다.
fish_df.Species.unique()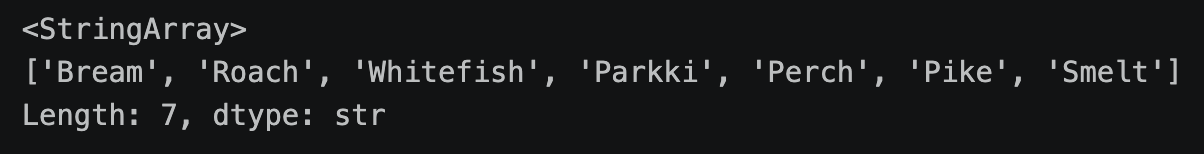
그리고 생선들의 features를 의미하는 컬럼들은 다음과 같습니다.
fish_df.columns
이제 Species 컬럼을 빼고 나머지 컬럼들을 인풋 데이터로 선택합니다.
fish_input = fish_df[['Weight', 'Length', 'Diagonal', 'Height', 'Width']].to_numpy()상위 5개의 인풋 데이터는 다음과 같습니다.
fish_input[:5]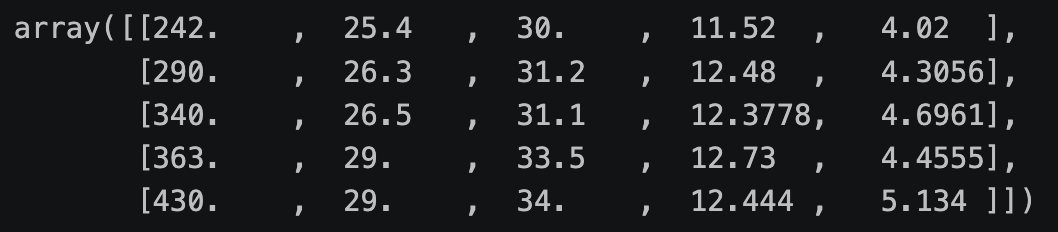
그리고 타겟 데이터는 Species 컬럼을 선택합니다.
fish_target = fish_df['Species'].to_numpy()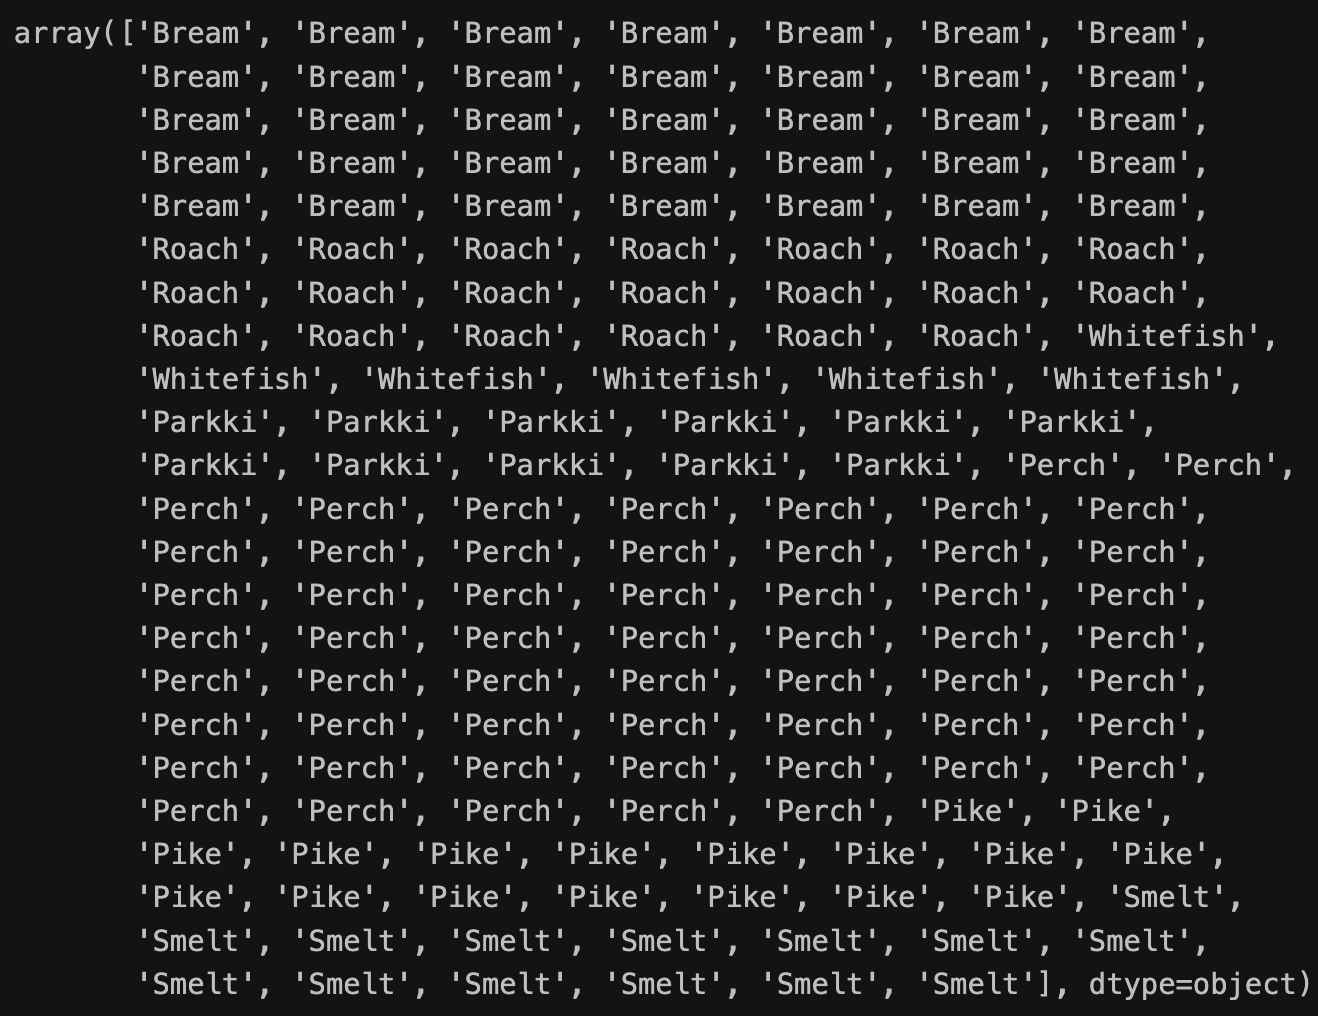
그리고, 훈련용 데이터와 테스트용 데이터를 분리합니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target =\
train_test_split(fish_input, fish_target, random_state=42)
그리고, shape를 확인하면 다음과 같습니다.
print(train_input.shape, test_input.shape) # (119, 5) (40, 5)그리고, feature들의 범위가 각각 다를 것이므로, 범위들을 표준화하겠습니다.
from sklearn.preprocessing import StandardScaler

ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
원본 훈련 데이터와 표준화된 훈련 데이터를 비교해봅니다.
train_input[:5]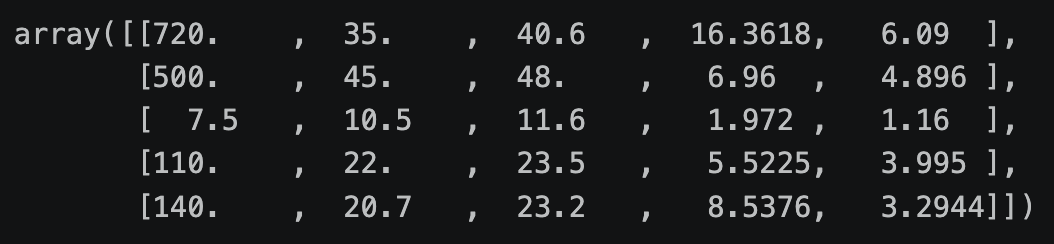
train_scaled[:5]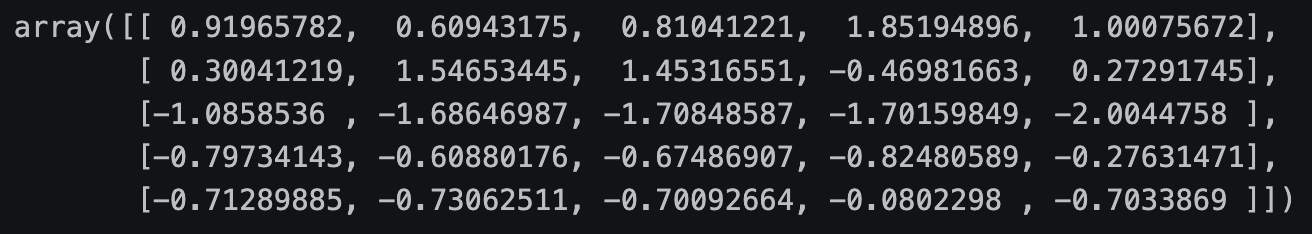
본격적으로, kNN 분류기로 확률을 예측해보겠습니다. n_neighbors는 3으로 설정합니다.
from sklearn.neighbors import KNeighborsClassifier

kn = KNeighborsClassifier(n_neighbors=3)
kn.fit(train_scaled, train_target)
특이점은 타겟 데이터값들이 문자열로 이루어져 있는데 학습이 된다는 점입니다. 이것은 사이킷런의 특별한 기능입니다.
그리고, 훈련 점수와 테스트 점수를 확인해보겠습니다.
print(kn.score(train_scaled, train_target)) # 0.8907563025210085
print(kn.score(test_scaled, test_target)) # 0.85
점수가 만족스럽지 않지만, 일단 잠시 놔두겠습니다.
일단 이와 같이 타겟 데이터에 2개 이상의 클래스가 있는 분류 문제를 다중 분류 문제라고 합니다.
이것중 타겟 데이터에 2개의 클래스가 있는 경우를 이진 분류라고 합니다.
이진 분류에서는 보통 타겟 데이터를 0 또는 1 값으로 표현합니다.
다중 분류에서도 숫자로 데이터를 표현할 수 있습니다. 하지만 여기서는 문자열로 표현되므로, 순서가 알파벳 순으로 정렬됩니다.
원본 데이터의 타겟 값의 정렬 순서는 아래와 같습니다.
pd.unique(fish_df['Species'])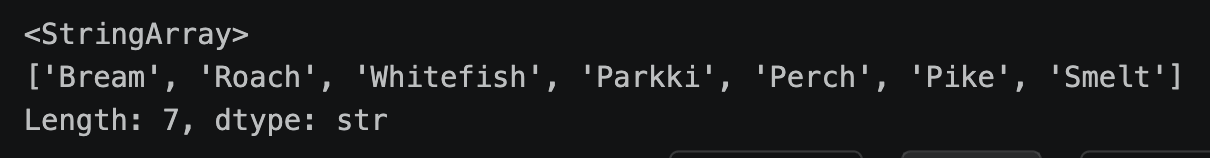
KNeighborsClassfier가 정렬한 타겟 값의 정렬 순서는 아래와 같습니다.
kn.classes_
보면 순서가 다릅니다. KNeighborsClassfier는 알파벳 순으로 정렬합니다.
그러면 처음 5개 샘플의 타겟 값을 예측해보겠습니다.
kn.predict(test_scaled[:5])
그러면 실제 답안과 비교해보겠습니다.
test_target[:5]
그러면 각각에 대해 어떤 원리를 7가지 중 하나를 예측했을까요? 바로 클래스별 확률값입니다.
proba = kn.predict_proba(test_scaled[:5])

print(kn.classes_)

print(np.round(proba, decimals=4))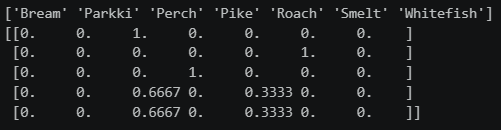
첫번째, 두번째, 세번째 샘플은 모두 각각 Perch, Smelt, Pike일 확률이 100%입니다.
네번째, 다섯번째 샘플은 66%의 확률로 Perch를 예측했습니다. 그러나, 네번째 샘플은 틀린 것입니다.
그러면 네번째 샘플에 대한 이웃 클래스를 확인해보겠습니다.
distances, indexes = kn.kneighbors(test_scaled[3:4])

print(train_target[indexes])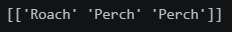
즉, 네번째 샘플 주변의 3개의 이웃 클래스 중 Perch의 확률이 높아 Perch로 예측한 것입니다.
이것은 확률값을 잘 예측하긴 했지만 딱 3개의 이웃만을 사용하여 가능한 확률의 경우의 수가 4개 뿐입니다.
이걸 확률이라고 말할 수 있을지 의문점이 생기기 시작합니다. 즉 연속적인 숫자값이 나오겠냐는 것이다.
즉 이게 kNN 분류기가 다중분류에서 가지는 약점입니다.
이를 위해 **로지스틱 회귀 알고리즘(Logistic Regression)**이 등장합니다.
이름은 회귀이지만, 내부적으로는 선형 방정식을 학습하는 분류 모델입니다.
다른 점은 출력값을 선형 방정식 값으로 하는 것이 아니라 분류 확률로 변환하여 출력을 합니다.
예시로, a x (weight) + b x (length) + c x (Diagonal) + d x (Height) + e x (Width) + f 같은 선형 방정식을 학습합니다.
이 값은 최종적으로 어떤 값도 가능하지만 확률이 되려면 0에서 1 사이의 값이 되어야 합니다.
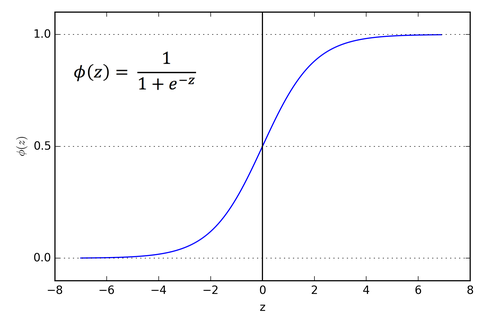
이를 위해 시그모이드 함수(Sigmoid) 또는 로지스틱 함수(Logistic)를 사용합니다.
시그모이드 함수란, 입력값이 양수이면 1.0에 가까워지고, 입력값이 음수면 0.0에 가까워지는 그래프 형태를 그립니다.
그러면 이제 로지스틱 회귀로 이진 분류를 해보겠습니다.
이진 분류일 경우, 시그모이드 함수의 출력이 0.5보다 크면 양성 클래스, 0.5보다 작으면 음성 클래스로 판단합니다.
Boolean Indexing을 사용하여 도미(Bream)과 빙어(Smelt)의 행만 골라냅니다.
bream_smelt_indexes = (train_target == 'Bream') | (train_target == 'Smelt')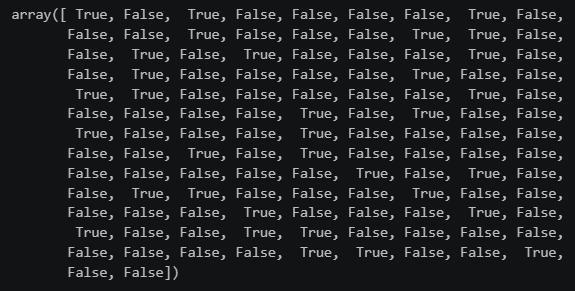
도미와 빙어 데이터로 train과 target 데이터를 준비합니다. 총 33개의 길이로 구성된 데이터입니다.
train_bream_smelt = train_scaled[bream_smelt_indexes] # (33, 5)
target_bream_smelt = train_target[bream_smelt_indexes] # (33,)
로지스틱 회귀 훈련을 위해 LogisticRegression 클래스를 불러옵니다.
from sklearn.linear_model import LogisticRegression그리고 훈련합니다.
lr = LogisticRegression()
lr.fit(train_bream_smelt, target_bream_smelt)
훈련한 모델을 사용하여 초반 5개의 샘플을 예측해봅니다.
print("예측: ", lr.predict(train_bream_smelt[:5]))
그리고 실제 값과 비교합니다.
print("실제: ", target_bream_smelt[:5])
5개의 예측 모두 일치했습니다. 그러면 예측확률을 출력해봅시다.
print(lr.classes_)
print(lr.predict_proba(train_bream_smelt[:5]))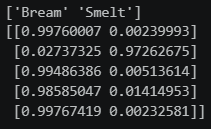
그리고, 학습한 계수들을 확인해보겠습니다.
print(lr.coef_, lr.intercept_)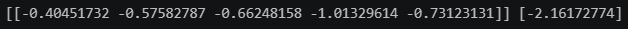
이 계수를 기반으로 한 방정식으로 z 값을 계산하는 함수인 decision_function()도 제공합니다.
처음 5개의 샘플의 z 값을 계산해봅니다.
decisions = lr.decision_function(train_bream_smelt[:5])
이것을 시그모이드 함수에 통과시키면 확률 값을 얻을 수 있습니다.
from scipy.special import expit
print(expit(decisions))
이것은 1번 클래스에 대한 z값입니다. 이진 분류의 경우, 양성 클래스에 대한 방정식 1개만 결과로 나옵니다.
이번에는 로지스틱 회귀로 다중 분류를 수행해보겠습니다.
내부적으로 로지스틱 회귀는 R2 규제 값이 있는데 C라는 파라미터로 규제를 제어합니다. 이 값이 작을수록 규제가 커집니다.
이제 7가지 생선 데이터가 모두 들어있는 train_scaled와 train_target을 사용하겠습니다.
lr = LogisticRegression(C=20, max_iter=1000) # 규제는 완화, 반복횟수를 늘림
lr.fit(train_scaled, train_target)
그리고 훈련 점수와 테스트 점수를 확인합니다.
print(lr.score(train_scaled, train_target)) # 0.93277....
print(lr.score(test_scaled, test_target)) # 0.925
나쁘지 않은 점수이므로, 테스트 세트의 초반 5개 데이터를 예측해보겠습니다.
print("예측:", lr.predict(test_scaled[:5]))
그리고 실제값과 비교합니다. 1개가 틀렸습니다.
print('실제:', test_target[:5])
그래서 이 5개 샘플에 대한 예측 확률을 뽑아보겠습니다.
proba = lr.predict_proba(test_scaled[:5])
proba_df = pd.DataFrame(data=np.round(proba, decimals=3), columns=lr.classes_)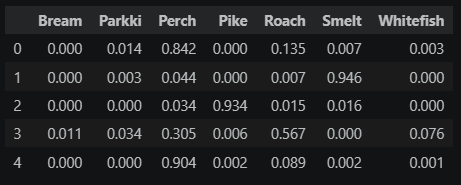
그리고 선형 방정식의 모습을 살펴보기 위해 계수를 알려주는 2차원 배열을 확인합니다.
lr.coef_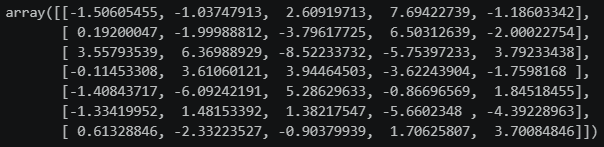
이진 분류때는 양성클래스만 계산했지만, 다중 분류에서는 클래스의 개수인 7개를 학습합니다.
또한 확률 변환도 이진 분류때는 시그모이드 함수를 활용했었습니다.
다중 분류에서는 소프트맥스 함수를 통해서 확률을 계산합니다.
소프트맥스의 함수는 클래스 개수인 7개의 z값을 확률로 변환하는데
여러 개의 선형방정식의 출력값을 0과 1 사이로 압축하고 전체 합이 1이 되도록 만듭니다.
이를 위해 지수함수를 사용하므로, 정규화된 지수함수라고도 합니다.
decision_function()으로 z1 ~ z7까지 구하고, 소프트맥스 함수를 통해 확률로 바꾸어보겠습니다.
decision = lr.decision_function(test_scaled[:5])
df = pd.DataFrame(data=np.round(decision, decimals=2), columns=lr.classes_)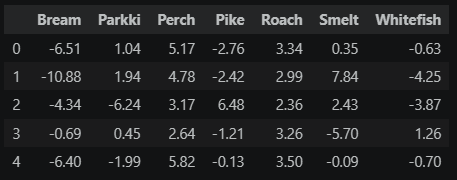
이제 소프트맥스 함수를 적용합니다.
from scipy.special import softmax

proba = softmax(decision, axis=1)
print(np.round(proba, decimals=3))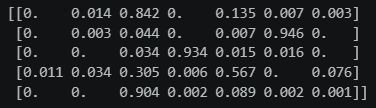
그리고 각 클래스별 확률을 모두 합하면 1입니다.
np.sum(proba, axis=1) # array([1., 1., 1., 1., 1.])정리해보면 생선의 여러 특성값을 통해 어떤 생선인지 예측 확률 구하는 문제에서
kNN 알고리즘의 문제는 확률을 출력할 수는 있지만, 이웃한 샘플의 클래스 비율이 항상 정해진 확률만 출력되었습니다.
반대로 로지스틱 회귀 분류 알고리즘은 선형 회귀처럼 선형 방정식을 사용하여 출력값을 시그모이드 함수에 통과시킵니다.
이를 양성 클래스의 확률로 0~1 사이의 값으로 변환합니다. 이는 이진 분류에서의 방법입니다.
반대로 다중분류의 경우는 클래스의 개수만큼 방정식을 훈련하여 소프트맥스 함수를 통과시켜 확률로 변환합니다.