확률적 경사 하강법 분류 알고리즘 - SGDClassifier
먼저 훈련 데이터는 항상 한번에 준비되는 경우는 실제로 거의 없습니다. 사실상 거의 불가능합니다.
이런 환경일 때 모델 학습과 적용을 어떻게 해야할까요?
첫번째 방법, 매일매일 새로 추가된 데이터를 기존 데이터에 더해서 다시 훈련하는 방법입니다.
이것의 단점으로는 시간이 지날수록 학습시킬 데이터의 크기가 늘어나 시간 및 메모리가 많이 듭니다.
두번째 방법, 새로운 데이터가 추가될 때마다 기존 데이터는 버리고, 새로운 데이터로만 학습하는 방법입니다.
데이터 크기는 일정량 유지가 되지만, 버리는 데이터가 발생해 중요한 데이터가 포함되지 않아 제대로 예측 불가합니다.
이것을 해결하기 위한 방법이 점진적 학습(Incremental Learning) 방법입니다.
이것은 기존의 훈련한 모델을 버리지 않고, 새로운 데이터에 대해서만 조금씩 더 훈련하는 방법입니다.
이렇게 함으로써 이전에 훈련했던 데이터를 모두 유지할 필요도 없고, 이전 학습 내용을 까먹지도 않을 것입니다.
그 중 대표적인 알고리즘이 SGD(Stochastic Gradient Descent) 방법입니다.
여기서 Stochastic의 의미는 확률적, 무작위하게, 랜덤하게 라는 의미입니다.
Gradient는 경사 즉 언덕의 기울기라는 의미입니다.
Descent는 기울기를 따라 내려가는 것입니다.
즉 훈련 세트를 이용해서 내려가는 방향을 찾아야 하는데, 시작점은 랜덤하게 시작된다는 의미입니다.
내려가는 방향으로 조금씩 움직여야 합니다.
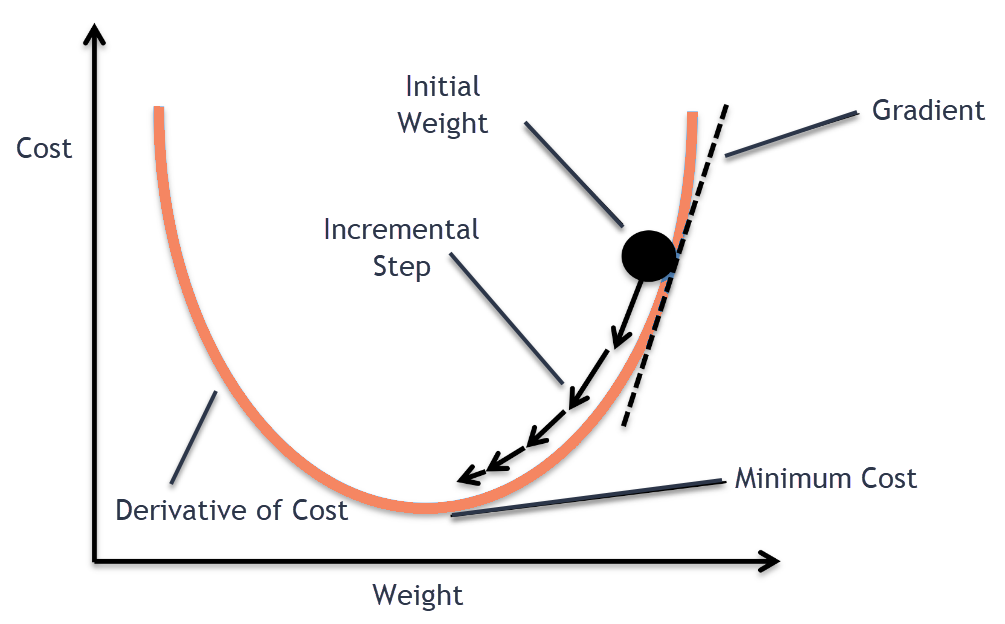
여기서 머신러닝의 목표는 Weight 파라미터 값이 변할 때 Cost 값이 낮아지는 방향을 찾는 것입니다.
이 때 Weight를 움직이려면 데이터를 입력하고, 정답하고 비교해서 움직여야 합니다.
내가 가진 데이터를 몇 개씩 집어넣어서 데이터를 업데이트 할지 고민입니다.
여기서 훈련 세트를 모두 집어넣고 업데이트하는 방법이 **에포크(epoch)**입니다. 또는 Full Batch라고도 합니다.
또는 훈련 데이터를 하나씩 집어넣으면서 업데이트할 수도 있습니다. 이것이 SGD의 방식입니다.
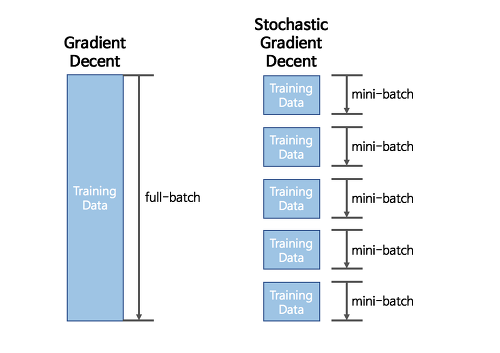
Full Batch로 하게되면, 우리의 목표점에 제일 방향을 잘 잡아서 이동합니다.
반면에, SGD 방식은 간혹 데이터에 이상치 같은 것들이 있을 수 있어 엉뚱한 곳으로 튈 수 있습니다.
그래서 오늘날 신경망에서는 절충안인 Mini-batch 방식을 많이 씁니다.
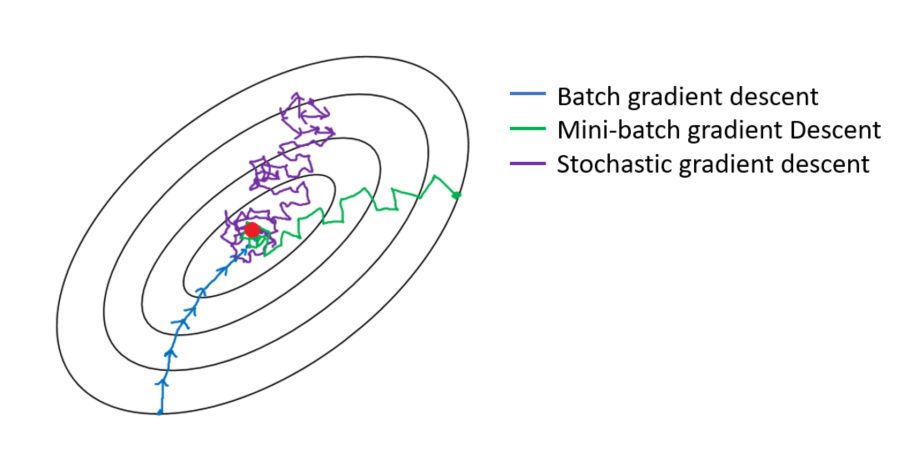
결론적으로 SGD 방식은 학습의 방향(기울기)이 엉뚱한 곳으로 내려갈 수 있는 위험성이 있어
한걸음씩 경사를 내려가는 방식인 Mini-batch 방식을 많이 사용합니다.
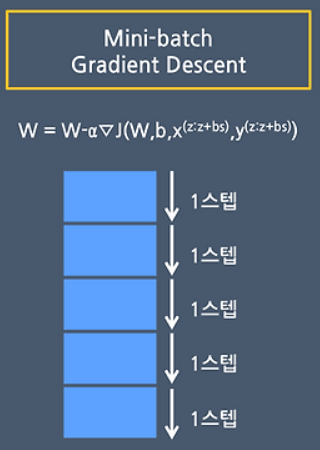
경사 하강 방식을 통해 낮은 Cost 값을 찾는 방식이라고 했는데, 여기서 손실값을 최소화 시켜야 합니다.
이 때 손실값을 계산하는 함수가 손실함수입니다. 얼마나 잘 못 맞추는지에 대한 값입니다. 즉 값이 작을수록 좋습니다.
그렇다면 분류에서의 손실 함수는 정확도로 정의할 수 있을까요? 그것은 불가능합니다.
정확도의 값은 제한적이고, 경사하강법은 아주 조금씩 내려와 연속적이어야 하기 때문입니다.
즉, 손실함수는 미분가능한 연속함수 형태여야 합니다.
여기서 사용하는 손실함수는 이진분류 때는 Logistic Loss Function입니다.
다중분류 때 사용하는 손실함수는 Cross-Entropy Loss Function입니다.
반대로 회귀문제에서는 평균 절대값 오차 함수(MAE)와 평균 제곱 오차 함수(MSE)를 많이 사용합니다.
이제 SGDClassfier를 다뤄보겠습니다.
먼저 입력 데이터와 타겟 데이터를 분리합니다.
fish_input = fish_df[['Weight', 'Length', 'Diagonal', 'Height', 'Width']].to_numpy()
fish_target = fish_df['Species'].to_numpy()
그리고 훈련용 데이터와 테스트용 데이터로 나눕니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target =\
train_test_split(fish_input, fish_target, random_state=42)
두 데이터의 shape를 확인합니다.
print(train_input.shape) # (119, 5)
print(test_input.shape) # (40, 5)
두 데이터를 표준화합니다.
from sklearn.preprocessing import StandardScaler

ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
이렇게 데이터 준비가 완료되었습니다.
이제 점진적 경사 방식을 사용하는 SGDClassifier 클래스를 불러옵니다.
from sklearn.linear_model import SGDClassifier이 생성자의 첫번째 매개변수는 loss로써 손실 함수의 종류입니다.
그 다음 매개변수는 max_iter로써 수행할 에포크(epoch) 횟수입니다.
그 다음 매개변수는 tol로써 일정 에포크동안 성능이 향상되지 않으면 자동으로 멈춥니다. 그 향상 %를 적어줍니다.
이제 SGDClassifier 객체를 만들 때 loss 파라미터와 max_iter 파라미터를 파라미팅 하겠습니다.
sc = SGDClassifier(loss='log_loss', max_iter=10, random_state=42)이제 훈련합니다.
sc.fit(train_scaled, train_target)이제 점수를 체크합니다.
print(sc.score(train_scaled, train_target)) # 0.7899159663865546
print(sc.score(test_scaled, test_target)) # 0.825
점수가 형편 없지만, 일단 그대로 진행해봅시다.
여기서 추가적인 학습을 하려면 사이킷런에서 partial_fit() 함수를 이용합니다.
이를 통해 점진적 학습이 가능한데, 모델을 다시 만들지 않고도 이미 훈련된 모델에 추가로 훈련합니다.
sc.partial_fit(train_scaled, train_target)에포크를 한 번더 실행했으므로, 점수 향상이 일어났는지 봅시다.
print(sc.score(train_scaled, train_target)) # 0.86...
print(sc.score(test_scaled, test_target)) # 0.875
에포크 하나 실행할 때마다 조금씩이지만 점수가 좋아지고 있습니다.
그럼 에포크를 무조건 많이 추가한다고 좋아질까요? 그건 아닙니다.
에포크의 과대적합(overfit)과 과소적합(underfit)에 대해 알아보겠습니다.
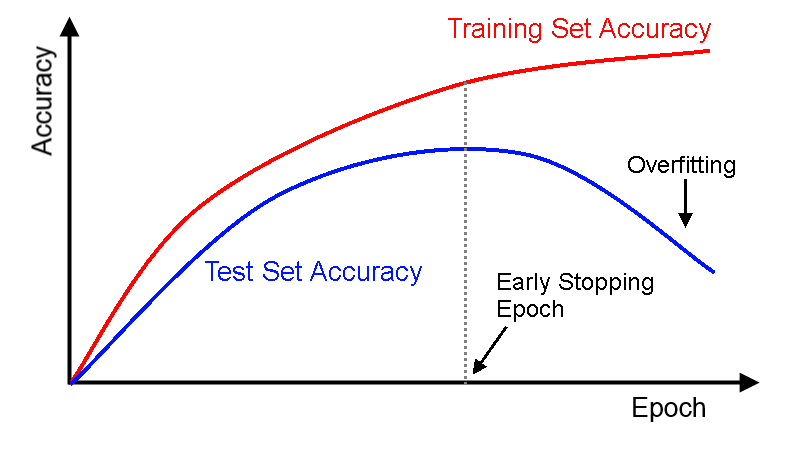
위의 그림을 살펴보면 에포크가 증가됨에 따라 훈련 데이터는 정확도가 같이 증가됩니다.
반면에 테스트 데이터는 에포크가 증가됨에 따라 일정 시간까지는 같이 늘어나다가, 어느 순간부터는 감소합니다.
간극이 벌어지는 이 때를 과대적합(overfit)이라고 합니다.
그리고 훈련 점수와 테스트 점수 모두 낮을 때를 과소적합(underfit)이라고 합니다.
그래서 이 적절한 시점 즉 테스트 점수가 하강하지 않는 시점을 찾는 것입니다.
이 때 과대적합(overfit)이 발생하기 전에 에포크를 멈추는 것을 조기 종료라고 합니다.
알맞은 에포크값을 찾기 위해 클래스 객체를 다시 만들겠습니다.
sc = SGDClassifier(loss='log_loss', random_state=42)이제 300번의 에포크를 수행해서, 훈련 세트와 테스트 세트 점수를 기록하여 비교해보겠습니다.
train_score = []
test_score = []

for _ in range(0, 300):
  sc.partial_fit(train_scaled, train_target, classes=np.unique(train_target))
  train_score.append(sc.score(train_scaled, train_target))
  test_score.append(sc.score(test_scaled, test_target))
그래서 이 300번의 에포크 동안 훈련세트와 테스트세트의 점수를 시각화 해봅니다.
plt.plot(train_score)
plt.plot(test_score)
plt.xlabel('epoch')
plt.ylabel('accuracy')
plt.show()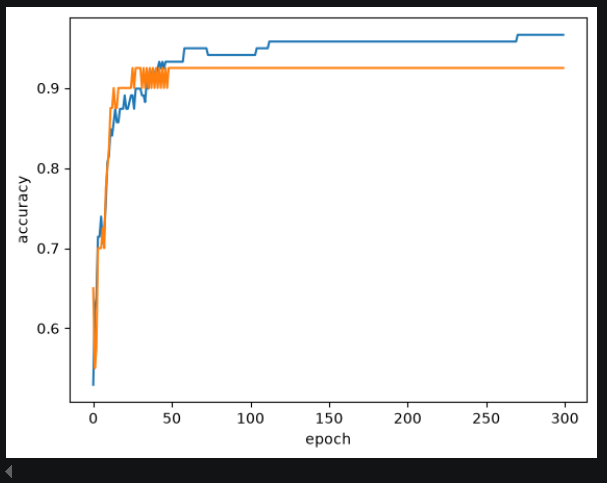
지금 데이터가 작아서 뚜렷하게 드러나지는 않지만 그 간극이 벌어지는 시점이 100번째 에포크인 것 같습니다.
그러면 반복될 max_iter를 100으로 설정하고 다시 훈련시키겠습니다.
sc = SGDClassifier(loss='log_loss', max_iter=100, tol=None, random_state=42)
sc.fit(train_scaled, train_target)
그리고 점수를 체크하면, 발전된 점수가 확인됩니다.
print(sc.score(train_scaled, train_target)) # 0.957...
print(sc.score(test_scaled, test_target)) # 0.925
정리해보면, 오늘날 대량의 데이터를 한꺼번에 메모리에 로딩할 수 없으므로
데이터를 조금씩 사용해 점진적으로 학습하는 방법이 필요해졌는데, 이것이 확률적 경사 하강법(SGD)입니다.
확률적 경사 하강법(SGD)을 이용해 로지스틱 회귀 모델을 훈련하는데 손실함수를 사용해 손실값을 낮추는 방식입니다.
충분히 반복하여 훈련하면 훈련세트에서 높은 점수를 받을 수 있지만, 어느 순간 과대적합이 될수도 있어
어느 일정 수치에서 간극이 벌어지는지 확인해야 합니다.