결정 트리 - Decision Tree
먼저 와인 데이터셋 먼저 준비합니다.
https://www.kaggle.com/datasets/uciml/red-wine-quality-cortez-et-al-2009
Red Wine QualitySimple and clean practice dataset for regression or classification modellingwww.kaggle.com
필요한 라이브러리를 임포트합니다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import os
메인 폴더를 마운트합니다.
base_path = r'c:\Users\haruka\Desktop\AI수업\mcp-month-2\data'wine.csv 파일을 불러옵니다.
file_path = os.path.join(base_path, 'wine.csv')
wine_df = pd.read_csv(file_path)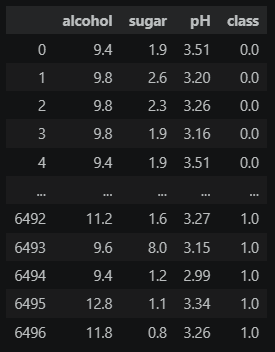
다음과 같은 4개의 컬럼이 존재합니다.
- alcohol: 알코올 도수
- sugar: 당도
- pH: pH 농도
- class : 타겟값으로, 0이면 레드 와인, 1이면 화이트 와인
즉, 화이트 와인이 양성 클래스 / 레드 와인이 음성 클래스로써 전체 와인 데이터에서 화이트 와인을 골라내는 문제입니다.
따라서 이진 분류 문제입니다.
먼저 info() 함수 통해 결측치가 있는지 확인합니다.
wine_df.info()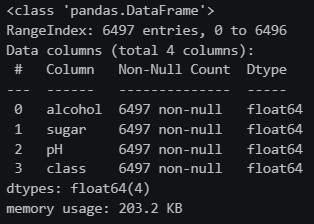
결측치는 따로 없는 것 같습니다. 다음으로, 기술 통계량을 확인합니다.
wine_df.describe()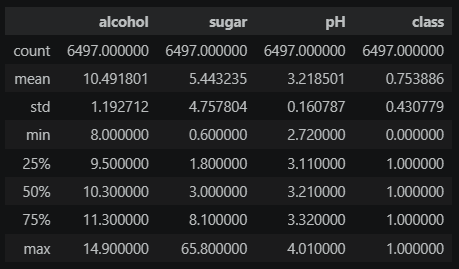
alcohol과 sugar 그리고 pH의 범위가 다르므로, 추후에 범위 스케일링이 필요할 것 같습니다.
그런데 sugar를 자세히 보면, minimum이 0.6인데 maximum은 65.8이고 중위값이 3.0인데 평균값은 중위값보다 높습니다.
아마 sugar 데이터는 한쪽으로 치우친 데이터일 확률이 높습니다. inbalance한 데이터일 확률이 높습니다.
이제 인풋 데이터와 타겟 데이터를 나누겠습니다.
data = wine_df[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine_df['class'].to_numpy()
그리고 훈련용 데이터와 테스트용 데이터로 나누겠습니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target =\
train_test_split(data, target, test_size=0.2, random_state=42)
이제 각각의 shape가 4:1인지 확인해봅니다.
print(train_input.shape) # (5197,3)
print(test_input.shape) # (1300, 3)
print(train_target.shape) # (5197,)
print(test_target.shape) # (1300,)
그 다음에 이제 데이터 범위들을 표준화하겠습니다.
from sklearn.preprocessing import StandardScaler

ss = StandardScaler()
ss.fit(train_input)

train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
이제 모든 데이터의 준비가 끝났습니다.
일단 결정 트리(Decision Tree) 알고리즘을 적용하기 전에 먼저 로지스틱 회귀(Logistic Regression)로 훈련합니다.
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression()
lr.fit(train_scaled, train_target)
그리고 훈련 점수와 테스트 점수를 체크합니다.
print(lr.score(train_scaled, train_target)) # 0.780...
print(lr.score(test_scaled, test_target)) # 0.777...
점수로 미루어볼 때 로지스틱 회귀로 화이트 와인 골라내는 것이 어려운 것 같습니다.
물론 solver 매개변수를 통해 사용할 알고리즘을 변경할 수도 있지만, 여기서는 이것으로 성능 개선을 하지는 않겠습니다.
여기서 로지스틱 회귀 알고리즘은 내부적으로 방정식을 학습하는데 그 계수와 절편을 확인해봅시다.
print(lr.coef_, lr.intercept_)
방정식은 다음과 같이 학습될 것입니다.
z = 0.51268071 x alcohol + 1.67335441 x sugar - 0.68775646 x pH + 1.81773456
이 값이 0보다 크면 화이트 와인이고, 0보다 작으면 레드 와인인 것입니다.
이 방정식은 왜 이 모델이 화이트 와인으로 분류했는지, 왜 레드 와인으로 분류했는지 설명할 수 없습니다.
이것을 순서도처럼 쉽게 설명할 수 있는 방법은 없을까요? 이것이 결정 트리(Decision Tree) 입니다.
결정 트리는 질문들을 하나하나 던져서 정답을 맞추어 가는 것입니다.
즉 데이터를 잘 나눌 수 있는 질문을 찾는다면, 질문을 추가해나가서 분류의 정확도를 높일 수 있을 것입니다.
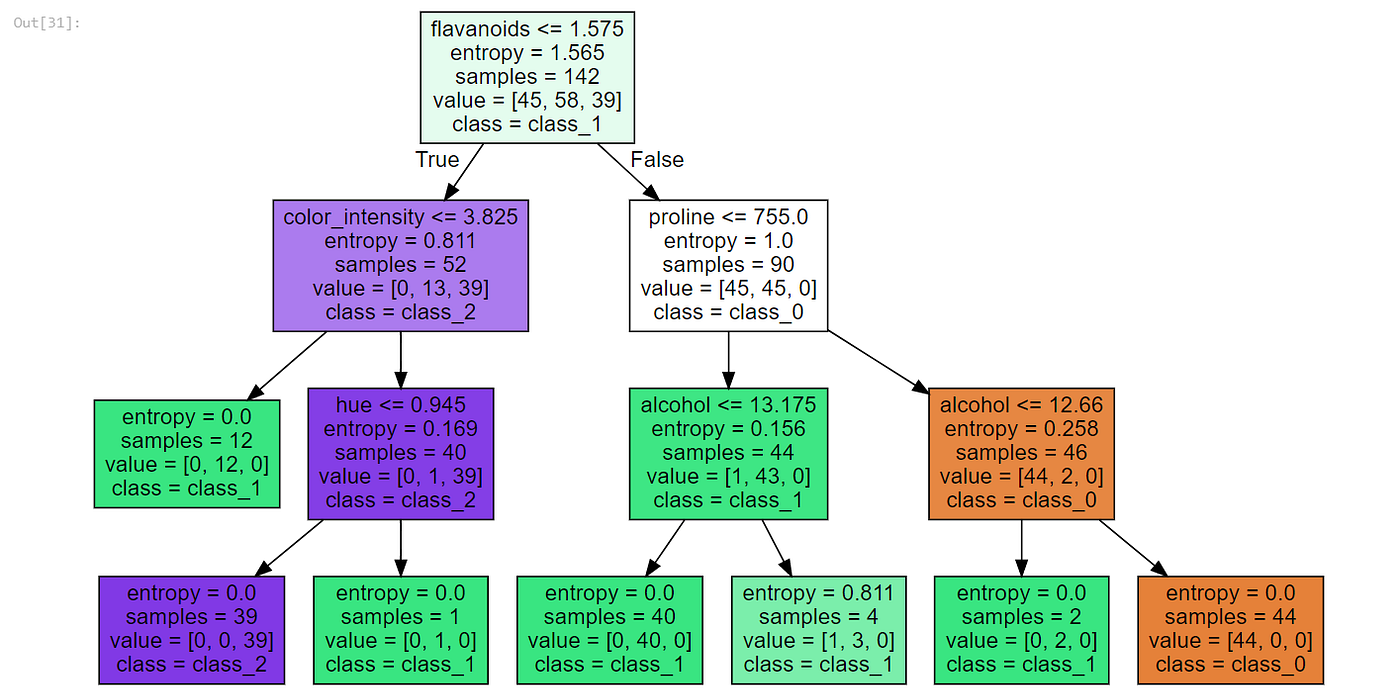
사이킷런에서는 DecisionTreeClassfier 클래스를 이용합니다.
from sklearn.tree import DecisionTreeClassifier이를 이용해 훈련해보겠습니다.
dt = DecisionTreeClassifier(random_state=42)
dt.fit(train_scaled, train_target)
그리고 점수를 확인합니다.
print(dt.score(train_scaled, train_target)) # 0.99...
print(dt.score(test_scaled, test_target)) # 0.85...
점수를 확인하니 로지스틱 회귀보다는 발전된 점수가 나왔습니다. 하지만 overfit 문제가 발생합니다.
이제 어떻게 트리가 형성되었는지 시각화를 통해 확인하겠습니다.
from sklearn.tree import plot_tree

plt.figure(figsize=(10, 7))
plot_tree(dt)
plt.show()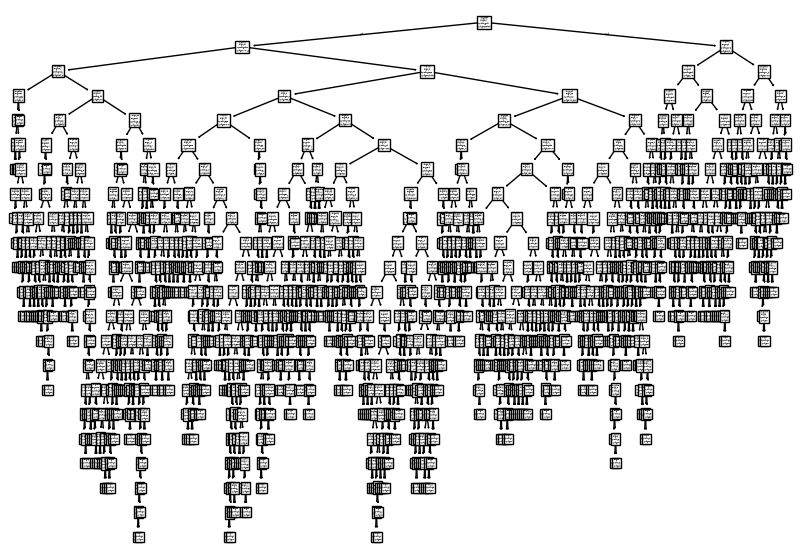
무언가 트리 형태가 그려졌습니다.
위에서 각각의 질문에 해당하는 사각형 하나하나를 **노드(Node)**라고 부릅니다.
노드(Node) 중 최상위에 있는 것을 **최상위 노드(Root Node)**라고 부릅니다.
노드(Node) 중 맨 아래쪽에 있는 것을 **리프 노드(Leaf Node)**라고 부릅니다.
각 노드마다 특정 특성에 대한 테스트를 하는데 테스트 결과에 따라 **가지(branch)**를 구성합니다.
현재 트리 형태가 복잡하므로, 트리의 최대 뎁스를 제한하겠습니다.
plt.figure(figsize=(10, 7))
plot_tree(dt, max_depth=1, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()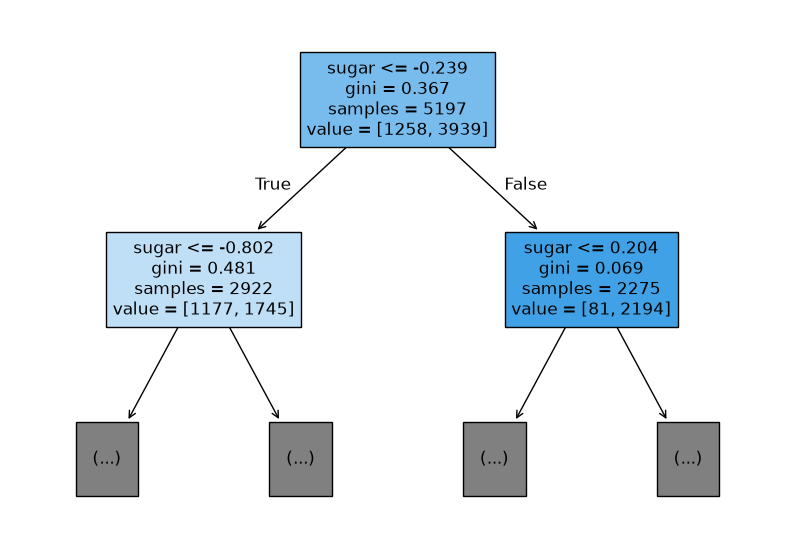
각 노드의 테스트 조건들이 노드의 최상단에 표시됩니다.
두번째는 불순도(gini)라는 것이 표시됩니다. 공식은 다음과 같습니다.
지니 불순도 = 1 - (음성 클래스 비율 ** 2 + 양성 클래스 비율 ** 2)
세번째는 샘플의 개수(samples)라는 것이 표시됩니다. 현 규칙(노드)의 데이터 건수입니다.
네번째는 클래스별 샘플수(value)라는 것이 표시됩니다. 클래스 값 기반의 데이터 건수입니다.
그리고 색상이 양성 클래스가 많을수록 더 진한 파란색이 됩니다. 음성 클래스가 많을수록 붉은색이 강해집니다.
따라서 결정 트리는 리프 노드에서 가장 많은 클래스가 예측 클래스가 됩니다.
그리고 결정 트리 알고리즘은 부모 노드와 자식 노드의 불순도 차이가 가능한 크도록 트리를 성장시킵니다.
이 불순도 차이를 **정보 이득(Information Gain)**이라고도 합니다.
추가로, 적절히 트리의 가지치기를 통해 overfit을 억제할 필요가 있습니다.
max_depth = 3으로 지정해 최대 3개의 노드까지만 성장하도록 제한해 보겠습니다.
dt = DecisionTreeClassifier(max_depth=3, random_state=42)
dt.fit(train_scaled, train_target)
점수를 확인해보겠습니다.
print(dt.score(train_scaled, train_target)) # 0.845
print(dt.score(test_scaled, test_target)) # 0.841
점수 균형도가 납득하도록 나왔습니다. 추가로 시각화를 통해 확인하겠습니다.
plt.figure(figsize=(10, 7))
plot_tree(dt, max_depth=3, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()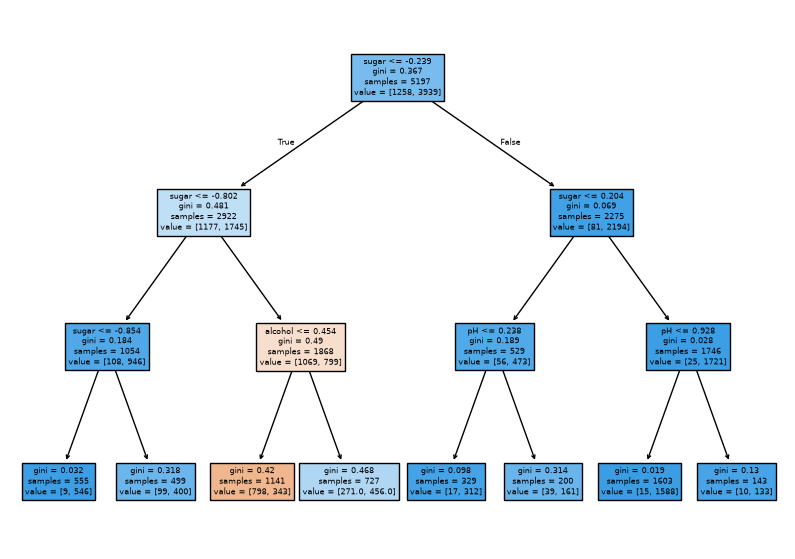
시각화 결과 3번째 리프 노드만 음성 클래스로 판정되었습니다.
이를 루트 노드부터 3번째 리프 노드까지 내려오면, 과정에 대한 설명이 가능해집니다.
그런데 sugar 값이 음수인 것은 무슨 의미일까요? 이유는 표준화했기 때문입니다!
하지만 결정 트리는 전처리가 필요없고, 특성값의 스케일이 계산에 영향을 주지 않습니다.
특성값이 아닌 클래스별 비율을 가지고 계산하게 됩니다.
따라서 전처리 하기 전의 훈련 세트와 테스트 세트로 다시 훈련합니다.
dt = DecisionTreeClassifier(max_depth=3, random_state=42)
dt.fit(train_input, train_target)
그리고 점수를 확인합니다.
print(dt.score(train_input, train_target)) # 0.845
print(dt.score(test_input, test_target)) # 0.841
점수는 변화없고, 이를 시각화로 표현하면, sugar 값 음수가 사라졌습니다.
plt.figure(figsize=(20, 15))
plot_tree(dt, max_depth=3, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()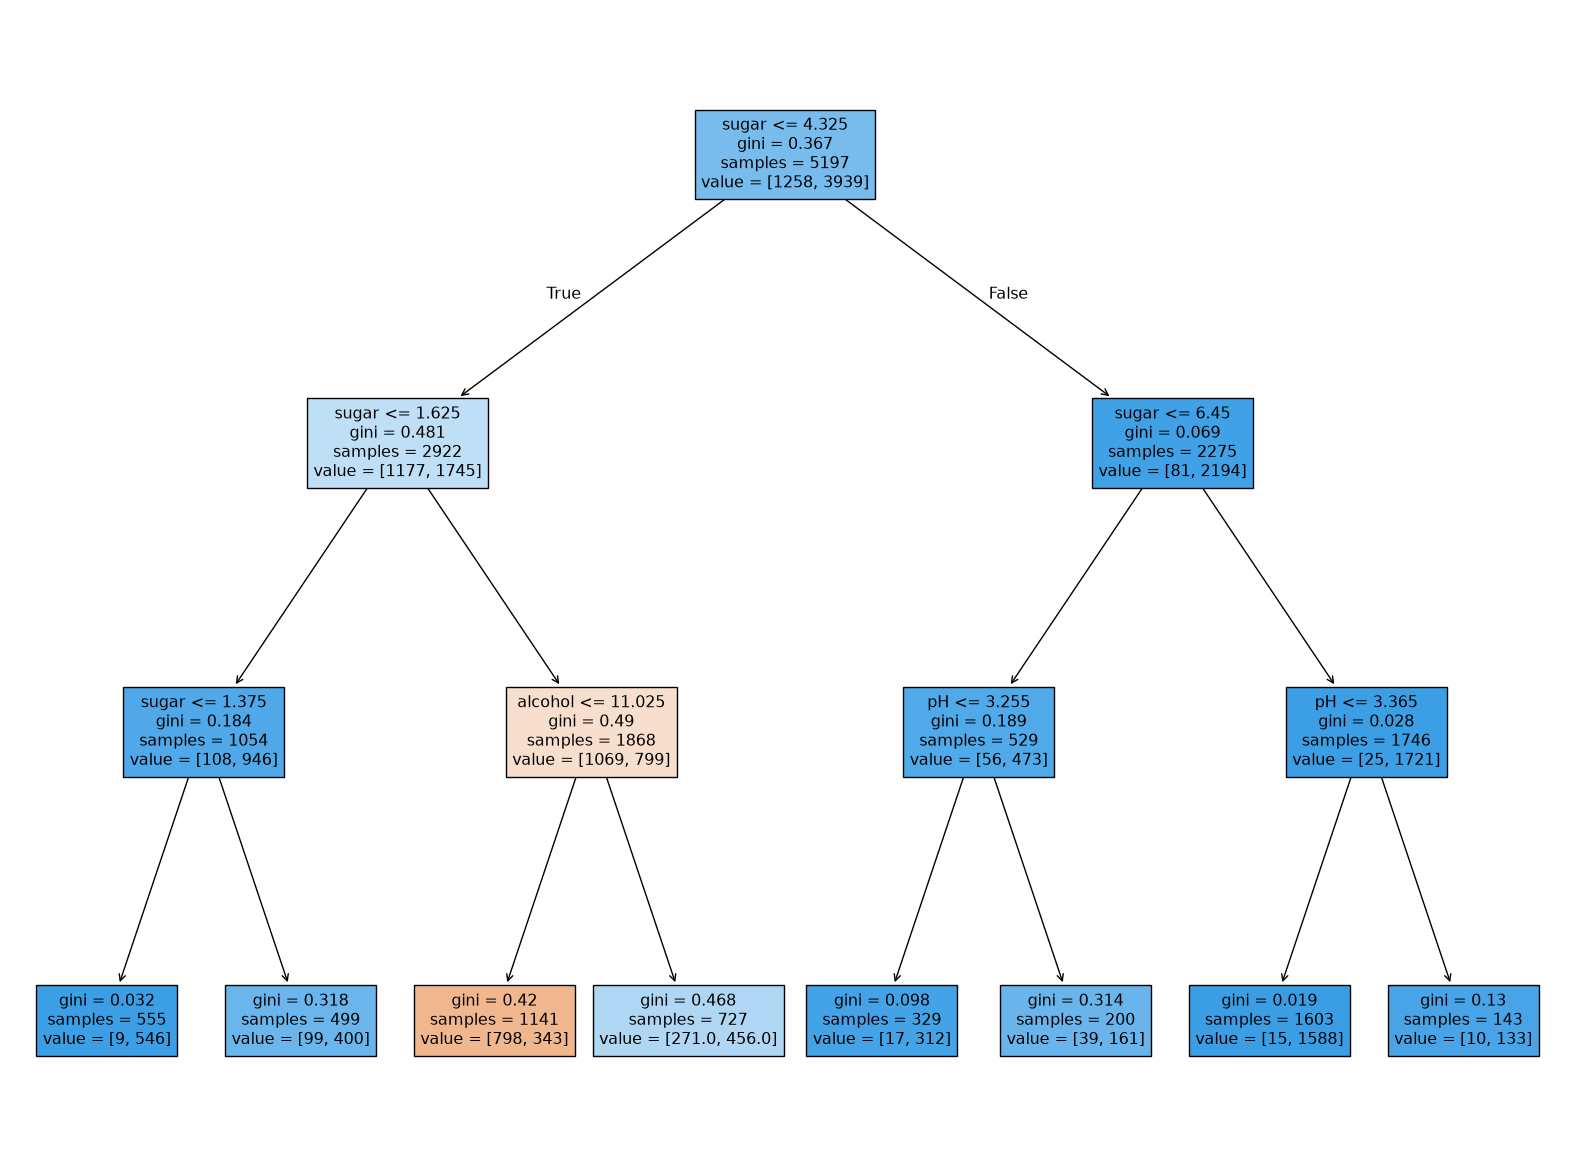
그리고, 결정 트리 알고리즘은 분류 모델을 만들 때 이 분류에 어떤 특성에 가장 큰 영향을 주었는지 산출해줍니다.
이것을 **특성 중요도(feature importance)**라고 합니다.
print(dt.feature_importances_) # [0.12345626 0.86862934 0.0079144 ]각각 alcohol, sugar, pH 값으로 sugar 값의 영향도가 더 높았다는 것을 알 수 있습니다.
정리하자면, 데이터를 기준으로 양성 클래스를 골라내는 이진 분류 문제에서 일반인이 그 결과를 이해할 수 없을 때
결정 트리를 사용해 어떻게 데이터를 분리하는지 불순도 개념을 통해 이해할 수 있게
시각화할 수 있다는 것을 알게 되었습니다.