교차 검증(Cross-Validate)과 그리드 서치(Grid Search)
앞서 배운 하이퍼파라미터에서는 모델이 학습하기 전에 제공해주는 파라미터인데
이는 훈련된 모델 성능에 큰 영향을 주며, 최적의 하이퍼파라미터를 찾아내야 합니다.
이것을 여러번 테스트를 해봐야 하는데, 이 때 테스트 세트로만 평가하면, 테스트 세트에만 잘 맞는 모델이 될 수 있습니다.
원래 테스트 세트는 최종적으로 딱 한번 사용하는 것이 원칙입니다. 훈련할 때는 가급적 사용하면 안됩니다.
그럴 때 등장한 것이 검증 세트(Validation Set) 입니다.
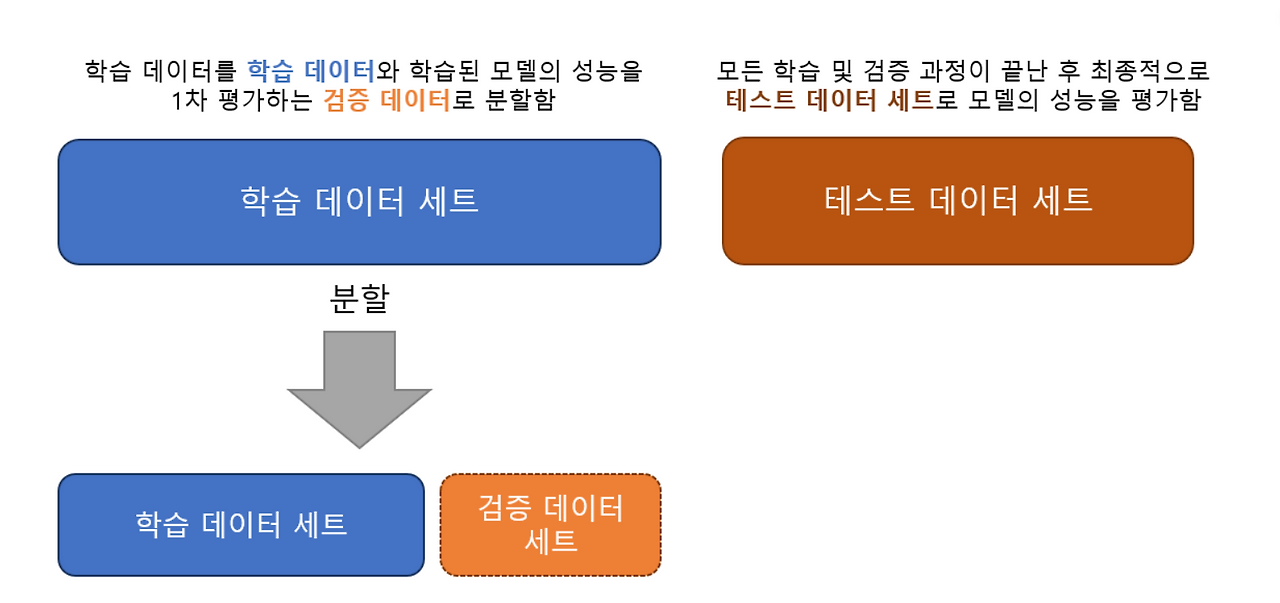
그동안 train_test_split() 함수를 이용해 훈련용 데이터셋과 테스트용 데이터를 나눴었습니다.
이 때 훈련용 데이터를 다시 학습용과 검증용으로 분할합니다.
이 검증용 데이터셋은 주 목적이 하이퍼파라미터를 튜닝하기 위한 목적입니다.
즉, 모델이 과대적합인지 과소적합인지 판단하기 위해 테스트 세트 대신 검증 세트를 만드는 것입니다.
일반적으로 전체 데이터의 20~30% 정도를 테스트 세트와 검증 세트로 떼어놓습니다.
본격적으로 데이터를 준비해보겠습니다. 먼저 인풋 데이터와 타겟 데이터를 분리합니다.
data = wine_df[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine_df['class'].to_numpy()
그리고 훈련 세트와 테스트 세트를 나눕니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target =\
train_test_split(data, target, test_size=0.2, random_state=42)
그 다음에 train_input과 train_target을 다시 train_test_split()에 넣습니다.
검증 세트는 train_input의 약 20% 정도로 설정합니다.
sub_input, val_input, sub_target, val_target =\
train_test_split(
  train_input, train_target, test_size=0.2, random_state=42
)
그리고 shape를 확인해보겠습니다.
print(train_input.shape) # (5197, 3)
print(sub_input.shape) # (4157, 3)
print(val_input.shape) # (1040, 3)
print(test_input.shape) # (1300, 3)
이제 훈련 세트와 검증 세트를 사용해 모델을 만들어보겠습니다.
from sklearn.tree import DecisionTreeClassifier

dt = DecisionTreeClassifier(random_state=42)
dt.fit(sub_input, sub_target)
점수를 확인해보겠습니다.
print(dt.score(sub_input, sub_target)) # 0.99
print(dt.score(val_input, val_target)) # 0.86
훈련용 데이터 점수가 높은 데에 비해, 검증용 데이터 점수가 많이 낮으므로, 이 모델은 overfit 된 상태입니다.
그래서 하이퍼파라미터를 바꾸어가면서, 더 좋은 모델을 찾아보겠습니다.
그 전에 **교차 검증(cross validation)**에 대해 알아보겠습니다.
훈련 데이터 안에서 쪼개서 검증 데이터를 만든 것이므로, 현재 문제는
훈련시켜야 할 데이터 양이 줄었고, 훈련 세트를 확보하기 위해 검증 세트를 또 줄이면 점수가 들쑥날쑥해집니다.
그래서 이 문제를 해결하기 위해 교차 검증을 사용합니다.
교차 검증은 검증 세트를 떼어내어 평가하는 과정을 여러번 반복합니다. 그 다음 결과를 평균하여 점수를 얻습니다.
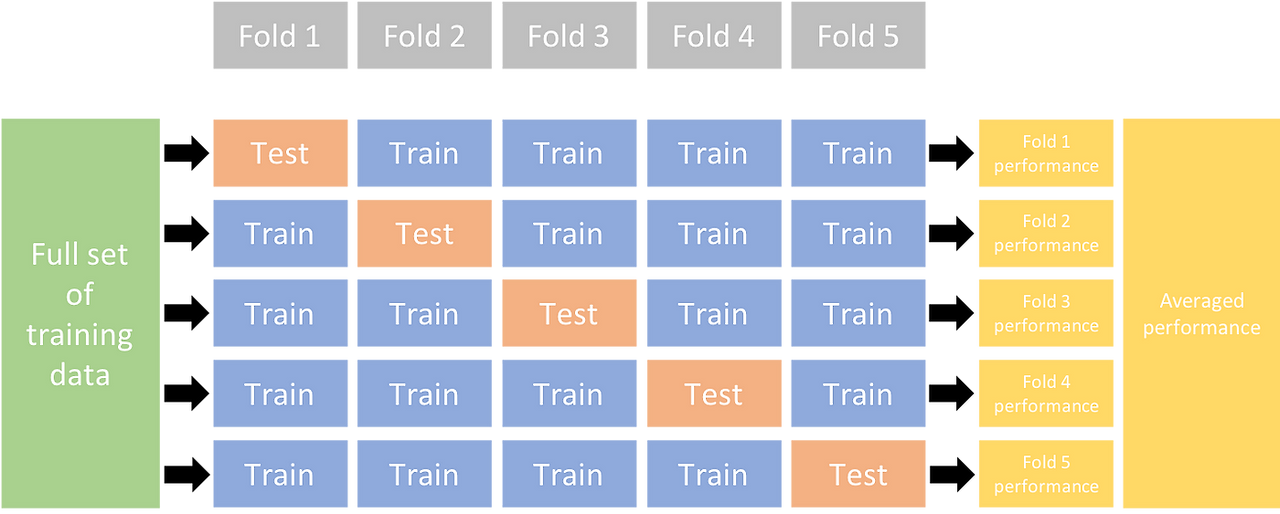
전체 데이터를 k등분 (현재 예시에서는 5등분) 하고
그 중에서 하나를 검증용으로 두고 나머지를 훈련시킵니다. 그리고 검증 데이터로 평가를 합니다.
이 과정을 5번 반복시킨 후 최종 평균값을 점수로 사용합니다.
주로 현업에서는 5-fold 혹은 10-fold 교차 검증을 많이 사용합니다.
교차 검증에서는 안정적인 점수도 얻고, 훈련에 더 많은 데이터를 사용할 수 있습니다.
사이킷런에서는 손쉽게 사용할 수 있는 cross_validate() 라는 함수를 제공합니다.
from sklearn.model_selection import cross_validate파라미터를 넘겨줄 때 검증세트 분리하기 전의 훈련세트 전체를 넘겨줍니다.
scores = cross_validate(dt, train_input, train_target)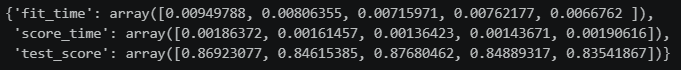
cross_validate()는 dict 자료구조를 리턴하는데
fit_time과 score_time은 각각 모델을 훈련하는 시간과 검증하는 시간을 의미합니다.
test_score는 모델의 각 폴드별 검증 점수를 의미합니다.
최종 점수는 검증 점수의 평균이므로, 다음과 같이 수동 작성합니다.
print(np.mean(scores['test_score'])) # 0.855....만약 교차 검증 시 훈련 세트를 shuffle 해주려면 분할기(splitter)를 지정해주어야 합니다.
cross_validate()는 기본적으로 회귀모델은 KFoldSplitter를 분류 모델은 StratifiedKFold를 사용합니다.
from sklearn.model_selection import StratifiedKFold매개변수로는 fold의 개수인 n_splits 값과, 섞을지 여부인 shuffle 값을 지정해줄 수 있습니다.
확인 결과 점수에 조금에 차이가 발생한걸 확인할 수 있습니다.
splitter = StratifiedKFold(n_splits=10, shuffle=True, random_state=42)
scores = cross_validate(dt, train_input, train_target, cv=splitter)
print(np.mean(scores['test_score'])) # 0.857...
이제 모델에 매개변수를 바꿔가면서 가장 성능이 좋은 모델을 찾아갈 것입니다.
진행하는 방법은 먼저 라이브러리가 제공하는 기본값을 그대로 사용해 모델을 훈련해봅니다.
그리고, 검증 세트의 점수나, 교차 검증을 통해서 매개변수를 조금씩 바꿔봅니다.
이 매개변수를 바꿔가면서 모델을 훈련하고, 교차 검증을 수행해야 합니다.
그러나 이 방식은 두개 이상의 매개변수를 동시에 바꿔가며 최적의 값을 찾아내야 하므로 복잡해집니다.
따라서 이 방식을 편리하게 해주는 **그리드 서치(GridSearch)**를 사용합니다.
그리드 서치는 Cross Validation을 여러 번 반복해서 최적의 하이퍼 파라미터를 찾는 작업입니다.
from sklearn.model_selection import GridSearchCV먼저 간단한 예시로, 결정 트리에서 min_impurity_decrease의 최적값을 찾아보겠습니다.
일단 사이킷런에서 해당 모델이 가지고 있는 하이퍼 파라미터들을 확인할 수 있습니다.
DecisionTreeClassifier().get_params()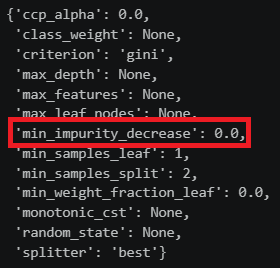
이제 탐색할 매개변수와 탐색할 값들의 리스트를 dict 형태로 만듭니다.
참고로 min_impurity_decrease는 노드를 분할하기 위한 불순도 최소 감소량입니다.
min_impurity_decrease = [0.0001, 0.0002, 0.0003, 0.0004, 0.0005]
params = {'min_impurity_decrease': min_impurity_decrease}
이제 GridSearchCV 클래스에 탐색대상모델과 params 변수를 전달합니다.
병렬 작업을 위해 n_jobs = -1을 추가해주세요.
gs = GridSearchCV(DecisionTreeClassifier(random_state=42), params, n_jobs=-1, cv=5)그리고, 모델 훈련하듯이 fit() 함수를 호출합니다.
gs.fit(train_input, train_target);수행 결과는 gs 객체에 담겨있으며, 최적의 점수와 최적의 파라미터를 알아봅니다.
print("최적 점수 : {:.3f}".format(gs.best_score_)) # 0.868
print("최적 하이퍼 파라미터 : ", gs.best_params_) # 0.0001
그리고, gs 객체에 이미 최적의 파라미터로 학습된 모델을 가지고 있습니다.
dt = gs.best_estimator_점수를 확인합니다.
print(dt.score(train_input, train_target)) # 0.961....그리고, 각 매개변수에서 수행한 교차 검증 결과를 확인할 수 있습니다.
print(gs.cv_results_)
이것을 DataFrame으로 변환해보겠습니다.
pd.DataFrame(gs.cv_results_)
여기서 인덱스는 각각의 조합 하나를 의미합니다. (여기서는 파라미터가 1개이므로, 단일 조합입니다)
컬럼 split0_test_score 부터 split4_test_score까지 5번의 CV Score가 존재하고
mean_test_score 컬럼은 5번의 CV 점수의 평균값입니다. 이중 최대값이 best_score_를 의미합니다.
그리고 복잡한 예시로, 복잡한 매개변수 조합을 탐색해보겠습니다.
- min_impurity_decrease : 노드를 분할하기 위해 불순도 최소 감소량
- max_depth : 트리의 깊이 제한
- min_samples_split: 노드를 나누기 위한 최소 샘플 수
그래서 탐색할 하이퍼 파라미터들을 딕셔너리로 준비합니다.
params = {
  'min_impurity_decrease': np.arange(0.0001, 0.001, 0.0001),
  'max_depth': range(5, 20, 1),
  'min_samples_split': range(2, 100, 10)
}
그렇다면 위 매개변수로 수행할 교차 검증의 횟수는 몇 회일까요? 9 * 15 * 10 = 1,350회입니다.
그리고 기본 5-Fold 교차 검증 수행하면 만들어지는 모델의 수는? 1,350 * 5 = 6,750회입니다.
이것을 기반으로 GridSearch를 수행해봅니다.
gs = GridSearchCV(DecisionTreeClassifier(random_state=42), params, n_jobs=-1)
gs.fit(train_input, train_target)
최상의 매개변수 조합을 출력해봅니다.
print(gs.best_params_)
# {'max_depth': 14, 'min_impurity_decrease': np.float64(0.0004), 'min_samples_split': 12}
최상의 교차검증 점수도 확인해봅니다.
print(gs.best_score_) # 0.8683865773302731