트리의 앙상블
우리가 가지고 있는 데이터는 형태에 따라 정형 데이터와 비정형 데이터로 나뉩니다.
정형화된 데이터는 정해진 틀(스키마)에 맞춰서 저장된 데이터입니다. 대표적으로 행과 열로 된 2차원 데이터입니다.
비정형 데이터는 정형화된 형태로 표현하기 어려운 데이터입니다. 가령 책, 글 텍스트, 사진, 음악 등입니다.
반정형 데이터는 고정된 틀은 없지만, 구조는 파악할 수 있는 데이터입니다. JSON, XML, HTML, NoSQL 등이 있습니다.
그래서 앙상블 학습 알고리즘은 정형화된 데이터를 다룰 때 가장 뛰어난 성과를 내는 알고리즘으로 알려집니다.
앙상블 학습 알고리즘은 더 좋은 예측 결과를 만들기 위해 여러 개의 모델을 훈련하는 알고리즘입니다.
대부분의 앙상블 학습 알고리즘은 결정 트리 기반으로 만들어져 있습니다.
반면에, 비정형 데이터는 신경망 알고리즘을 사용합니다.
앙상블 학습 알고리즘의 대표적인 예시로 **랜덤 포레스트(Random Forest)**가 있습니다.
결정 트리(Decision Tree)가 하나의 나무라면, 랜덤 포레스트(Random Forest)는 결정 트리의 랜덤으로 숲입니다.
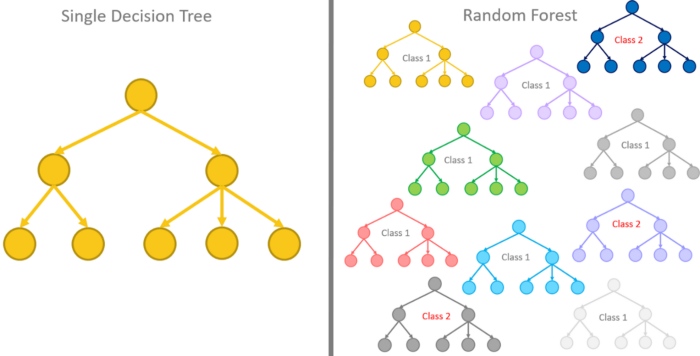
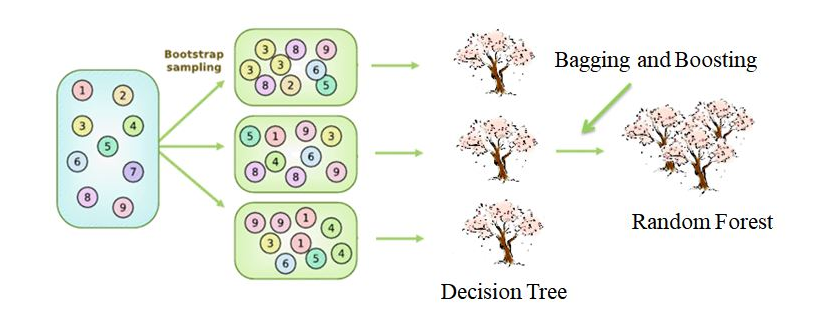
랜덤 포레스트는 각 트리를 훈련시키기 위해 데이터를 랜덤하게 샘플을 추출해 훈련 데이터를 만듭니다.
이 때 한 샘플이 중복되어 추출될 수도 있게 합니다. 이러한 샘플을 부트스트랩 샘플이라고 합니다.
예를 들어 가방에 1000개의 샘플이 있다면, 먼저 1개를 뽑고, 다시 가방에 넣고 다른 샘플을 뽑는 방식입니다.
사이킷런에서 제공하는 분류기는 RandomForestClassifier 클래스를 제공합니다.
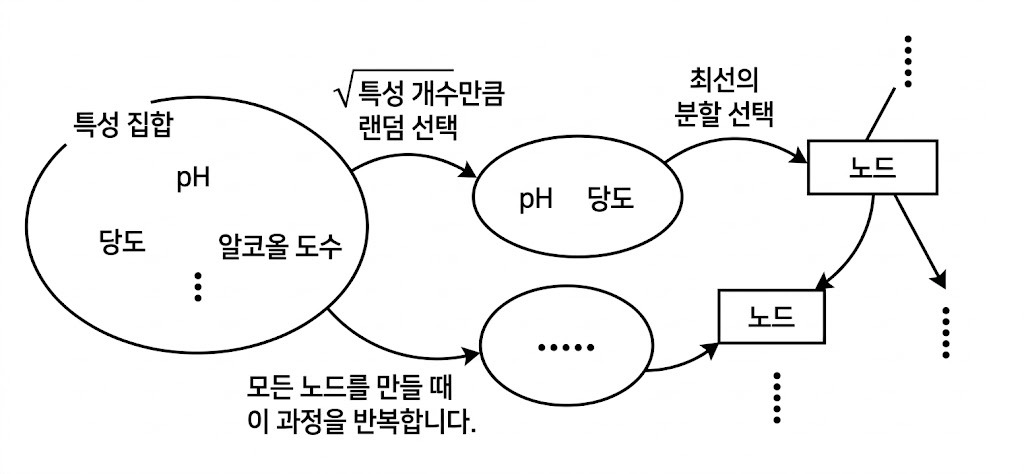
포레스트를 구성하는 각각의 트리에서 노드를 분할할 때 전체 특성 중에서 일부 특성을 무작위로 고른 다음
최선의 분할을 찾는 것입니다. 기본적으로 전체 특성 개수의 제곱근만큼 특성을 선택합니다.
반면에 회귀 모델인 RandomForestRegressor는 전체 특성을 다 사용합니다.
사이킷런에서 랜덤 포레스트는 기본적으로, 100개의 결정트리를 위와 같은 방법으로 훈련합니다.
최종 예측은 분류에서는 각 트리의 클래스별 확률을 평균하여 가장 높은 확률을 가진 클래스를 예측으로 삼습니다.
회귀일 때는 단순히 각 트리의 예측을 평균합니다.
랜덤 포레스트는 랜덤하게 선택한 샘플과 특성을 사용하므로, 훈련 세트에 과대 적합을 막아줍니다.
또, 검증 세트와 테스트 세트에서 안정적인 성능을 낼 수 있습니다.
먼저 데이터를 준비하겠습니다. 인풋 데이터와 타겟 데이터로 먼저 분리합니다.
data = wine_df[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine_df['class'].to_numpy()
훈련 데이터와 테스트 데이터를 8:2로 분리합니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target =\
train_test_split(data, target, test_size=0.2, random_state=42)
그리고, 교차 검증을 통해 검증 데이터를 또 떼어내야 합니다.
여기서 return_train_score 통해 검증 점수 및 훈련세트에 대한 점수도 리턴해 overfit 파악에 용이하게 하겠습니다.
먼저 cross_validate() 함수와 RandomForestClassifier 클래스를 불러옵니다.
from sklearn.model_selection import cross_validate
from sklearn.ensemble import RandomForestClassifier
이제 cross_validate()를 실행해보겠습니다.
rf = RandomForestClassifier(n_jobs=-1, random_state=42)
scores = cross_validate(rf, train_input, train_target, return_train_score=True, n_jobs=-1)
scores를 확인해보면 다음과 같습니다.
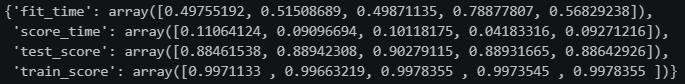
train_score와 test_score의 평균을 재보겠습니다.
print(np.mean(scores['train_score'])) # 0.997...
print(np.mean(scores['test_score'])) # 0.890...
점수 확인 결과 현재 모델은 overfit인 상태입니다. 여기선 데이터가 충분하지 않으므로, 더 이상 개선하지 않겠습니다.
추가적으로, 결정 트리에서 배운 특성 중요도를 확인해보겠습니다.
랜덤 포레스트의 특성 중요도는 각 결정트리의 특정 중요도를 취합한 것입니다.
먼저 랜덤 포레스트로 학습합니다.
rf.fit(train_input, train_target)그리고 특성 중요도 값을 확인해봅니다.
print(rf.feature_importances_) # [0.23167441 0.50039841 0.26792718]랜덤포레스트는 특성의 일부를 랜덤하게 선택하여 결정트리를 훈련하므로
하나의 특성에 과도하게 집중하지 않고 더 많은 특성이 훈련에 기여할 기회를 얻게 됩니다.
이는 overfit을 줄이고 일반화 성능을 높일 수 있을 것으로 기대됩니다.
그리고, 랜덤 포레스트에는 특별한 샘플이 있는데 바로 OOB(Out of Bag) 샘플입니다.
이것은 부트스트랩 샘플에 포함되지 않고 남는 샘플입니다. 이 OOB 샘플을 활용해 모델 평가하는 기능을 제공합니다.
oob_score = True로 지정해 활용할 수 있습니다.
rf = RandomForestClassifier(oob_score=True, n_jobs=-1, random_state=42)
rf.fit(train_input, train_target)
oob_score_ 속성을 통해 OOB 샘플을 이용한 모델 평가 점수를 획득할 수 있습니다.
print(rf.oob_score_) # 0.89...앙상블 학습 알고리즘의 두 번째 예시로, **엑스트라 트리(Extra Tree)**가 있습니다.
기본적으로 랜덤 포레스트와 거의 비슷한데, 다음과 같은 점이 비슷합니다.
- 기본적으로 100개의 결정 트리로 훈련합니다
- 결정 트리가 제공하는 대부분의 매개변수를 지원합니다
- 일부 특성을 랜덤하게 선택하여 노드 분할합니다
차이점은 다음과 같습니다.
- 부트스트랩 샘플을 사용하지 않습니다.
- 결정 트리를 만들 때 전체 세트를 이용합니다.
- 노드 분할 할 때 가장 좋은 분할을 찾는 것이 아니라 무작위 분할합니다.
많은 트리를 앙상블하면, overfit을 억제하고 검증 점수를 높이는 효과를 기대할 수 있습니다.
사이킷런에서 ExtraTreesClassifier 클래스를 임포트합니다.
from sklearn.ensemble import ExtraTreesClassifier객체 변수를 만들고, 교차 검증을 통해 점수를 계산합니다.
et = ExtraTreesClassifier(n_jobs=-1, random_state=42)
scores = cross_validate(et, train_input, train_target, return_train_score=True, n_jobs=-1)
train_score와 test_score의 평균점수를 계산합니다.
print(np.mean(scores['train_score'])) # 0.99....
print(np.mean(scores['test_score'])) # 0.88...
참고로 엑스트라트리는 무작위성이 더 크기 때문에, 랜덤포레스트보다는 더 많은 결정트리를 훈련해야 합니다.
랜덤하게 노드를 분할하므로, 계산속도는 상대적으로 랜덤포레스트보다는 빠릅니다.
이 결과를 바탕으로 엑스트라트리도 특성 중요도를 살펴보겠습니다.
et.fit(train_input, train_target)
print(et.feature_importances_) # [0.20183568 0.52242907 0.27573525]
랜덤포레스트와 마찬가지로 sugar 특성에 대해 의존합니다.
앙상블 학습 알고리즘의 세번째 예시는 그라디언트 부스팅(Gradient Boosting) 입니다.
GradientBoostingClassifier는 얕은 깊이의 결정 트리를 사용합니다. 기본적으로 깊이 3, 결정트리 100개를 사용합니다.
여기서 경사 하강법을 사용해 트리를 천천히 조금씩 앙상블에 추가하면서, 손실이 가장 낮은 곳으로 이동합니다.
그라디언트 부스팅은 GradientBoostingClassifier를 사용합니다.
from sklearn.ensemble import GradientBoostingClassifier객체 변수를 만들고, 교차 검증을 사용해 점수를 계산합니다. 참고로 GradientBoost는 병렬로 진행하지 않습니다.
gb = GradientBoostingClassifier(random_state=42)
scores = cross_validate(gb, train_input, train_target, return_train_score=True, n_jobs=-1)
그리고 점수를 확인합니다.
print(np.mean(scores['train_score'])) # 0.88...
print(np.mean(scores['test_score'])) # 0.87...
결과적으로 overfit이 많이 억제되고 있는 모습입니다. 그라디언트 부스팅은 결정트리의 개수를 늘려도 overfit에 강합니다.
예를 들어 결정 트리의 개수를 500개로 늘려보겠습니다.
gb = GradientBoostingClassifier(n_estimators=500, learning_rate=0.2, random_state=42)
scores = cross_validate(gb, train_input, train_input, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score'])) # 0.94....
print(np.mean(scores['test_score'])) # 0.87....
약간의 overfit 성향이 있지만 결정 트리의 개수에 비해서는 잘 억제하고 있습니다.
그라디언트 부스팅 역시 특성 중요도를 제공합니다.
gb.fit(train_input, train_target)
print(gb.feature_importances_) # [0.15881044 0.6799705  0.16121906]
결과에서 볼 수 있듯이, 랜덤 포레스트 알고리즘보다 sugar에 집중하는 모습입니다.
그리고, 그라디언트 부스팅은 트리 훈련에 사용할 훈련 세트에 비율을 정하는 subsample 파라미터를 제공합니다.
기본값은 1.0으로 전체 훈련세트를 사용하고, 1.0보다 작으면 훈련세트의 일부를 사용하여
경사 하강법 단계마다 일부 샘플을 랜덤하게 선택하여 진행합니다.
일반적으로, 그라디언트 부스팅은 랜덤 포레스트보다 성능은 좋으나, 훈련 속도가 느립니다.
이유는 n_jobs 매개변수가 없어 병렬 프로세싱을 할 수 없습니다. 순서대로 트리를 추가하면서 훈련하기 때문입니다.
앙상블 학습 알고리즘의 네번째 예시는 히스토그램 기반 그라디언트 부스팅(Histogram Based Gradient Boosting) 입니다.
입력 데이터의 특성을 구간(기본적으로 256개 구간)으로 나누어 노드를 분할할 때 최적의 분할을 빠르게 찾을 수 있습니다.
HistGradientBoostingClassifier는 기본 매개변수에서도 안정적인 성능을 내며
트리의 개수를 지정하는데 n_estimators 대신에 max_iter를 사용합니다. 부스팅을 반복하는 횟수를 지정합니다.
from sklearn.ensemble import HistGradientBoostingClassifier똑같이 객체 변수를 불러와, 교차 검증을 통해 점수를 계산합니다.
hgb = HistGradientBoostingClassifier(random_state=42)
scores = cross_validate(hgb, train_input, train_target, return_train_score=True, n_jobs=-1)
점수를 체크해보겠습니다.
print(np.mean(scores['train_score'])) # 0.932...
print(np.mean(scores['test_score'])) # 0.879...
점수 비교 결과, 기존의 Gradient Boosting에 비해 overfit을 조금 잘 억제하는 느낌입니다.
Histogram Based Gradient Boosting의 특성 중요도는 조금 다릅니다.
permutation_importance()를 사용해 특성을 하나씩 랜덤하게 섞어서 모델의 성능 변화를 관찰 후 중요도를 파악합니다.
파라미터로 n_repeats를 설정해 랜덤하게 섞을 횟수를 지정합니다. (기본값은 5입니다.)
from sklearn.inspection import permutation_importance훈련 세트에서 특성 중요도를 계산하겠습니다.
hgb.fit(train_input, train_target)
result = permutation_importance(
  hgb, train_input, train_target, n_repeats=10, random_state=42, n_jobs=-1
)
print(result.importances_mean) # [0.08924379 0.23494324 0.081066]
이것 역시 sugar에 많은 집중된 형태입니다.