데이터셋 준비
먼저 데이터셋을 준비하기 위해 라이브러리를 임포트합니다.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import os
그리고, 판다스로 csv 파일을 불러들입니다.
base_path = r'c:\Users\haruka\Desktop\AI수업\mcp-month-2\data'

file_name = r'high_diamond_ranked_10min.csv'

file_path = os.path.join(base_path, file_name)

df = pd.read_csv(file_path)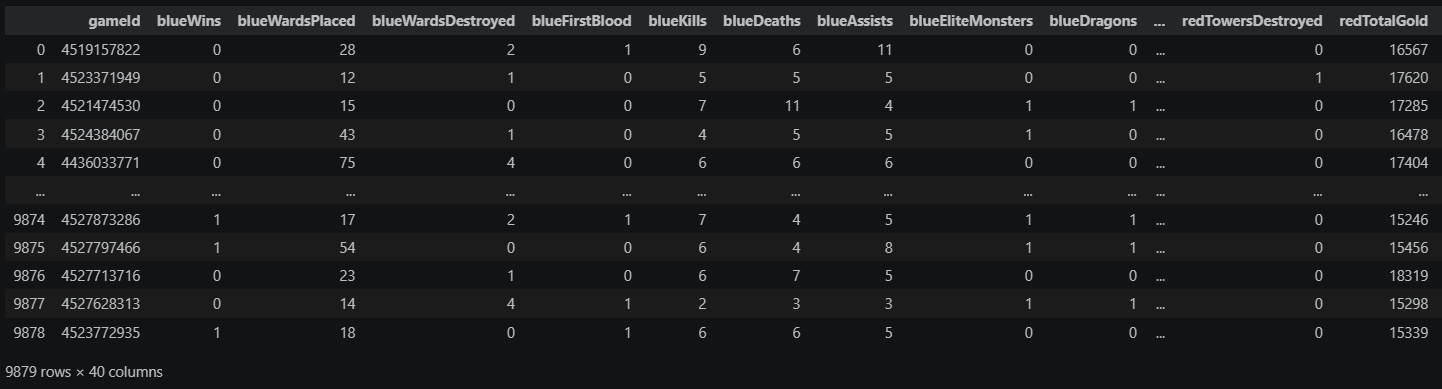
이 데이터는 LOL(League Of Legends) 다이아몬드 랭킹 게임의 초반 10분 전적 데이터셋을 의미합니다.
컬럼의 의미는 아래와 같습니다.
- gameId : 게임 판의 고유 ID
- blueWins : 블루팀의 승리 여부 (패배: 0, 승리: 1) 즉, 타겟값입니다
- xxxWardsPlaced : xxx팀에서 설치한 와드의 수
- xxxWardsDestroyed: xxx팀에서 파괴한 와드의 수
- xxxFirstBolld: xxx팀의 첫번째 킬 달성 여부
- xxxKills: xxx팀의 킬 수
- xxxDeaths: xxx팀의 죽음 수
- xxxAssists: xxx팀의 어시스트 수
- xxxEliteMonsters: xxx팀이 죽인 엘리트 몬스터 수
- xxxDragons: xxx팀이 죽인 용의 수
- xxxHeralds: xxx팀이 죽인 전령의 수
- xxxTowersDestroyed: xxx팀이 파괴한 탑의 수
- xxxTotalGold: xxx팀의 전체 획득 골드
- xxxAvgLevel: xxx팀의 평균 레벨
- xxxTotalExperience: xxx팀의 총 경험치 획득량
- xxxTotalMinionsKilled: xxx팀의 총 미니언 킬 수
- xxxGoldDiff: xxx팀과 다른 팀간의 골드 획득량 차이
- xxxExperienceDiff: xxx팀과 다른 팀간의 경험치 획득량 차이
- xxxCSPerMin: xxx팀의 분당 CS 스코어
- xxxGoldPerMin: xxx팀의 분당 골드 획득량
EDA(Exploratory Data Analysis, 탐색적 데이터 분석)
EDA는 데이터를 분석하고 결과를 내는 과정에서 지속적으로 해당 데이터에 대해 탐색 및 이해를 가져야 함을 의미합니다.
즉, 다양한 측면으로 데이터의 탐색적 분석을 시도하여야 합니다.
대표적으로 다음과 같은 행동을 의미합니다.
- 데이터의 각 컬럼과 행의 의미 및 연관성에 대한 이해
- 결측치 처리 및 데이터 필터링
- 데이터 시각화
먼저 head()를 통해 전체적인 데이터 구조를 파악합니다.
df.head()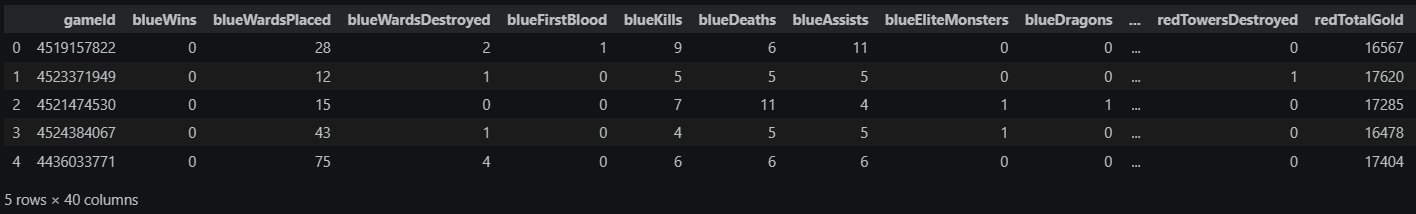
블루 팀 데이터가 앞쪽에 있고, 레드 팀 데이터가 뒤쪽에 있는 형태입니다.
그러다보니, 양측의 전적을 표시하는 컬럼 데이터에서 중복된 데이터가 있을 수 있습니다.
예를 들어, blueKills와 blueDeaths 한 쌍과 redKills와 redDeaths 한쌍을 살펴볼 경우, 대칭 데이터가 있을 수 있습니다.
또한, redGoldDiff와 blueGoldDiff는 부호가 다른 관계에 있어 대칭된 데이터일 수 있습니다.
이와 같이 multi-colinearity를 가지는 값들은 drop을 해서 제거해줄 필요가 있어 보입니다.
직접 한번 살펴보겠습니다.
df[['redGoldDiff', 'blueGoldDiff']]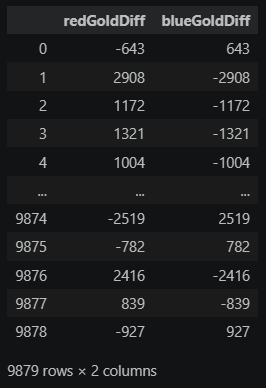
실제로 부호가 반대된 관계에 있음을 확인할 수 있습니다.
이러한 것들은 이후에 데이터 전처리 때 정리해주어야 합니다.
다음으로 info() 함수를 확인하여 결측치 여부를 확인하겠습니다.
df.info()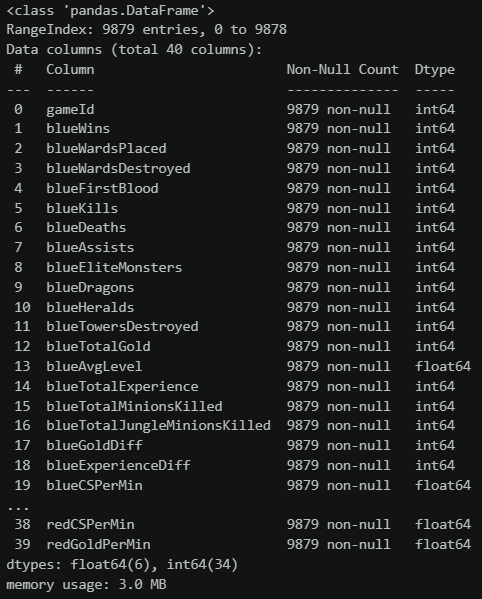
확인결과, 결측치가 없는 깨끗한 데이터입니다. 그리고, dtype은 문자열 없는 숫자형 데이터로 구성됩니다.
그리고, describe()를 통해 기술 통계량을 확인해보겠습니다.
이것에서 데이터의 밸런스 혹은 이상치가 있을지, 스케일링 여부를 확인해야 합니다.
df.describe()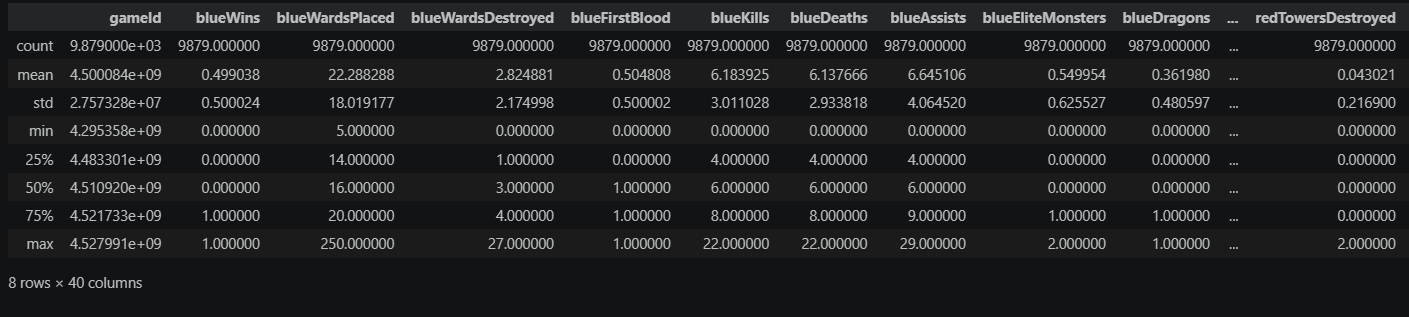
먼저, minimum 값과 maximum 값의 범위가 제각각이라 스케일링 작업은 필요합니다.
그리고, blueWins의 평균값이 0.5에 근사하므로, 서로 이긴 횟수가 1/2씩 섞여있음을 의미합니다. (서로 균형적임)
주로 0, 1 값을 가지는 경우를 제외하고, minimum과 maximum 간의 격차가 조금 있어 이상치를 의심해 볼 수 있습니다.
예시로, 일부 컬럼만 확인해보겠습니다.
df.describe()[['blueDragons', 'blueHeralds', 'redDragons', 'redHeralds']]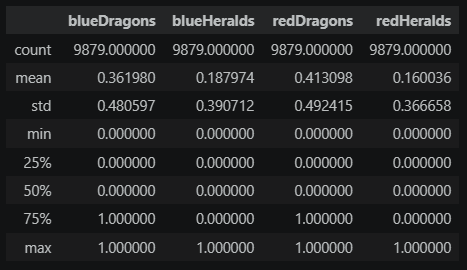
minimum과 maximum 값으로 봤을 때 0, 1로만 구성된 분류 데이터인데
평균값은 0.5와는 거리가 있는 모습으로 보아, 균형도가 떨어지는 모습을 보이고 있습니다.
물론 게임 특성 상 드래곤 같은 경우, 지형 특성 때문에 한쪽에 치우치는 특성을 가질 수 있습니다.
이번에는 각 컬럼의 연관성을 히트맵으로 시각화 해보겠습니다.
df.corr()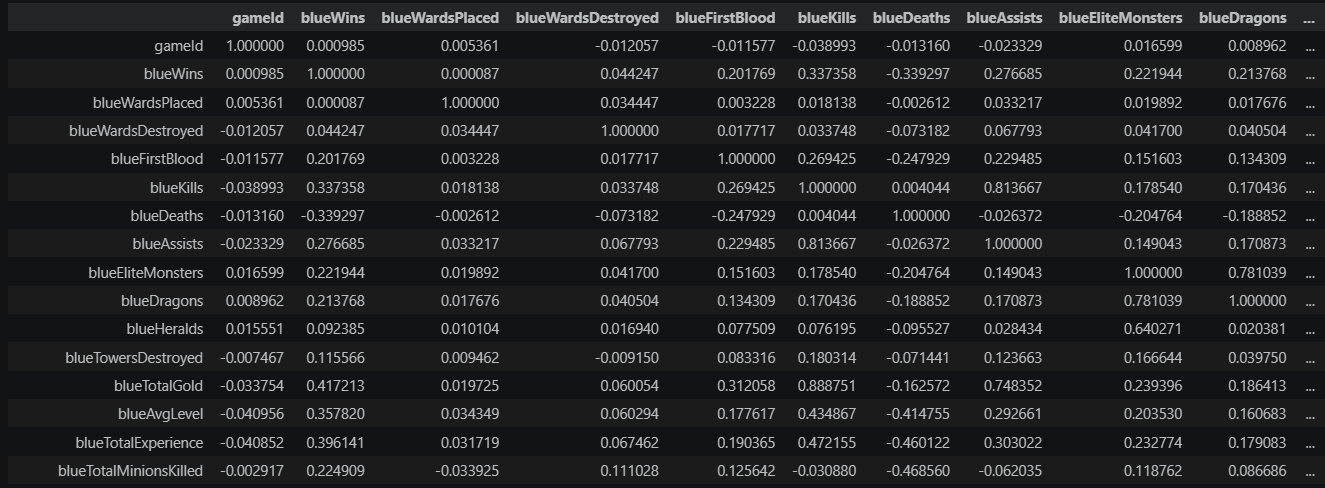
위에서처럼 corr() 함수를 이용해 각 컬럼별 연관 관계를 수치로 나타낼 수 있습니다.
이것을 Seaborn의 heatmap() 함수를 이용해 Pearson's Correlation 시각화 해보겠습니다.
그 중 blueWins와의 관계만 확인합시다.
fig = plt.figure(figsize=(4, 10))
sns.heatmap(df.corr()[['blueWins']], annot=True)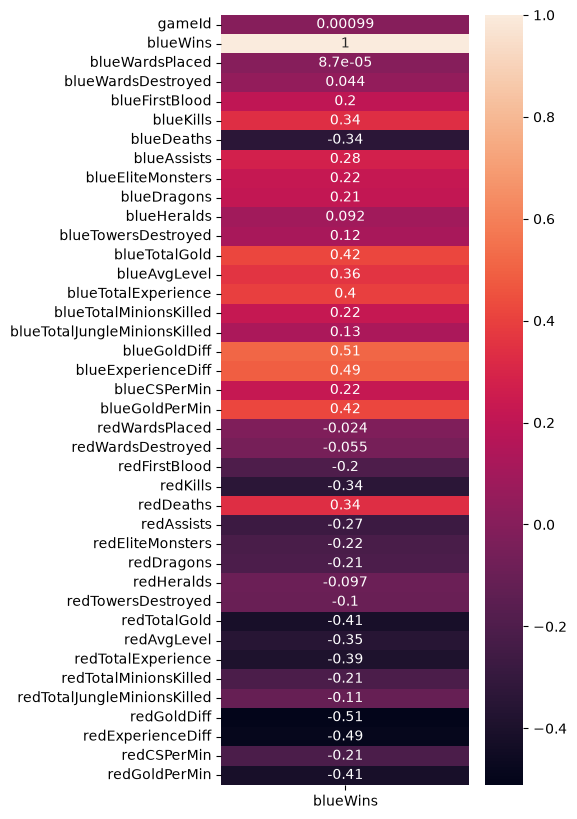
blueWins 컬럼과 가장 높은 연관성을 보이는 컬럼은 대체로 어떤 것들일까요?
blueTotalGold, blueTotalExperience, blueGoldDiff, blueExperienceDiff 인걸로 보아
10분동안 획득한 골드와 경험치 등이 영향을 주는 것 같습니다.
이제 blueGoldDiff에 대해 blueWins를 목표로 하는 시각화를 히스토그램플롯으로 파악해봅시다.
sns.histplot(data=df, x='blueGoldDiff', hue='blueWins')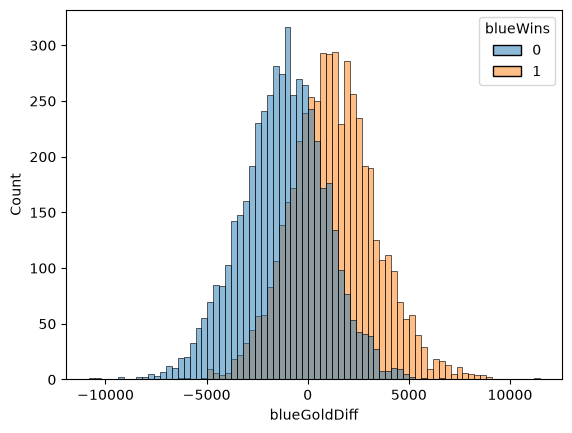
뚜렷한 형태의 히스토그램이어서 blueGoldDiff가 양수일수록 blue 팀이 이긴 경기가 많다는 의미입니다.
이는 blueGoldDiff가 승패를 가르는데 굉장히 좋은 특성임을 의미합니다.
이번에는 blueKills와 blueWins가 어떤 연관이 있는지 살펴보겠습니다.
sns.histplot(data=df, x='blueKills', hue='blueWins', palette='RdBu', kde=True, bins=10)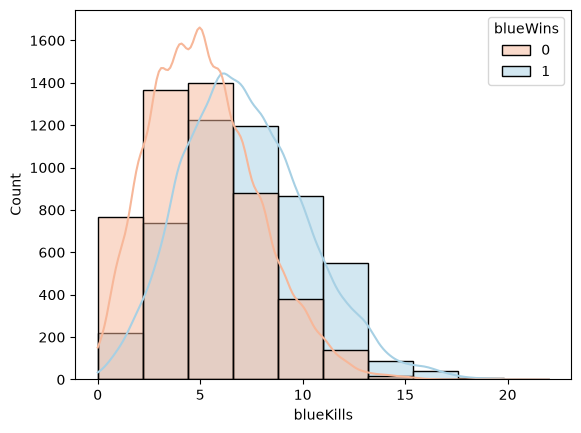
아까 blueGoldDiff만큼 뚜렷한 관계는 아닙니다. 승패를 가르는데에는 많은 영향을 준다고 보기 어렵습니다.
그러면 blueGoldDiff와 blueKills를 같이 넣고 비교해볼까요?
이럴때는 jointplot()를 사용합니다.
sns.jointplot(data=df, x='blueKills', y='blueGoldDiff', hue='blueWins')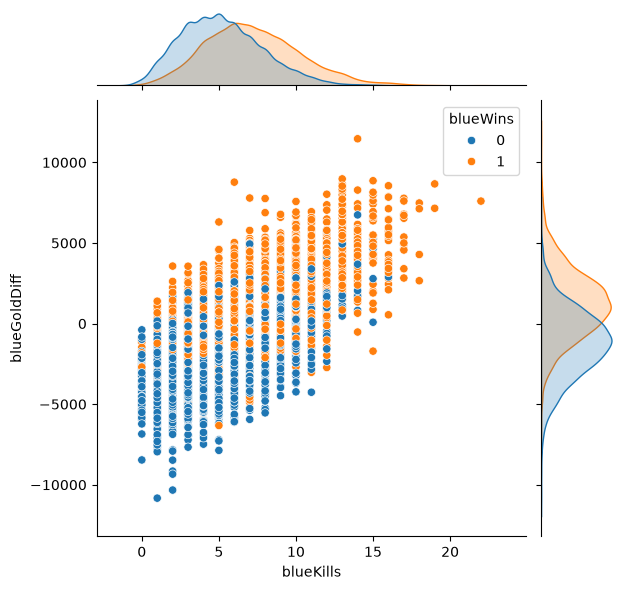
x축과 y축에는 히스토그램을, 그래프 도화지에서는 x축과 y축의 산포도를 보여줍니다.
산포도를 보면 blueKills와 blueGoldDiff가 어느정도 관련이 없다고 할 수는 없습니다.
즉 2개의 특성을 합치면 blueWins에 영향을 주는 특징을 만들 수 있다고 이해됩니다.
위에서는 숫자형 데이터와 타겟 데이터와의 영향도를 분석했습니다.
이제 분류형 데이터의 예시로 blueDragons 혹은 redDragons 컬럼을 확인해봅시다.
df.blueDragons.value_counts()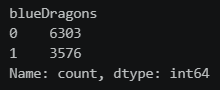
이것을 countplot()으로 시각화해봅시다.
sns.countplot(data=df, x='blueDragons', hue='blueWins')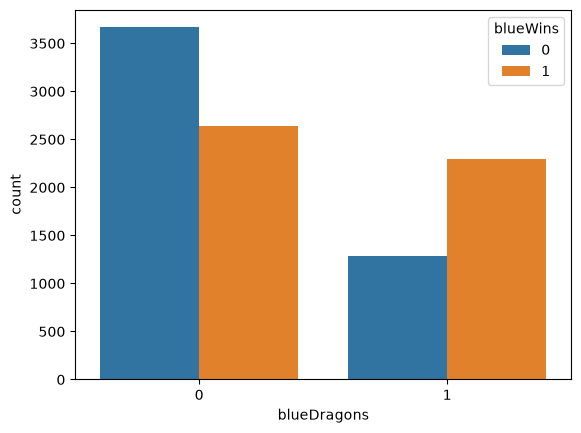
이 때 파란색과 주황색의 비율 차를 봐야합니다. 어느정도 차이가 나므로, blueWins에 영향을 준다고 봐도 될 듯 합니다.
데이터 전처리
모델 학습에 불필요한 컬럼들은 제거해야 합니다. gameId 및 red로 시작하는 컬럼들 중 일부를 제거합니다.
df.drop(
[
'gameId',
'redFirstBlood',
'redKills',
'redDeaths',
'redTotalGold',
'redTotalExperience',
'redGoldDiff',
'redExperienceDiff'
],
axis=1,
inplace=True
)
그 다음 수치형 데이터를 표준화합니다.
df에서 수치형 데이터만 모아서, X_num 변수에 담고, 분류형 데이터만 모아서, X_cat 변수에 담겠습니다.
X_num = df[
  [
    'blueWardsPlaced', 'blueWardsDestroyed', 'blueKills', 'blueDeaths', 'blueAssists',
    'blueEliteMonsters', 'blueTowersDestroyed', 'blueTotalGold',
    'blueAvgLevel', 'blueTotalExperience', 'blueTotalMinionsKilled',
    'blueTotalJungleMinionsKilled', 'blueGoldDiff', 'blueExperienceDiff', 'blueCSPerMin',
    'blueGoldPerMin', 'redWardsPlaced', 'redWardsDestroyed', 'redAssists',
    'redEliteMonsters', 'redTowersDestroyed', 'redAvgLevel', 'redTotalMinionsKilled',
    'redTotalJungleMinionsKilled', 'redCSPerMin', 'redGoldPerMin'
  ]
]

X_cat = df[['blueFirstBlood', 'blueDragons', 'blueHeralds', 'redDragons', 'redHeralds']]
이제 StandardScaler 클래스를 불러옵니다.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
X_num 변수를 스케일링 합니다.
scaler.fit(X_num)
X_scaled = scaler.transform(X_num)
X_scaled를 DataFrame으로 표현합니다. 확인해보면 수치형 데이터들이 모두 표준화 되었습니다.
X_scaled = pd.DataFrame(X_scaled, index=X_num.index, columns=X_num.columns)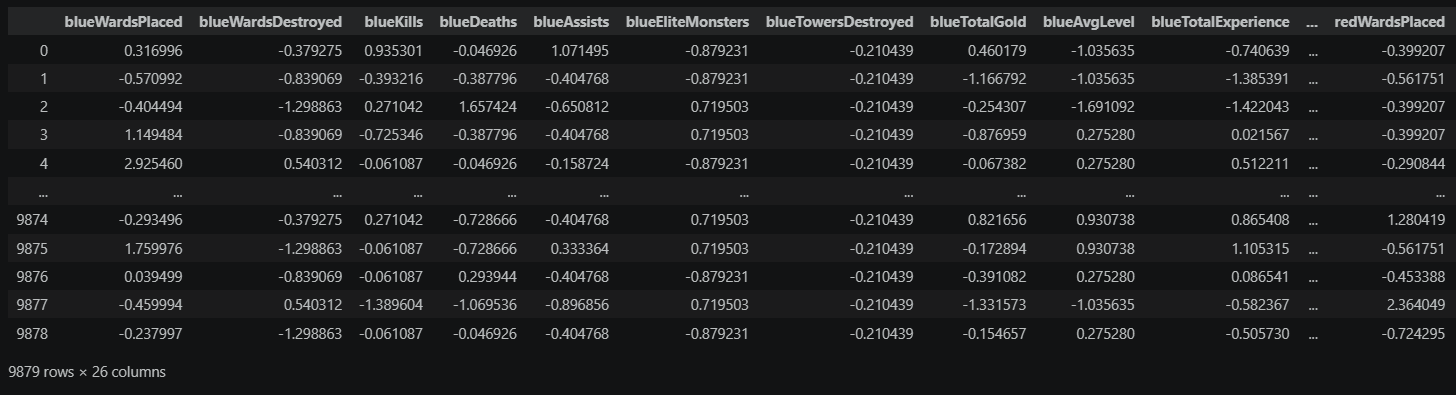
이제 이것을 분류형 데이터와 다시 합칩니다.
X = pd.concat([X_scaled, X_cat], axis=1)이제 타겟 데이터도 분류합니다.
y = df['blueWins']최적의 파라미터 찾기
위에서 만든 X와 y를 LogisticRegression 모델에 학습시키기 위한 최적의 파라미터를 찾겠습니다.
max_iter 파라미터와 C 파라미터의 하이퍼 파라미터를 찾을 것입니다.
각각 Grid 리스트로 [100, 200, 300]과 [0.5, 1.0, 1.5, 2.0]를 설정하고
GridSearchCV를 사용해 8-fold하여 Cross-Validation을 수행할 것입니다.
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV
이제 Grid Params를 구성합니다.
param_grid = {
  'max_iter': [100, 200, 300],
  'C': [0.5, 1.0, 1.5, 2.0]
}
GridSearchCV 객체를 만듭니다.
gs = GridSearchCV(LogisticRegression(), param_grid, cv=8, n_jobs=-1)
result = gs.fit(X, y)
이제 최적의 점수를 확인하겠습니다.
result.best_score_ # np.float64(0.7311460377036594)최적의 파라미터도 확인하겠습니다.
result.best_params_ # {'C': 2.0, 'max_iter': 100}이제 최적의 파라미터로 학습합니다.
gs.best_estimator_결과를 DataFrame에 표시합니다.
pd.DataFrame(result.cv_results_)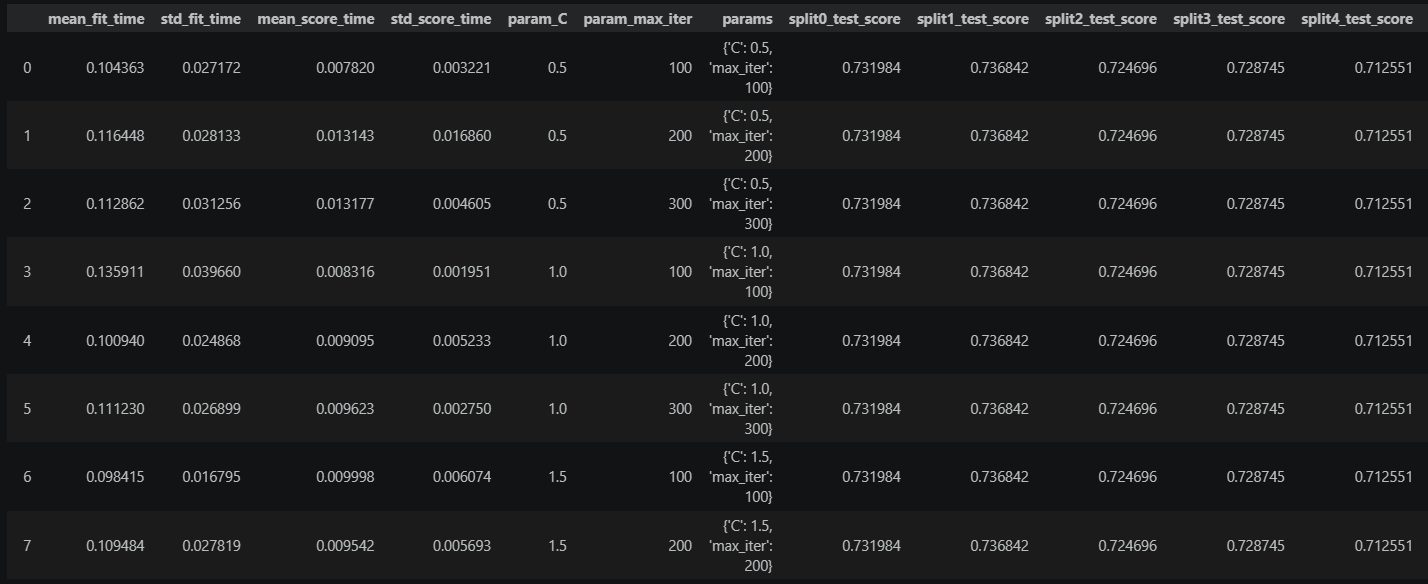
뒤에 가려져 있지만 총 8개의 점수와 경우의 수 12가지를 곱해 총 96개의 경우의 수가 나온 것입니다.
훈련 데이터 / 테스트 데이터 분리
학습용 데이터와 테스트 데이터를 7:3 비율로 분리하겠습니다.
from sklearn.model_selection import train_test_split변수는 X_train, X_test, y_train, y_test로 담겠습니다.
X_train, X_test, y_train, y_test =\
train_test_split(X, y, test_size=0.3, shuffle=True, random_state=42)
모델을 생성하고 학습하기
위에서 LogisticRegression 모델이 있으므로, 최적의 파라미터 값을 가져와 학습합니다.
model_lr = LogisticRegression(**result.best_params_)
model_lr.fit(X_train, y_train)
교차 검증
원 변수 X, y에 대해 교차 검증을 하며, 4-fold cross validation을 진행할 것입니다.
from sklearn.model_selection import cross_val_score, cross_validate교차 검증의 점수를 받아냅니다.
scores = cross_val_score(model_lr, X, y, cv=4)
print(scores) # [0.7340081  0.7242915  0.73198381 0.73106521]
평균값을 계산합니다.
np.mean(scores) # np.float64(0.7303371523490472)학습 결과 평가
테스트 데이터에 대한 예측값을 내어보고, 예측값에 대한 분류 리포트를 작성합니다.
from sklearn.metrics import classification_report모델을 통해 예측해봅니다.
pred = model_lr.predict(X_test)각 클래스별 점수를 출력합니다.
print(classification_report(y_test, pred))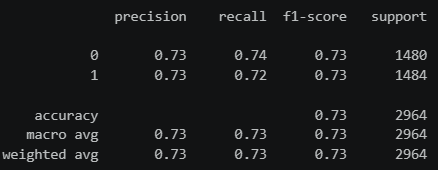
그리고, 승패에 가장 중요한 영향을 끼친 Feature를 뽑아보겠습니다.
먼저 xgboost를 불러옵니다.
from xgboost import XGBClassifier클래스 객체를 생성합니다. 그리고, 학습합니다.
model_xgb = XGBClassifier()
model_xgb.fit(X_train, y_train)
특성 중요도를 뽑아봅니다.
print(model_xgb.feature_importances_)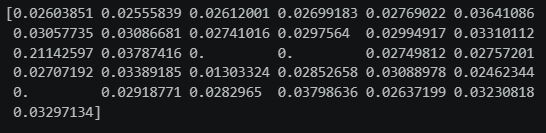
현재 특성들의 개수가 많으므로, 시각화해서 보겠습니다.
plt.bar(X.columns, model_xgb.feature_importances_)
plt.xticks(rotation=90)
plt.show()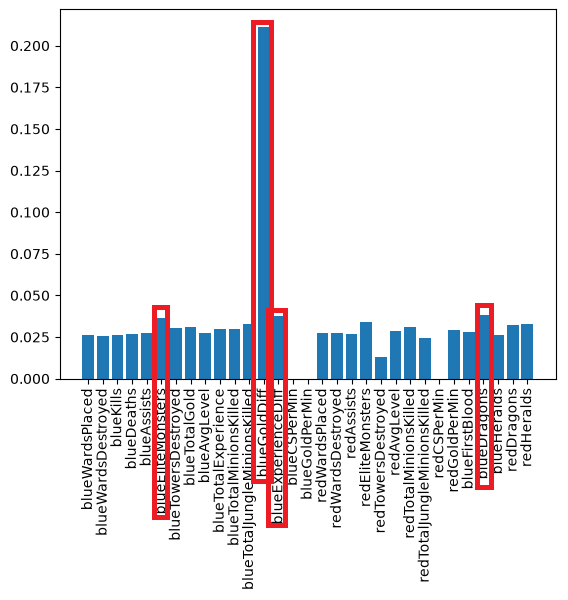
위와 같은 특성들이 blueWins에 많은 영향을 주었습니다.