인공신경망(Artificial Neural Network)
먼저 데이터셋을 가져오겠습니다. FashionMINIST는 패션 아이템 이미지로 구성됩니다.
28x28 grayscale 이미지로, 10개의 classes가 있습니다.
먼저 tensorflow 라이브러리를 불러옵니다.
import tensorflow as tftensorflow에서 제공하는 고수준 API인 keras를 불러옵니다.
from tensorflow import keras그리고 각 실행마다 동일한 결과 얻기 위해 keras에 랜덤 시드를 적용합니다.
def set_seed(seed = 42):
  tf.keras.utils.set_random_seed(seed)
  tf.config.experimental.enable_op_determinism() # 결정적 연산
이제 FashionMINIST 데이터를 다운로드합니다.
(train_input, train_target), (test_input, test_target) =\
keras.datasets.fashion_mnist.load_data()
각각의 shape를 확인하면 훈련 데이터는 60,000개 / 테스트 데이터는 10,000개 입니다.
print(train_input.shape) # (60000, 28, 28)
print(test_input.shape) # (10000, 28, 28)
첫 10장의 샘플을 시각화해보겠습니다.
fig, axs = plt.subplots(1, 10, figsize=(10, 10))

for i in range(10):
  axs[i].set_title(train_target[i])
  axs[i].imshow(train_input[i], cmap='gray')
  axs[i].axis('off')

plt.show()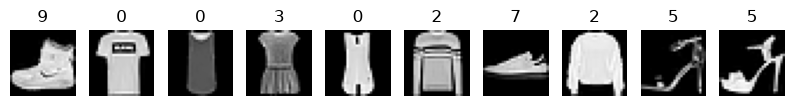
그리고 각 레이블 당 샘플 개수도 확인해보겠습니다.
print(np.unique(train_target, return_counts=True))
이제 데이터 학습에 앞서, 각 픽셀값을 0 ~ 1 사이의 값으로 정규화하겠습니다.
train_scaled = train_input / 255.0그리고 이것을 1차원 배열로 펼칩니다.
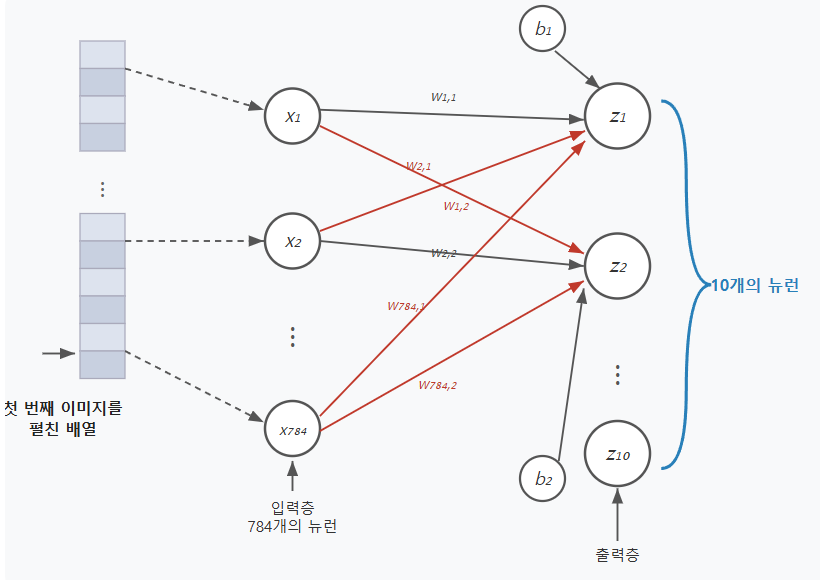
train_scaled = train_scaled.reshape(-1, 28 * 28)인공 신경망을 본격적으로 사용하기 전에, 인공 신경망은 확률적 경사 하강법을 사용하는 로지스틱 회귀와 같습니다.
현재 28 x 28 = 784개를 1차원으로 펼친 상황에서 784개를 입력을 받아, 10개의 출력으로 받아야 합니다.
참고로 인공 신경망에서는 한번 실행하므로, 교차 검증을 사용하지 않고, 검증 세트를 별도로 덜어내어 사용합니다.
그래서 훈련 세트에서 20%만 검증 세트로 덜어내어 봅니다.
from sklearn.model_selection import train_test_split

train_scaled, val_scaled, train_target, val_target =\
train_test_split(train_scaled, train_target, test_size=0.2, random_state=42)
훈련 세트와 검증 세트의 shape를 확인하여 봅니다.
print(train_scaled.shape) # (48000, 784)
print(val_scaled.shape) # (12000, 784)
keras의 Layer 중에 뉴런으로 구성된 Layer가 밀집층(Dense Layer)입니다.
Dense Layer는 연결을 해놓으면 앞선 Input Layer와 다 연결이 됩니다. 혹은 Fully Connected Layer라고도 합니다.
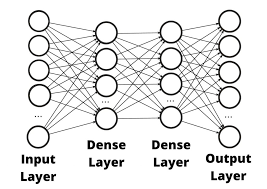
Keras에서는 Input Layer와 Dense Layer를 제공하는데
Input Layer에서는 shape를 지정해주고, Dense Layer에서는 출력 개수(units)와 활성화 함수(activation)을 지정합니다.
그러면 2개의 Layer를 생성해보겠습니다.
inputs = keras.Input(shape=(28 * 28,))
dense = keras.layers.Dense(units=10, activation='softmax')
이제 위의 밀집층을 가진 신경망 모델을 정의하겠습니다. keras의 Sequential 객체를 사용합니다.
model = keras.Sequential(layers=[inputs, dense])keras는 훈련하기 전 compile 과정을 거치는데 이 때 loss로 손실 함수를 지정하고, metrics로 측정방법을 지정합니다.
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])여기서 손실 함수의 의미는 다중 분류 시 입력값이 정수값 형태의 크로스 엔트로피 손실 함수입니다.
추가로, FashionMNIST의 타겟값을 확인해보면 정수값으로 되어있습니다.
print(train_target[:10]) # [7 3 5 8 6 9 3 3 9 9]TensorFlow에서는 타겟값을 One-Hot Encoding 하지 않아도 사용 가능합니다.
이것이 sparse_categorical_crossentropy 입니다.
이제 훈련을 해보겠습니다.
model.fit(train_scaled, train_target, epochs=5)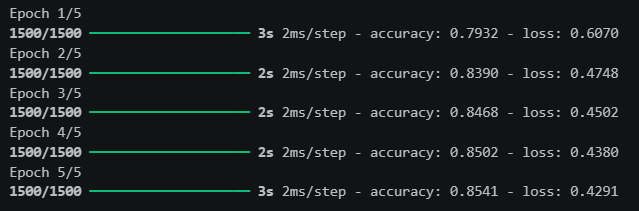
여기서 Keras는 Mini-Batch 방식을 사용하는데 훈련데이터 크기(48,000) / 기본 배치 크기(32개) = 1500개를 사용합니다.
그리고, step은 하나의 데이터(배치) 입력되고, Loss 값 계산되고 역전파를 통해 가중치(W)를 업데이트하는 과정입니다.
epoch를 반복함에 따라 정확도는 늘어나고, Loss 값은 낮아지고 있는 모습입니다.
학습이 끝나고, 평가를 할 땐 evaluate() 함수를 사용합니다. 각각 Loss 값과 Accuracy를 의미합니다.
model.evaluate(val_scaled, val_target) # 검증 점수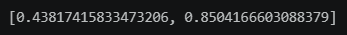
심층신경망(Deep Neural Network)
입력 층(Input Layer)와 출력 층(Output Layer) 사이에 은닉 층(Hidden Layer)를 추가합니다.
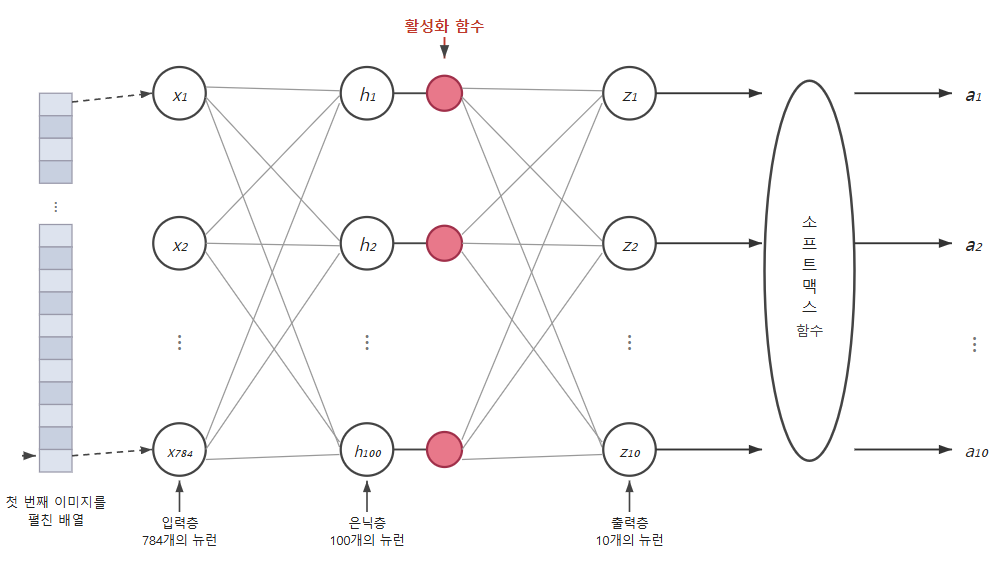
Hidden Layer는 Sigmoid 함수로, Output Layer는 Softmax 함수로 설정합니다.
inputs = keras.Input(shape=(28 * 28, ))
dense1 = keras.layers.Dense(100, activation='sigmoid')
dense2 = keras.layers.Dense(10, activation='softmax')
DNN 모델을 만듭니다.
model = keras.Sequential([inputs, dense1, dense2])추가로, Keras에서는 모델 Layer에 대한 정보를 출력해줍니다.
model.summary()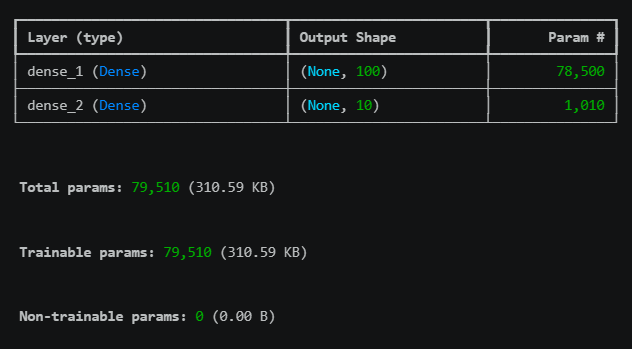
여기서 모델 파라미터의 개수에 대해 살펴보면
dense1 입력 층은 (입력(784) + bias) x 은닉층(100) = 78,500개 입니다.
dense2 입력 층은 (입력(100) + bias) x 출력층(10) = 1,010개 입니다.
이제 모델을 만들었으니 학습을 진행합시다.
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])
model.fit(train_scaled, train_target, epochs=5)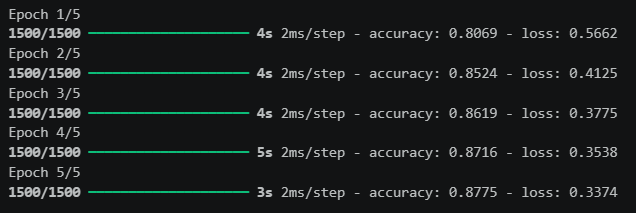
파라미터 개수가 늘어났으므로, 학습 시간이 더 걸렸습니다. 하지만 accuracy는 증가하고, Loss는 감소했습니다.
여기서 활성화 함수에서 기울기 소실 문제가 발생합니다.
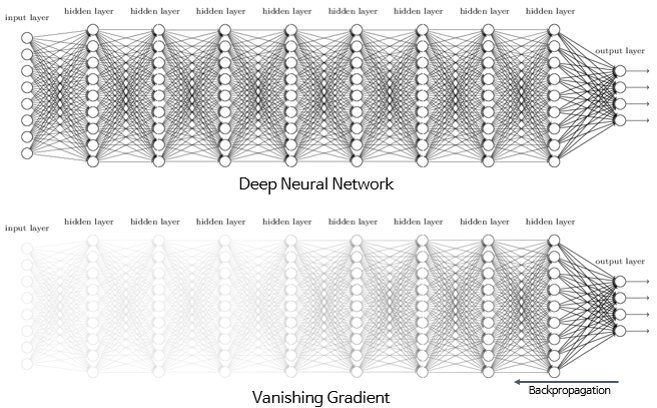
우리가 dense1의 활성화 함수로 sigmoid 함수를 사용했으므로, 입력값과 상관없이 0 ~ 1 사이로 변환합니다.
그래서 역전파해서 W값을 업데이트할 때 이전의 기울기에 대한 정보가 소실됩니다.
그래서 이런 문제를 개선하고자, ReLU 활성화 함수가 등장합니다.
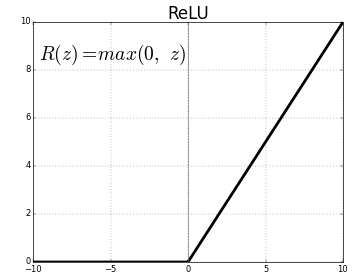
ReLU 함수는 0보다 작을 때는 0값으로 0보다 클 때는 그대로 출력해주는 함수입니다.
그리고, Flatten Layer에 대해 추가로 소개하면, Batch 차원을 제외하고 나머지 입력 차원을 모두 flatten 하는 역할입니다.
앞에서 Batch 차원 외의 데이터를 1차원으로 직접 reshape 해야 했는데 그 과정을 Flatten Layer에 적용한 것입니다.
이것은 참고로 학습되는 Layer는 아닙니다.
Flatten Layer와 ReLU 함수를 적용하여 모델을 새로 만듭니다.
model = keras.Sequential()
model.add(keras.layers.Input(shape=(28, 28)))
model.add(keras.layers.Flatten())
model.add(keras.layers.Dense(100, activation='relu'))
model.add(keras.layers.Dense(10, activation='softmax'))
summary()를 통해 Layer 정보를 확인하겠습니다.
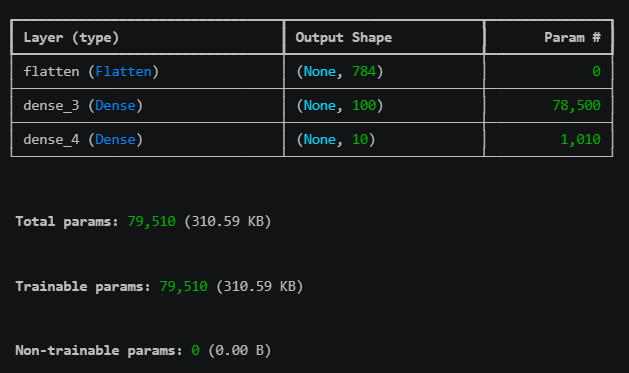
다시 데이터를 Batch 차원 제외 2차원 데이터로 준비합니다.
(train_input, train_target), (test_input, test_target) =\
keras.datasets.fashion_mnist.load_data()

train_scaled = train_input / 255.0

train_scaled, val_scaled, train_target, val_target =\
train_test_split(train_scaled, train_target, test_size=0.2, random_state=42)
모델을 다시 학습합니다.
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])
model.fit(train_scaled, train_target, epochs=5)
검증 세트로 성능 평가를 해봅니다.
model.evaluate(val_scaled, val_target) # [0.3637973964214325, 0.878083348274231]최종적으로 Sigmoid 함수를 쓴것보다 조금 효과가 좋은 모습이었습니다
이제 하나의 Batch를 입력해서 Loss값을 구했다면, 역전파(Back Propation)를 통해서 W를 구하는 과정이 있습니다.
W값이 구해졌다면 이제 W값을 업데이트해야 하는데, 그 옮기는 작업이 Optimizer입니다.
Optimizer는 compile() 단계에서 셋팅해줘야 하는데, 기본값은 RMSprop이라고 하는 알고리즘입니다.
그리고, W를 얼마만큼 조정하는지에 해당하는 learning_rate(학습률) 값을 조정할 수 있습니다.
그리고 함수의 형태에 따라 결과를 평가할 수 있습니다.
먼저, Convex Function (볼록 함수)는 어느 방향에서 시작하든지 Loss가 낮은 위치에 잘 정착을 하게 됩니다.
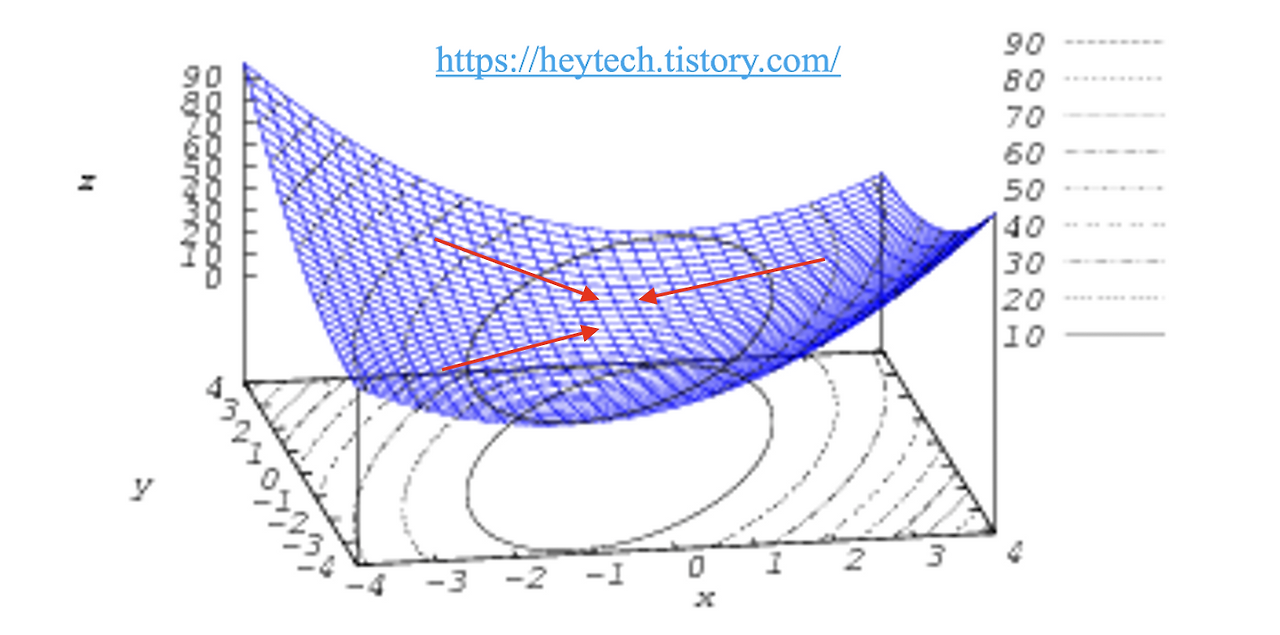
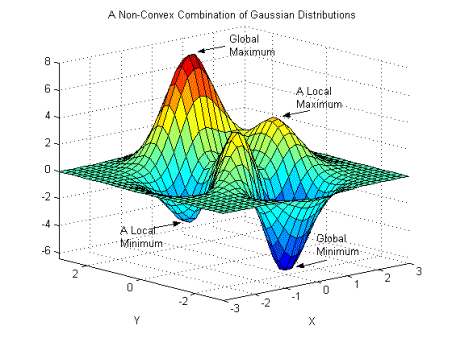
근데, 현실은 어느 곳이 최저점을 찾는지 만만치가 않아, 비 볼록 함수(Non-Convec) 형태로 나올 수 있습니다.
출발점이 랜덤하므로, 어떤 출발점에서 Loss가 낮은 목표점을 향해갈 때 실제 최저점에 미치지 못한 곳에서 끝날 수 있습니다.
이를 Local Minimum 이라고 부릅니다. 실제 Loss가 낮은 목표점은 Global Minimum입니다.
그래서 Local Minimum에 빠지지 않도록 고민해야 합니다.
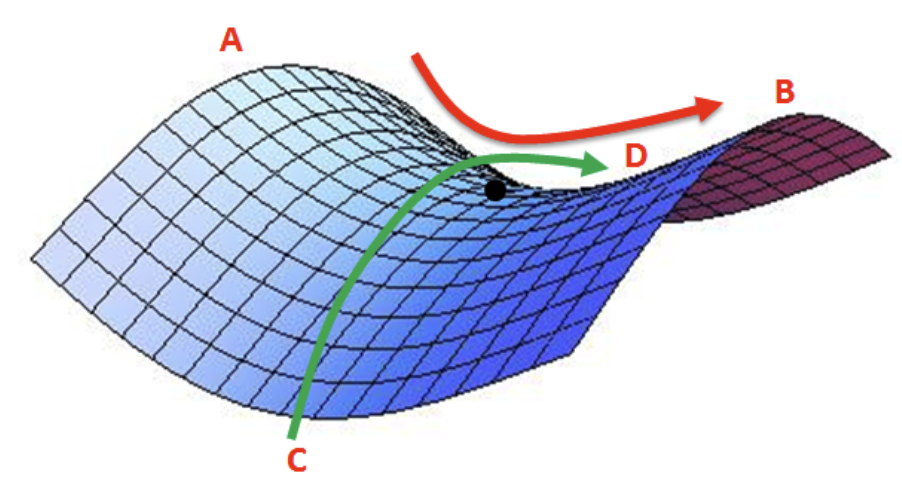
또한 Saddle Point 문제에 빠집니다.
어떤 랜덤한 위치에서 W값을 조정해 나갈 때 다른 방향으로 가면 더 낮은 Loss를 향해 갈 수 있는데
그 방향을 찾지 못하는 현상입니다.
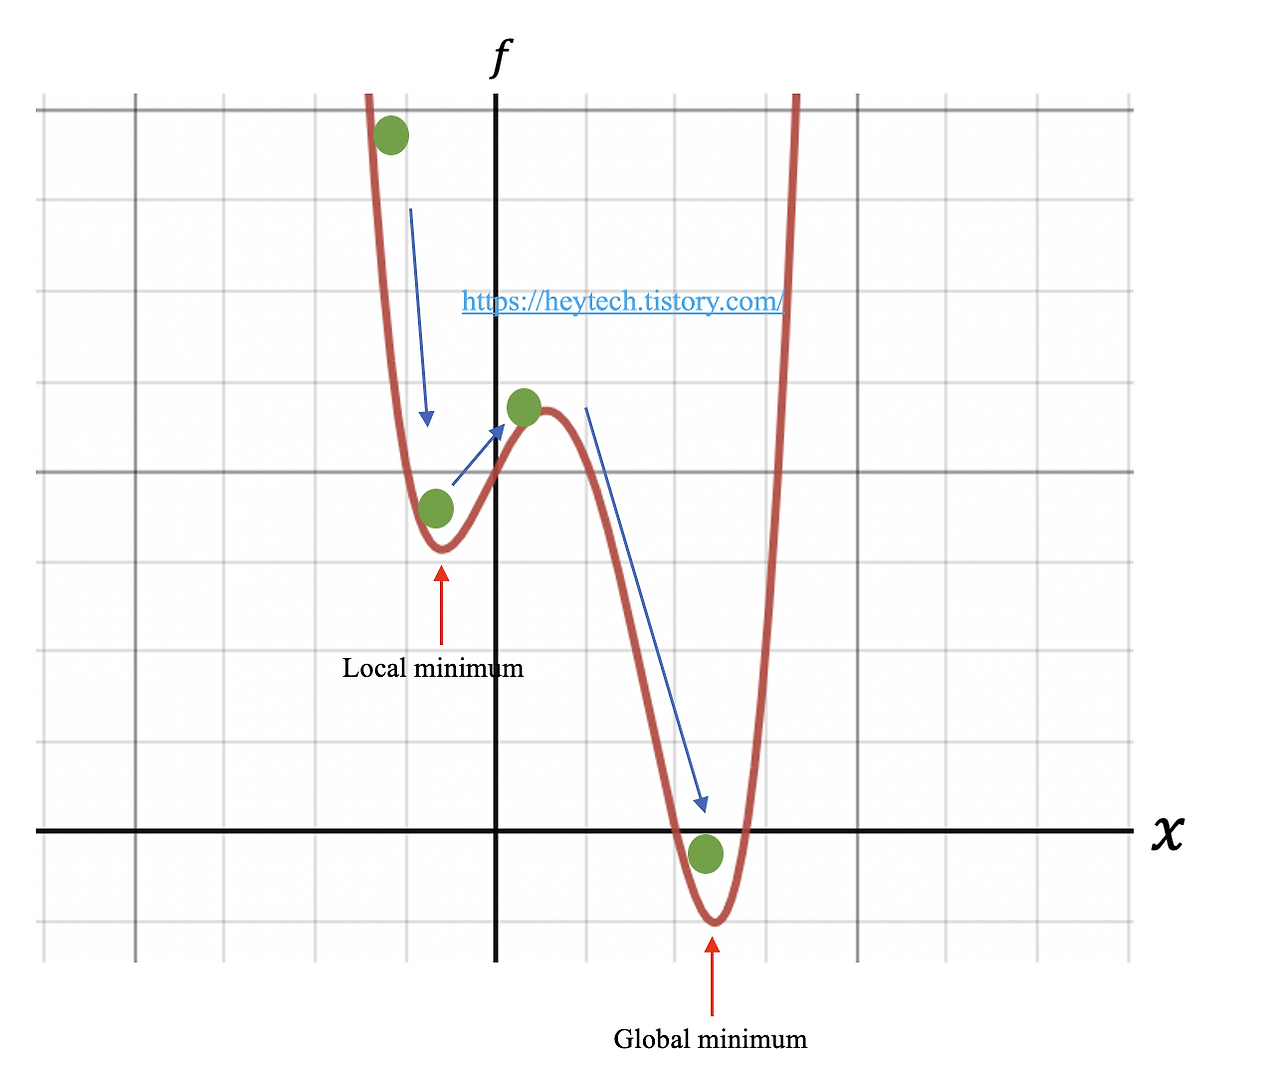
먼저, Local Minimum을 탈출하기 위해 Optimizer 함수가 사용하는 방법이 Momentum 입니다.
W값을 이동하면서 Loss 값이 떨어지는 것을 보다가, 일정 구간에서 치솟기 시작합니다. 일반적인 형태에선 이 때 멈춥니다.
그런데 Local Minimum의 가능성을 배제할 수 없어 몇번은 더 이동하여 다른쪽으로 낮아지는 구간이 있는지를 확인합니다.
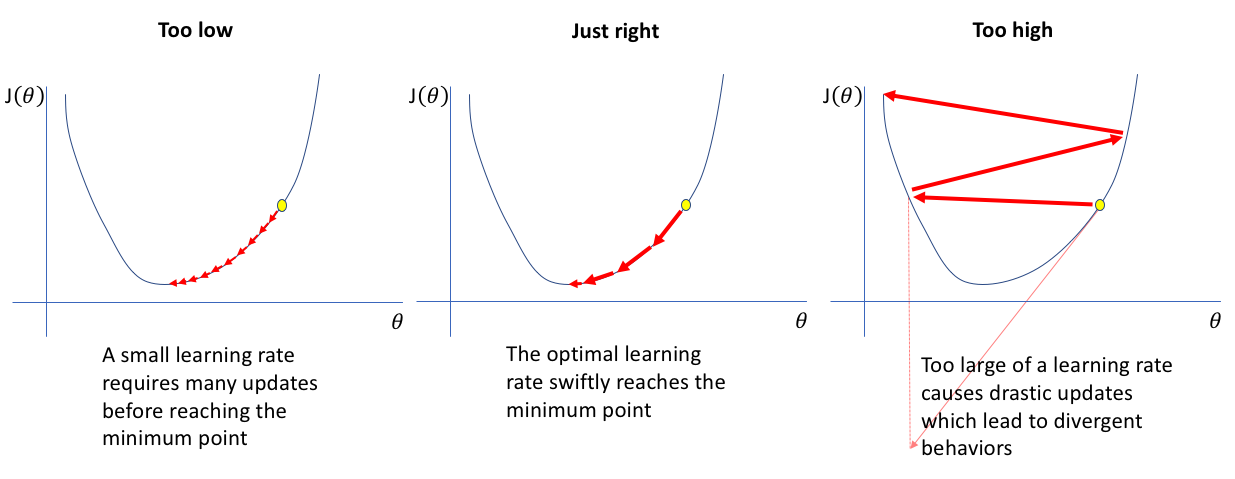
또 다른 해결 매커니즘은 가변적인 learning_rate를 가지는 것입니다.
학습률(learning_rate)이 너무 작다면, Local Minimum에 빠질 수도 있습니다.
반대로 너무 크다면, 한번 움직일 때 오히려 Loss 값이 오를 수 있습니다.
그래서 타협점을 이용하는데 처음에 기울기가 셀 때는 이동을 크게 했다가, 기울기가 낮아질수록 이동도 줄여나갑니다.
이 Optimizer 함수 중 하나가 SGD Optimizer 입니다.
이 때 파라미터로 learning_rate와 momentum이 있습니다.
SGD Optimizer를 이용해 모델을 컴파일합니다. 이 때, learning_rate를 0.1로 셋팅해서 컴파일해보겠습니다.
여기서 nesterov는 momentum을 2번 반복해 최적화하는 과정입니다.
sgd = keras.optimizers.SGD(learning_rate=0.1, nesterov=True)

model.compile(
  optimizer=sgd,
  loss='sparse_categorical_crossentropy',
  metrics=['accuarcy']
)
그리고 이와 반대로 learning_rate가 가변적인 Optimizer인 RMSprop 함수가 있습니다. 또, AdaGrad가 있습니다.
모델의 최적점에 가까이 갈 수록 학습률을 낮추어 나가, 안정적인 최적점에 수렴할 가능성을 높입니다.
adagrad = keras.optimizers.Adagrad()
model.compile(optimizer=adagrad, loss='sparse_categorial_crossentropy', metrics=['accuracy'])
그리고, RMSprop과 momentum의 장점을 결합한 것이 Adam Optimizer입니다.
이것을 사용하여 훈련시켜봅니다.
model = keras.Sequential()

model.add(keras.layers.Input(shape=(28, 28)))
model.add(keras.layers.Flatten())
model.add(keras.layers.Dense(100, activation='relu'))
model.add(keras.layers.Dense(10, activation='softmax'))

model.compile(
  optimizer='adam',
  loss='sparse_categorical_crossentropy',
  metrics=['accuracy']
)

model.fit(train_scaled, train_target, epochs=5)

model.evaluate(val_scaled, val_target) # [0.3420788049697876, 0.8815833330154419]