신경망 모델 훈련
사이킷런의 머신러닝 알고리즘은 모델의 구조가 고정되어 있고, 좋은 성능을 위해 매개변수를 추가했다면
딥러닝 알고리즘은 모델의 구조를 직접 만드는 방식입니다.
먼저 데이터를 준비하겠습니다.
from sklearn.model_selection import train_test_split

(train_input, train_target), (test_input, test_target) =\
keras.datasets.fashion_mnist.load_data()
정규화 작업을 거치겠습니다.
train_scaled = train_input / 255.0
test_scaled = test_input / 255.0
훈련 데이터에서 20%를 검증 데이터로 구성합니다.
train_scaled, val_scaled, train_target, val_target =\
train_test_split(train_scaled, train_target, test_size=0.2, random_state=42)
각 분할한 데이터들의 shape를 확인해보겠습니다.
print(train_scaled.shape) # (48000, 28, 28)
print(val_scaled.shape) # (12000, 28, 28)
print(test_scaled.shape) # (10000, 28, 28)
모델 훈련할 때, fit() 함수를 사용하는데 이 때 이 함수는 History 객체를 리턴합니다.
History 객체에는 훈련 과정에서 계산한 지표 즉, Loss 값과 Accuracy 값이 저장되어 있습니다.
우선 모델을 만드는 함수부터 정의해보겠습니다.
def model_fn(a_layer=None):
  set_seed(42)
  model = keras.Sequential()
  model.add(keras.layers.Input(shape=(28, 28)))
  model.add(keras.layers.Flatten())
  model.add(keras.layers.Dense(100, activation='relu'))
  if a_layer:
    model.add(a_layer)
  model.add(keras.layers.Dense(10, activation='softmax'))
  return model
일단 매개변수를 추가하지 않고, 모델을 만들면 기존에 만들었던 모델과 동일할 것입니다.
model = model_fn()그리고 이전과 동일하게 모델을 훈련하지만, fit() 메소드의 결과를 history 변수에 담아보겠습니다.
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])

history = model.fit(train_scaled, train_target, epochs=5, verbose=0)
history 객체의 구조에 대해 살펴보겠습니다.
print(history.history)
# {'accuracy':
#   [0.8112499713897705,
#    0.8586458563804626,
#    0.8727708458900452,
#    0.8809166550636292,
#    0.8888333439826965],
#  'loss':
#   [0.5311373472213745,
#    0.3905622661113739,
#    0.35328060388565063,
#    0.3294256031513214,
#    0.31286561489105225]
# }
history 객체에는 loss와 accuracy 키가 포함되어 있는 딕셔너리 구조가 있는 것입니다.
history.history.keys() # dict_keys(['accuracy', 'loss'])이것을 가지고 Loss Curve(손실 곡선)을 그립니다. overfit이 되어있는지 훈련이 잘되었는지 확인하기 위해 꼭 확인합니다.
먼저, Trainng Loss(훈련 손실)을 시각화해보겠습니다.
plt.plot(history.history['loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.show()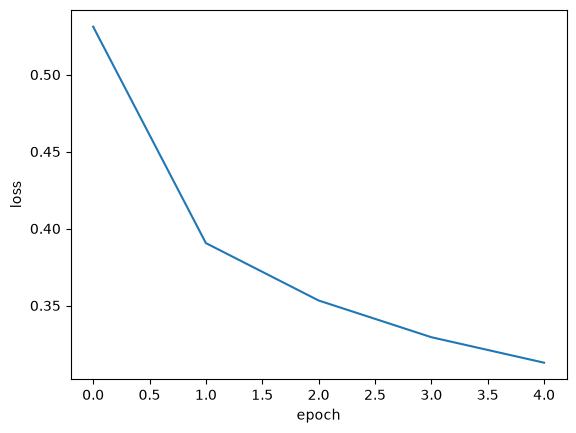
에포크가 증가함에 따라, 훈련 데이터 손실이 줄어듭니다.
이제 정확도(Accuracy)를 출력해보겠습니다.
plt.plot(history.history['accuracy'])
plt.xlabel('epoch')
plt.ylabel('accuracy')
plt.show()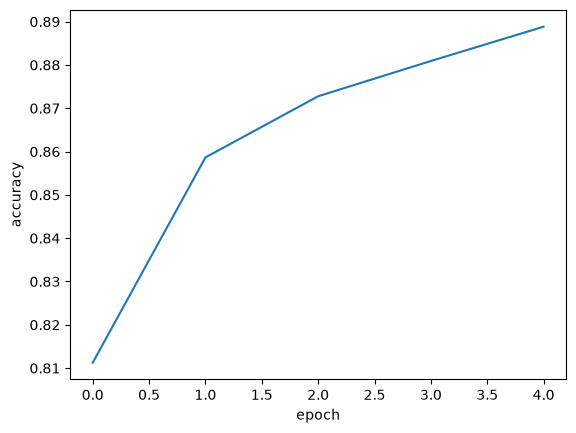
반대로 에포크가 늘어남에 따라 정확도 늘어나는 비율은 줄었지만, 계속 늘어나고 있습니다.
그렇다면, 에포크 횟수를 늘려보겠습니다.
model = model_fn()
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])

history = model.fit(train_scaled, train_target, epochs=20, verbose=0)

print(history.history['loss'])

'''
[
0.5311373472213745,
0.3905622661113739,
0.35328060388565063,
0.3294256031513214,
0.31286561489105225,
0.29897382855415344,
0.2885262966156006,
0.27921444177627563,
0.2718169093132019,
0.2636784613132477,
0.25776195526123047,
0.2503141164779663,
0.24564456939697266,
0.24092741310596466,
0.2339295595884323,
0.23119240999221802,
0.22725197672843933,
0.2214163839817047,
0.21717773377895355,
0.2143624871969223]
'''
Loss 값이 줄어드는 변화를 시각화해보겠습니다.
plt.plot(history.history['loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.show()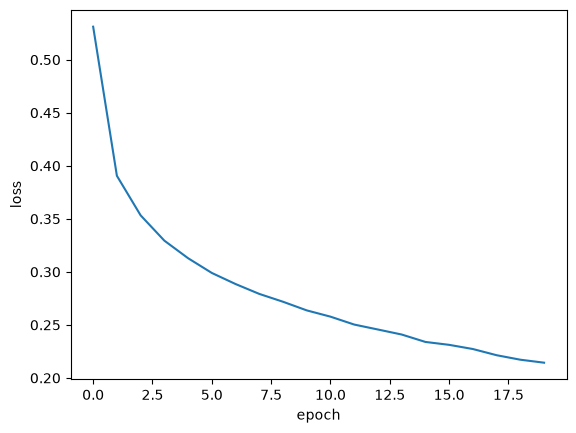
epoch가 증가함에 따라 Loss 값은 줄어들고 있지만, 이것은 훈련 데이터에 대한 손실 값입니다.
하지만 궁극적으로 테스트나 검증용 데이터에서 지표가 잘 나와야 합니다.
그래서 Keras에서는 별도로 준비한 검증용 데이터에 대한 손실값과 정확도도 계산해줍니다.
검증용 데이터에서 일정 구간에서 Overfit 되는 부분을 찾아야 합니다.
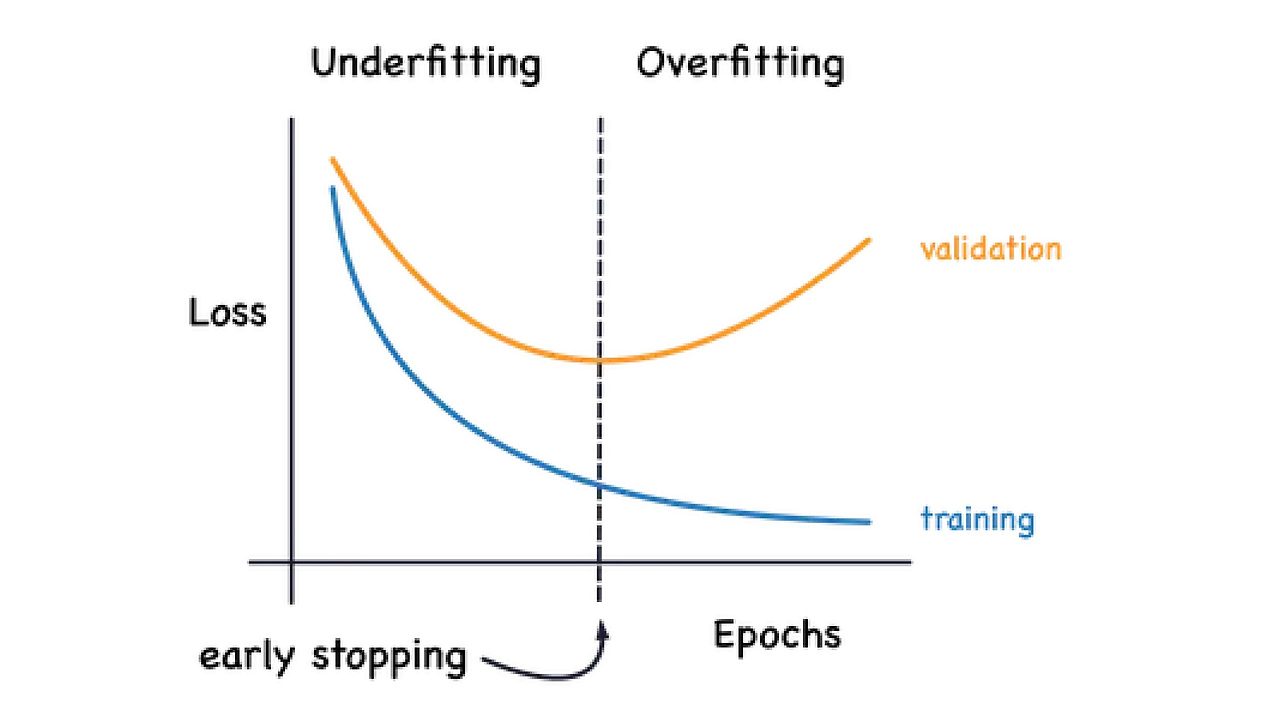
Keras에서는 fit() 매개변수로 validation_data에 검증 데이터를 전달할 수 있습니다.
model = model_fn()
model.compile(loss='sparse_categorical_crossentropy', metrics=['accuracy'])

history = model.fit(
  train_scaled, train_target, epochs=20, validation_data=(val_scaled, val_target)
)
key 값을 확인해보면 val_loss와 val_accuracy가 추가되어 있습니다.
history.history.keys() # dict_keys(['accuracy', 'loss', 'val_accuracy', 'val_loss'])과대, 과소 적합에 대한 문제를 조사하기 위해 비교 시각화를 합니다.
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.show()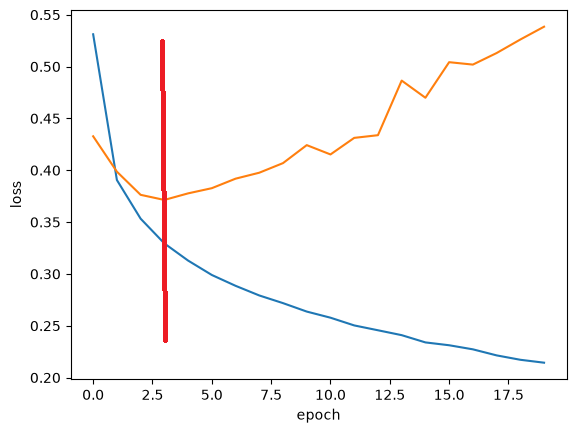
비교 결과, epoch가 3 ~ 4 사이에서 overfit 되고 있습니다.
신경망은 이렇게 overfit이 잘되서 overfit을 막기 위해 규제(Regularization)을 적용합니다.
일단, optimizer의 파라미터를 조정해서 overfit을 막을 수 있나 확인하겠습니다.
optimizer 함수로 Adam을 사용해보겠습니다.
model = model_fn()
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
history = model.fit(
  train_scaled, train_target, epochs=20, validation_data=(val_scaled, val_target)
)
이것을 이용해 Loss Curve를 확인하겠습니다.
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.legend(['train', 'val'])
plt.show()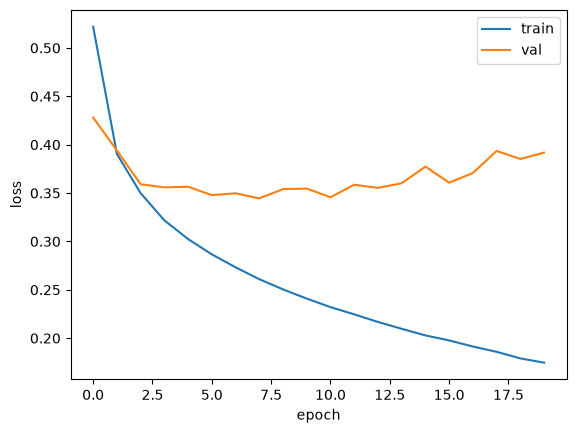
치솟는 정도와 치솟기 시작하는 epoch 지점이 훨씬 뒤로 간 모습입니다. 어느 정도 overfit이 많이 억제되었습니다.
이제 신경망에서 대표적으로 사용하는 규제인 드롭아웃(Dropout)에 대해 알아보겠습니다.
훈련과정에서 층에서 있는 일부 뉴런을 랜덤하게 꺼서 과대 적합을 억제하는 것입니다.
특정 뉴런에 과대하게 의존하는 것을 줄여 마치 여러 개의 신경망을 앙상블하는 것처럼 동작합니다.
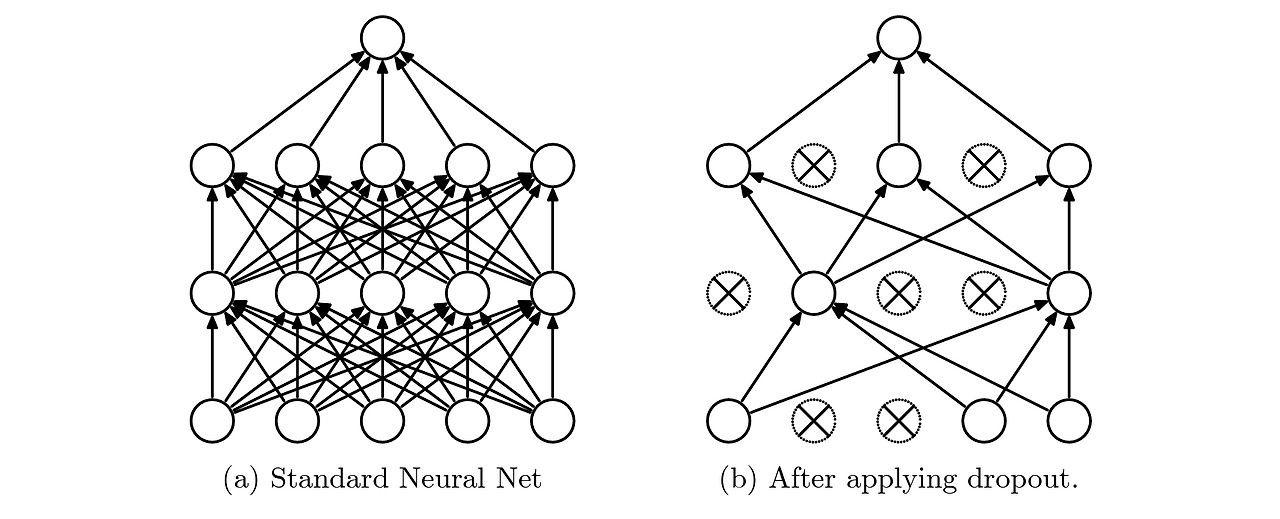
Keras에서는 Dropout이라는 층(Layer)으로 제공해줍니다. 층(Layer)처럼 사용되지만 훈련되지는 않습니다.
model = model_fn(keras.layers.Dropout(rate=0.3))summary()로 확인해보면 Hidden Layer 다음에 Dropout Layer가 붙어있습니다.
model.summary()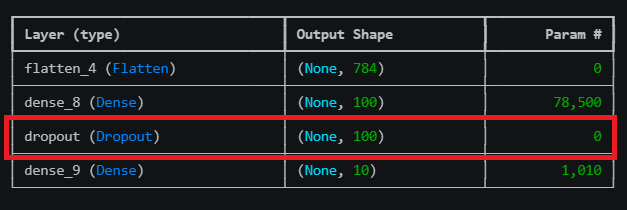
훈련하고, 훈련 손실과 검증 손실의 그래프를 그려 비교하겠습니다.
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
history = model.fit(
  train_scaled, train_target, epochs=20, validation_data=(val_scaled, val_target)
)

plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.legend(['train', 'val'])
plt.show()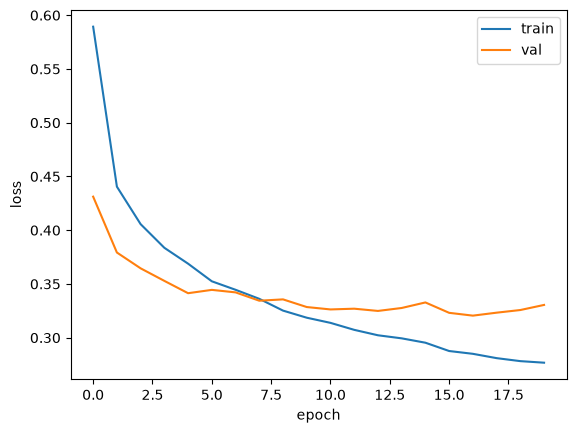
epoch가 20 근방까지도 Loss 값이 떨어지는 모습으로 overfit 성향을 굉장히 많이 억제한 모양입니다.
이런 모델을 저장하는 기능을 Keras에서 제공하는데
모델을 저장한다는 건 모델의 구조, W값, 옵티마이저 등을 한번에 저장하거나, 혹은 일부만 저장할 수 있습니다.
먼저 epoch를 10으로 지정하고 모델을 훈련하겠습니다
model = model_fn(keras.layers.Dropout(0.3))
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
history = model.fit(
  train_scaled, train_target, epochs=10, validation_data=(val_scaled, val_target)
)
그리고, W값을 저장하겠습니다.
model.save_weights('./data/model.weights.h5')그리고 h5 파일을 이용해 모델 파라미터를 읽어올 수 있습니다. 단, 저장했던 모델과 같은 구조를 가져야 합니다.
new_model = model_fn(keras.layers.Dropout(0.3))
new_model.load_weights('./data/model.weights.h5')
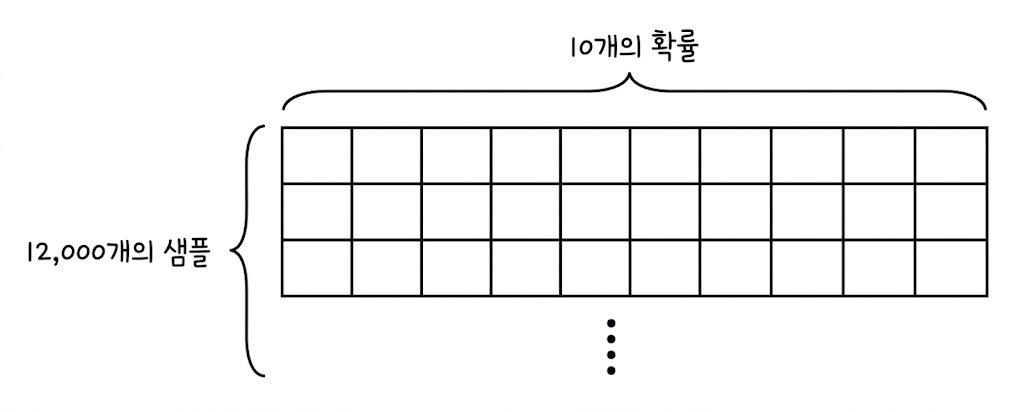
이제 predict() 함수 통해 샘플마다 10개의 클래스에 대한 확률을 예측합니다.
현재 검증 세트의 샘플 개수는 12,000개이므로, (12000, 10) 크기의 배열을 리턴할 것입니다.
이 10개 확률 중에 가장 큰 값의 인덱스를 골라 타겟 레이블과 비교해 정확도를 계산해보겠습니다.
여기서 evaluate()를 쓰지 않는 이유는 evaluate()는 손실을 계산하기 위해 먼저 compile() 단계를 거쳐야 하기 때문입니다.
여기서는 새로운 데이터에 대한 정확도만 계산하면 되므로 굳이 evaluate()를 쓰지 않습니다.
val_labels = np.argmax(new_model.predict(val_scaled), axis=-1)
# array([8, 8, 7, ..., 8, 8, 6], shape=(12000,))
argmax()로 고른 인덱스(val_labels)와 타겟값(val_target)을 비교합니다.
print(np.mean(val_labels == val_target)) # 0.8825이 값은 앞서서 model로 훈련한 검증 데이터의 accuracy와 같습니다.
다음으로 save() 함수는 모델 구조 및 훈련된 모델 파라미터(W), 모델의 컴파일 정보 등을 저장합니다.
model.save('./data/model-whole.keras')이제 이 저장한 모델을 불러옵니다.
new_model = keras.models.load_model('./data/model-whole.keras')여기서는 optimizer 정보도 가지고 있으므로, evaluate()로 계산합니다.
new_model.evaluate(val_scaled, val_target) # [0.33049124479293823, 0.8845833539962769]그런데 20번 에포크 동안 학습하고 나서, 검증 손실이 상승하는 지점을 파악하고 미리 멈춰주면 좋을 것 같습니다.
학습 도중에 무언가를 할 수 있게 하는 객체를 Callback(콜백) 이라고 합니다.
fit() 함수에 callbacks 매개변수로 전달하여 사용합니다.
그 중 첫번째 콜백으로 ModelCheckpoint 콜백을 사용하겠습니다.
매개변수로 save_best_only를 True로 만들어 가장 낮은 검증 점수를 가진 모델만 저장할 수 있습니다.
model = model_fn(keras.layers.Dropout(0.3))
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

checkpoint_cb = keras.callbacks.ModelCheckpoint('./data/best-model.keras', save_best_only=True)

model.fit(
  train_scaled,
  train_target,
  epochs=20,
  validation_data=(val_scaled, val_target),
  callbacks=[checkpoint_cb]
)
앞에서 저장했던 모델을 load_model() 함수로 읽어서 예측해봅니다.
model = keras.models.load_model('./data/best-model.keras')
model.evaluate(val_scaled, val_target) # [0.32053202390670776, 0.8851666450500488]
즉 17번째 epoch에서 학습된 모델이었습니다.
두번째 콜백으로는 Early Stopping 콜백입니다.
ModelCheckpoint 콜백을 통해 가장 낮은 검증 점수의 모델을 자동저장하긴 했지만, 여전히 20번 epoch까지 수행합니다.
이 때 훈련을 중지하여 컴퓨터의 시간과 자원을 절약 가능한 방법이 Early Stopping 입니다.
파라미터로는 patience로, 검증 점수가 향상되지 않더라도 좀 더 참고 수행할 에포크 횟수를 의미합니다.
또, restore_best_weights로, True로 지정 시 가장 낮은 검증 손실을 낸 파라미터로 되돌립니다.
model = model_fn(keras.layers.Dropout(0.3))
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

checkpoint_cb = keras.callbacks.ModelCheckpoint(
  './data/best-model.keras', save_best_only=True
)

early_stopping_cb = keras.callbacks.EarlyStopping(patience=2, restore_best_weights=True)

history = model.fit(
  train_scaled, train_target, epochs=20, validation_data=(val_scaled, val_target),
  callbacks=[checkpoint_cb, early_stopping_cb]
)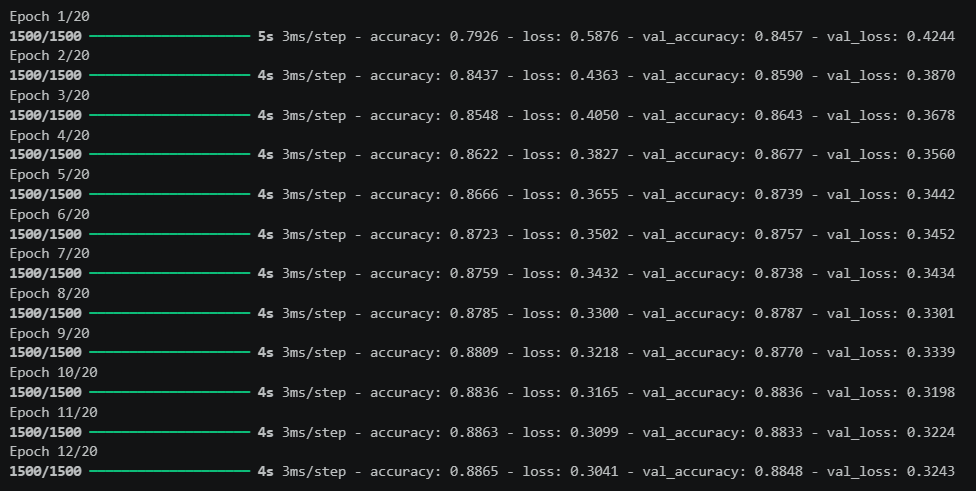
12번에서 중지되었습니다. 최상의 모델은 따라서 10번째 epoch에서 학습한 W 값입니다.