합성곱
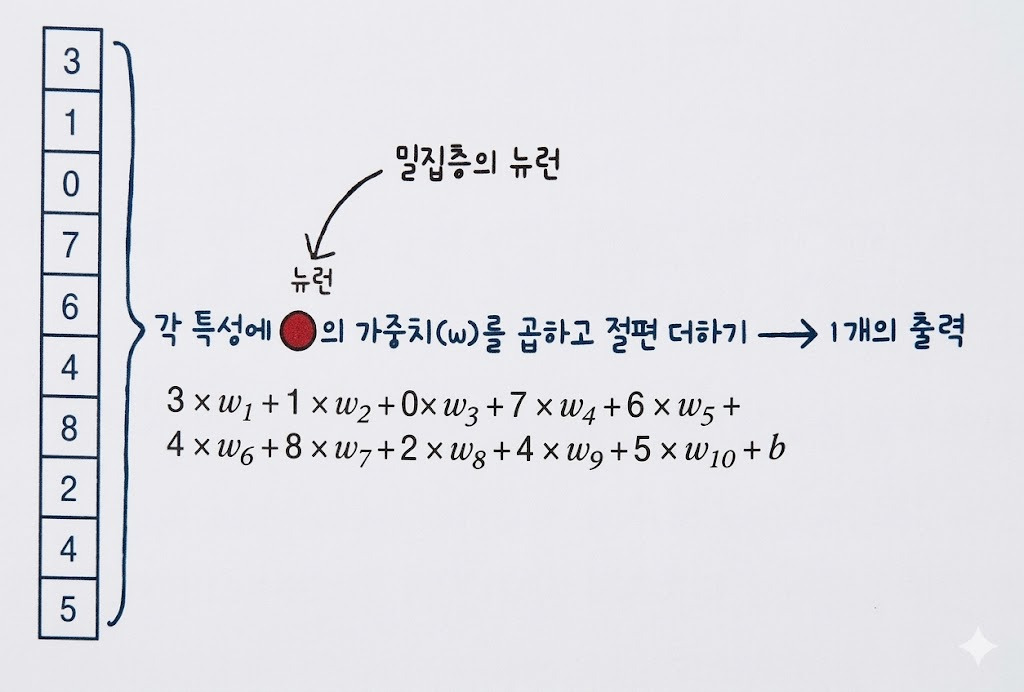
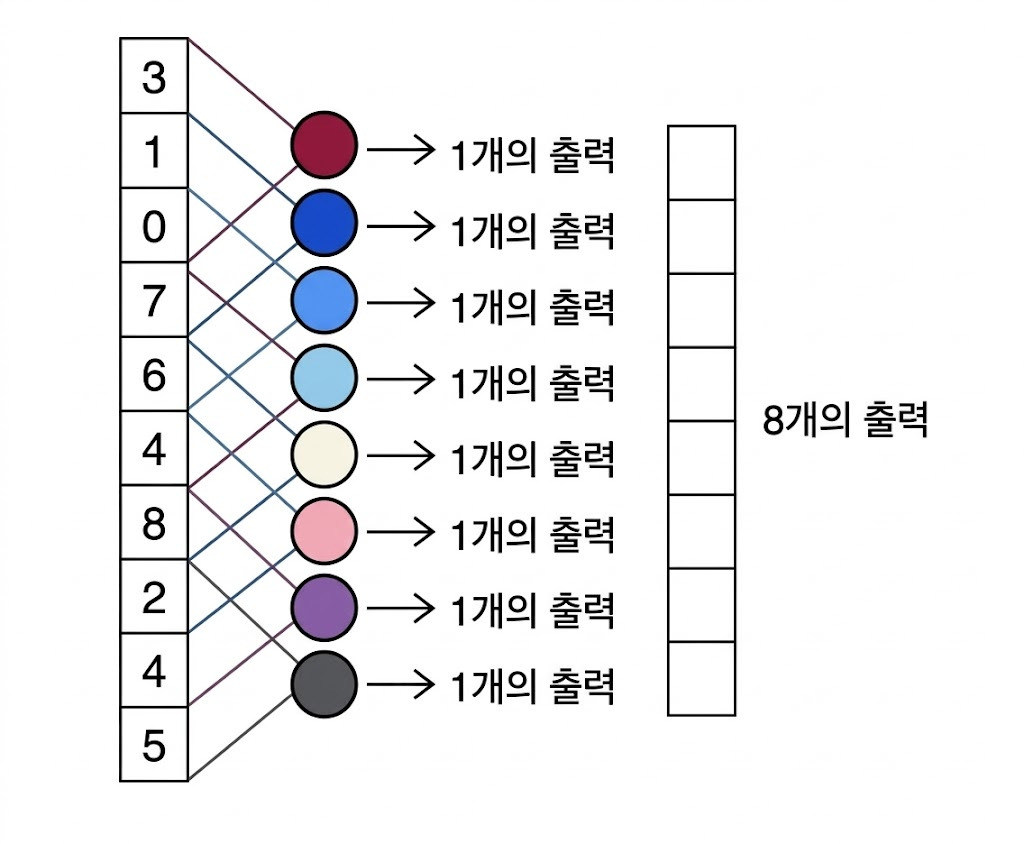
기존 Dense Layer에서는 Hidden Layer의 뉴런의 개수를 100개로 설정했을 때
앞에서 전달된 모든 값이 각각의 뉴런으로 다 전달됩니다. 이것을 Fully Connected Layer(완전 연결층) 이라고도 했습니다.
그래서 완전 연결층에서는 모든 입력에 가중치를 곱해서 받습니다.
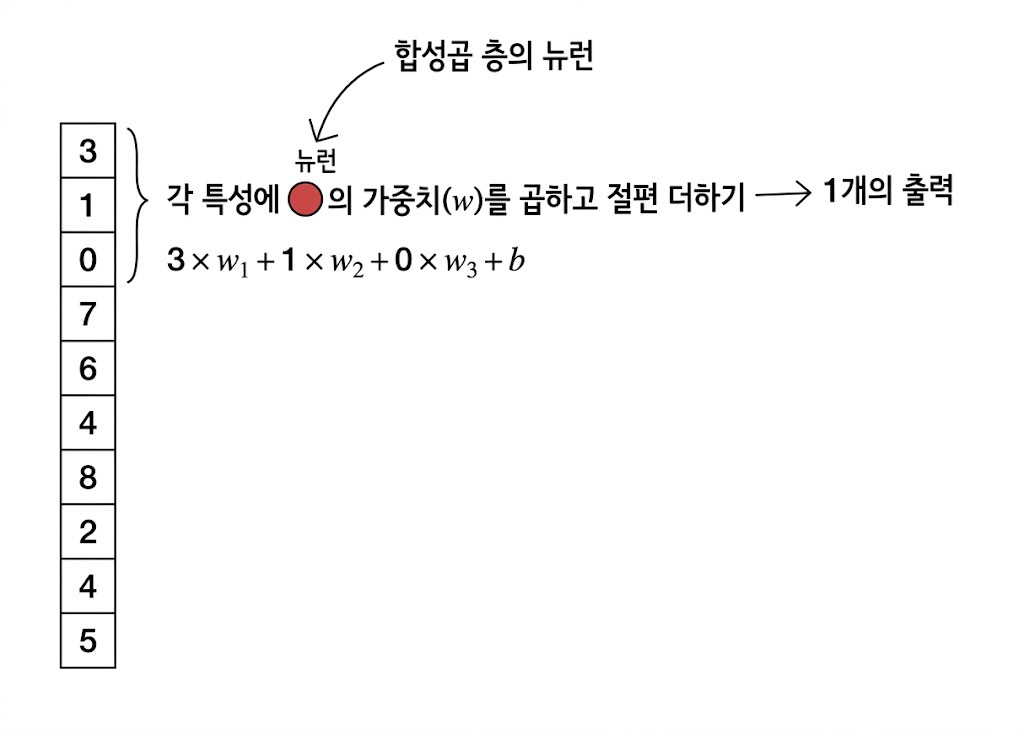
반면에 합성곱은 입력 데이터 전체에 가중치를 적용하는 것이 아니라 일부에 가중치를 적용하는 것입니다.
이 W값은 하이퍼 파라미터로 정해줄 수 있습니다.
그리고 한칸을 이동한 후 적용한 뒤 또 새로운 출력을 만듭니다.
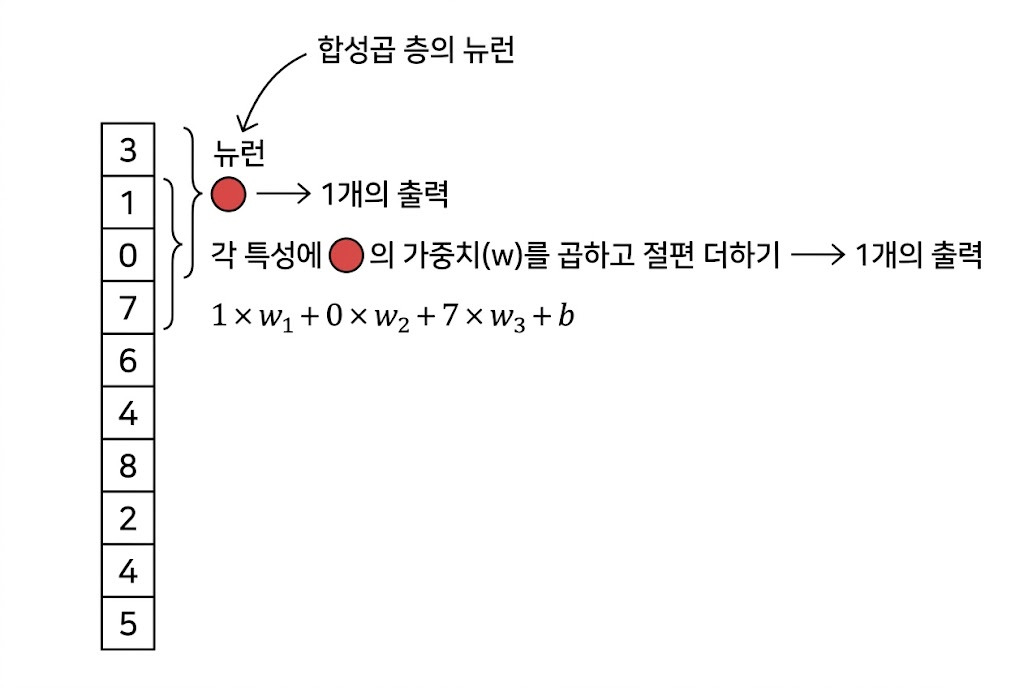
이 여러 출력을 통해 최종 결과를 만듭니다. 이를 합성곱이라고 합니다.
합성곱을 수행하는 CNN(Convolution Neural Network)에서 설정해야 할 것이 필터 혹은 커널이 있습니다.
여기서 필터는 뉴런 개수를 이야기할 때 쓰고, 커널은 가중치를 의미할 때 쓰입니다.
2차원 데이터에 대한 합성곱을 수행할 때, 왼쪽 위부터 시작하여 필터값을 적용하여 합성곱을 수행합니다.
필터의 각 값은 가중치를 의미하여, 각각 Input 데이터와 가중치(W)를 곱한 후 서로 합합니다. 그것이 Output이 됩니다.
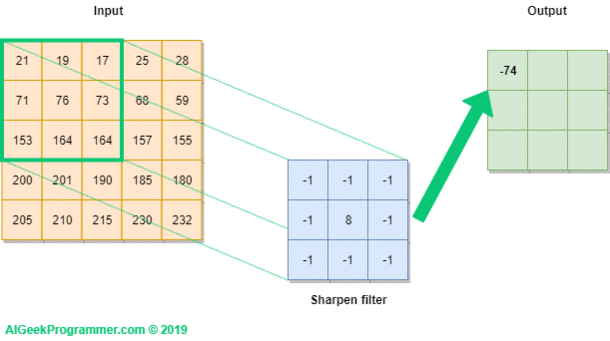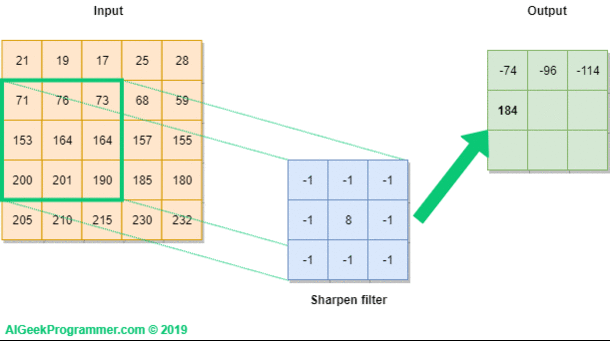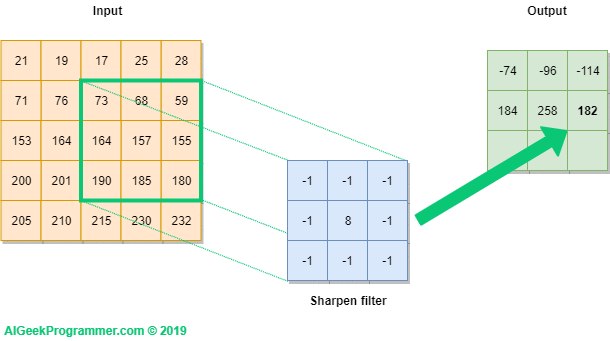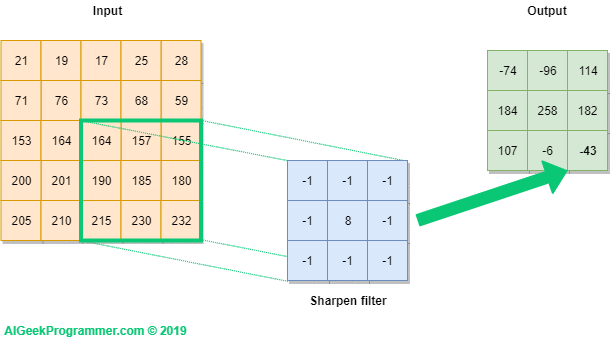
신경망 학습에서는 필터(커널)에 있는 W값을 찾아내는 것입니다. 입력이 2차원이라면, 필터(커널)도 2차원입니다.
이 때 입력의 shape와 필터(커널)의 shape를 알 때 출력의 shape가 계산이 되어야 합니다.
예를 들어 입력이 (4, 4)이고, 커널이 (3, 3)이라면 출력이 (2, 2)가 나옵니다.
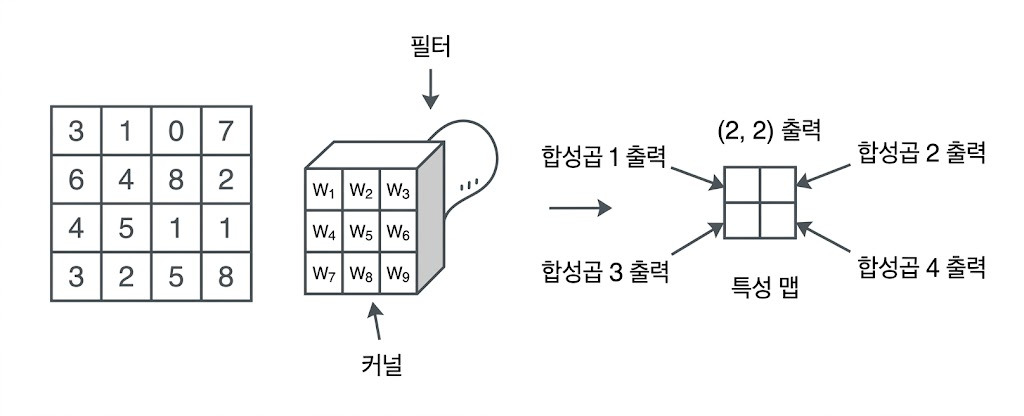
이 때, 출력이 압축된 효과를 얻어 이를 특성 맵(Feature Map)이라고 합니다.
그리고, 합성곱에서도 여러 개의 필터를 사용할 수 있습니다.
여러 개의 필터를 사용하면, 만들어진 특성 맵은 순서대로 차곡차곡 쌓이는데
가령 (2, 2) 크기의 특성 맵이 3개의 필터로 쌓이면 (2, 2, 3) 크기의 3차원 배열이 되는 것입니다.
그리고, 이미지 같은 2차원 데이터가 여러 Color Channel 값으로 나뉜 경우 3차원 형태로 표현되며,
필터 개개인도 Color Channel 개수 만큼 나뉘어져 shape를 형성합니다.
최종적으로 Feature Map에는 필터 개수만큼 3차원 데이터가 형성됩니다.
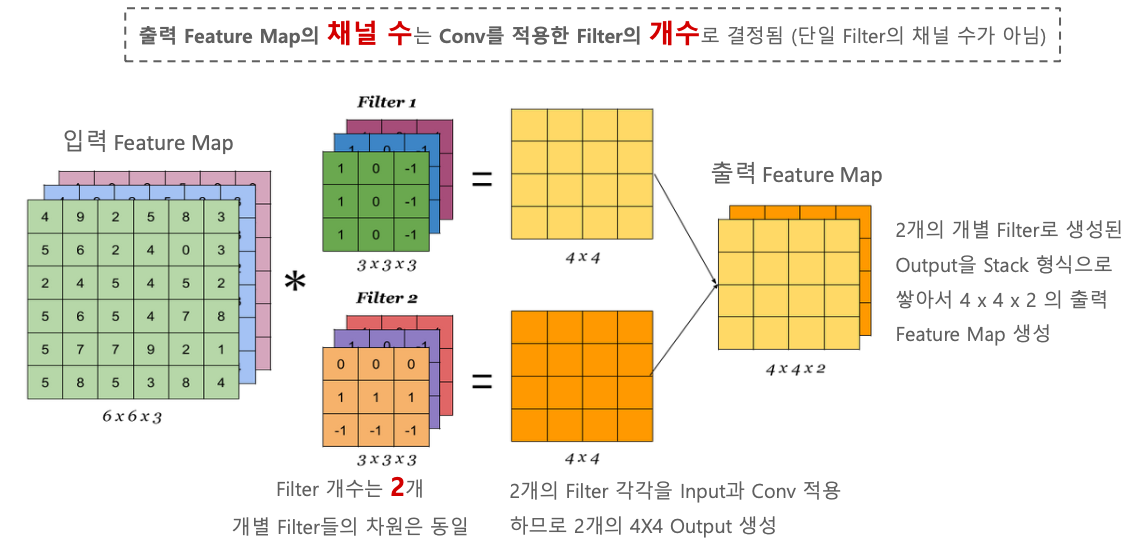
결론적으로 합성곱을 수행할수록 이미지크기는 줄어들지만, 정보의 깊이가 깊어져 많은 정보들을 담습니다.
그러면 2D 데이터에 대해 합성곱 층을 만들어보겠습니다.
Keras에서는 Conv2D 클래스를 제공하는데, 첫번째 매개변수로 filters를 통해 필터의 개수를 설정합니다.
두번째 매개변수는 kernel_size로 필터에 사용할 커널의 크기를 설정합니다.
세번째 매개변수는 strides로 가로, 세로 이동하는 필터 이동의 크기를 설정합니다.
keras.layers.Conv2D(filters=10, kernel_size=(3, 3), activation='relu')추가 매개변수는 padding 옵션이 있습니다.
일반적으로 합성곱은 결과로 가로, 세로 크기가 압축이 되는데
결과로 가로, 세로 크기가 똑같이 나오려면 어떻게 해야할까요?
예를 들어, 5 x 5 입력 크기에 3 x 3 필터를 적용하려면, 원본 입력 크기에 거리가 1인 패딩을 줍니다.
패딩은 숫자 0으로 채워진 값입니다. 따라서 합성곱을 할 때 계산에 영향을 주지 않습니다.
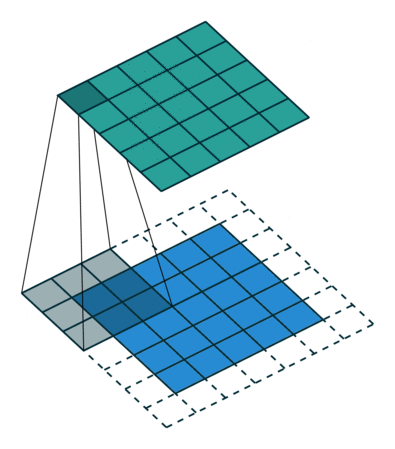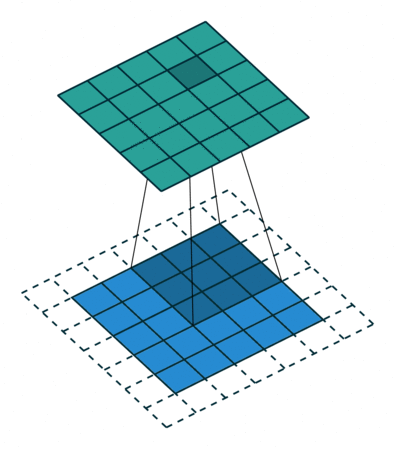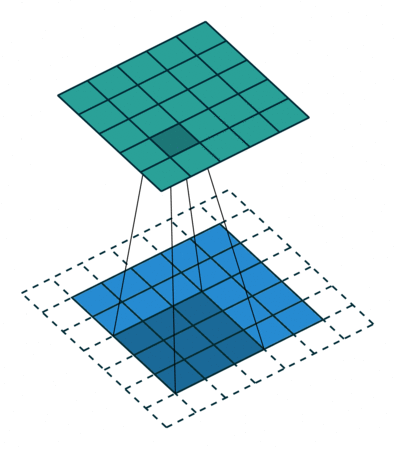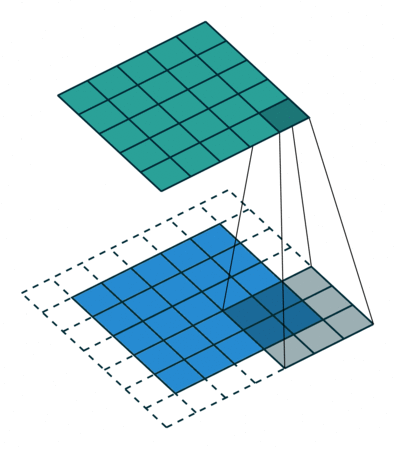
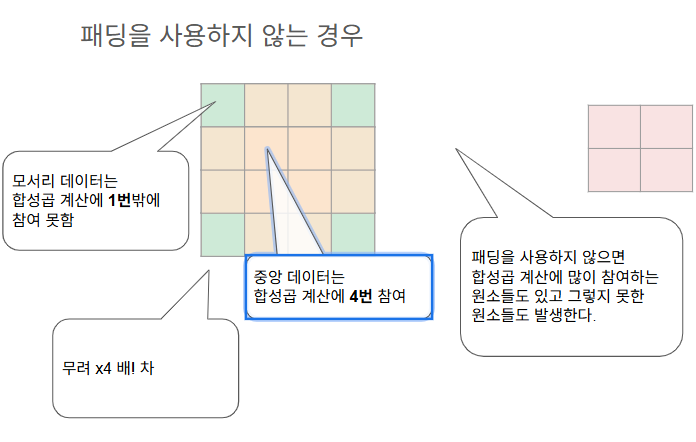
패딩을 사용하는 진정한 이유를 설명하기 위해 4 x 4 짜리 입력 데이터가 있다고 해보겠습니다.
3 x 3 필터를 적용할 때 좌상단에 있는 데이터는 합성곱에 한번 밖에 참여하지 못합니다.
하지만, 3 x 3 필터를 적용할 때 가운데에 있는 데이터는 합성곱에 4번 참여합니다.
즉, 패딩을 사용하지 않으면 합성곱 계산에 많이 참여하는 원소와 못한 원소의 격차가 큽니다.
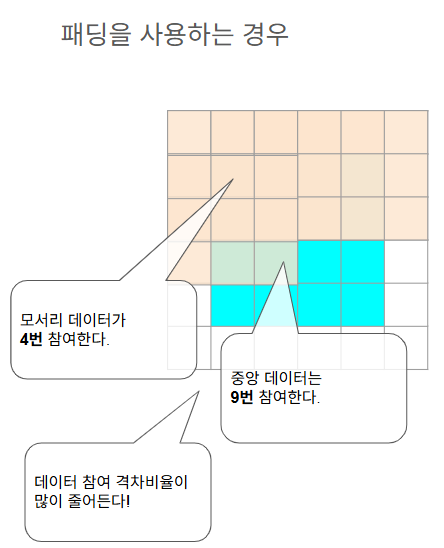
하지만, 패딩을 사용하면, 모서리 데이터는 4번 참여하고, 중앙 데이터는 9번 참여함으로
어느 정도 데이터 참여의 격차 비율이 줄어드는 모습입니다.
일반적인 합성곱 신경망에서는 Same Padding이 많이 사용됩니다.
keras.layers.Conv2D(filters=10, kernel_size=(3, 3), activation='relu', padding='same')추가로, strides 옵션을 적용하여 이동의 크기를 제어합니다. 대부분은 기본값인 1을 씁니다.
keras.layers.Conv2D(
  filters=10, kernel_size=(3, 3), activation='relu', padding='same', strides=(1, 1)
)
풀링(Pooling)
합성곱을 통해 나온 결과를 특성 맵(Feature Map)이라고 불렀습니다. 그런데, 이것을 또 다시 압축하는 과정입니다.
특성 맵의 가로, 세로를 줄이는 역할인데, 입력된 특성 맵에서 중요한 것만 추출합니다.
하지만 특성 맵의 개수는 그대로입니다.
예를 들어, (2, 2, 3)의 특성 맵이 왔다면 (2, 2)의 풀링을 통해 (1, 1, 3)의 출력으로 압축합니다.
풀링은 커널의 사이즈만큼 이동하며, MaxPooling은 원소 중 가장 센 값을 추출합니다.
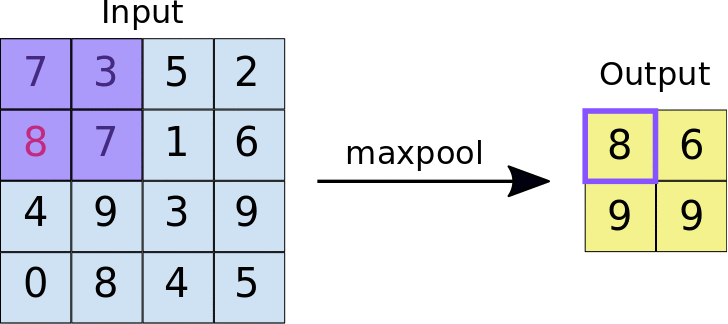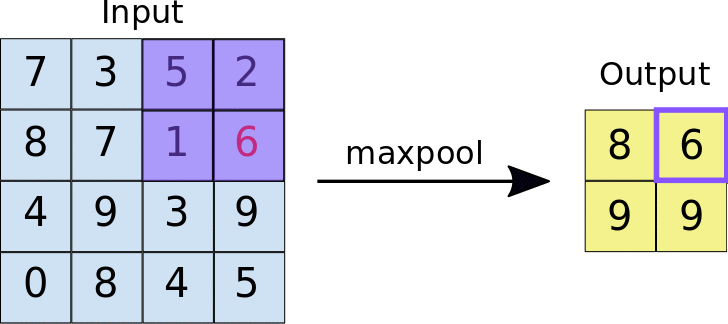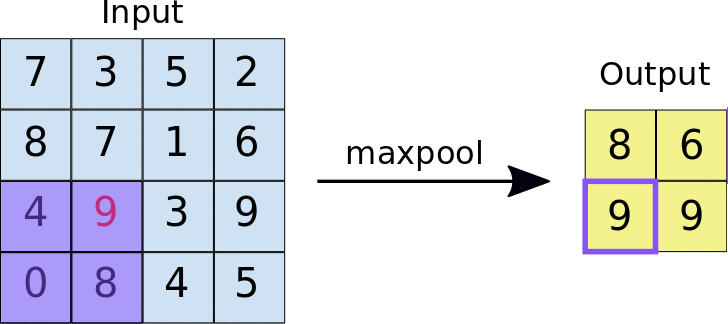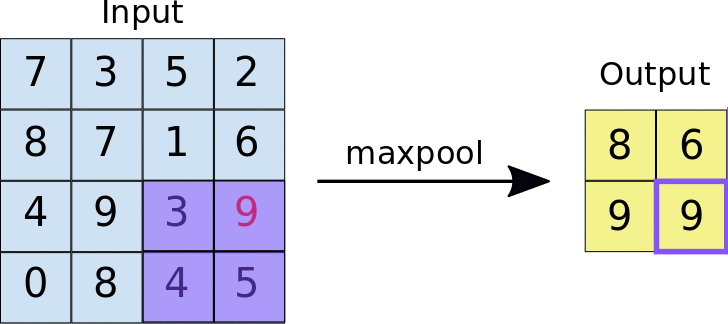
Keras에서는 MaxPooling2D 클래스를 제공합니다. 2차원 데이터에 대해 풀링 작업을 합니다.
keras.layers.MaxPooling2D(pool_size=2)Keras에서는 AveragePooling2D 클래스도 제공합니다. 이것은 Pool_Size 안의 원소의 평균값을 냅니다.
하지만 평균 풀링은 특성 맵에 있는 중요 정보를 희석시킬 수 있어 잘 쓰지 않습니다.
합성곱 신경망
위 내용을 바탕으로 합성곱 신경망을 만들 수 있습니다. 특히 이미지 분야에서 탁월한 성능을 나타냅니다.
예를 들어 (4, 4)의 입력에 (1, 1) 패딩을 적용하여, (3, 3) 필터 3개를 적용해 (4, 4) 특성 맵 3개를 만듭니다.
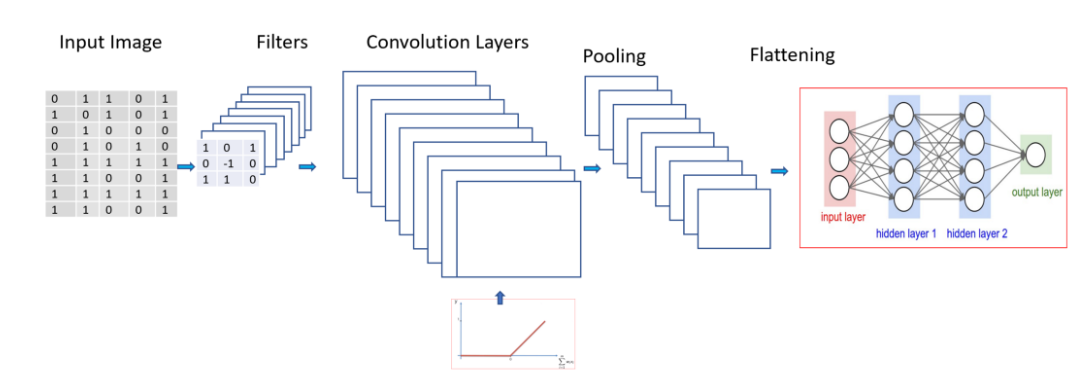
이를 활성화 함수 적용해 (4, 4, 3) 특성 맵을 만듭니다. 이 때까지가 합성곱 층(Convolution Layer)입니다.
합성곱 층에서는 (height, width, channel) 형태의 3차원 데이터를 기대합니다.
그리고, (2, 2) 최대 풀링을 통해 (2, 2, 3) 특성 맵으로 압축합니다. 이 때가 풀링 층(Polling Layer)입니다.
여기서 합성곱과 풀링은 K번 반복할 수도 있습니다. 이 과정은 Feature Extraction(특징 추출)입니다.
최종적으로 이것을 1차원으로 펼쳐서 밀집 층(Dense Layer) 통해 최종 출력 층까지 보냅니다.
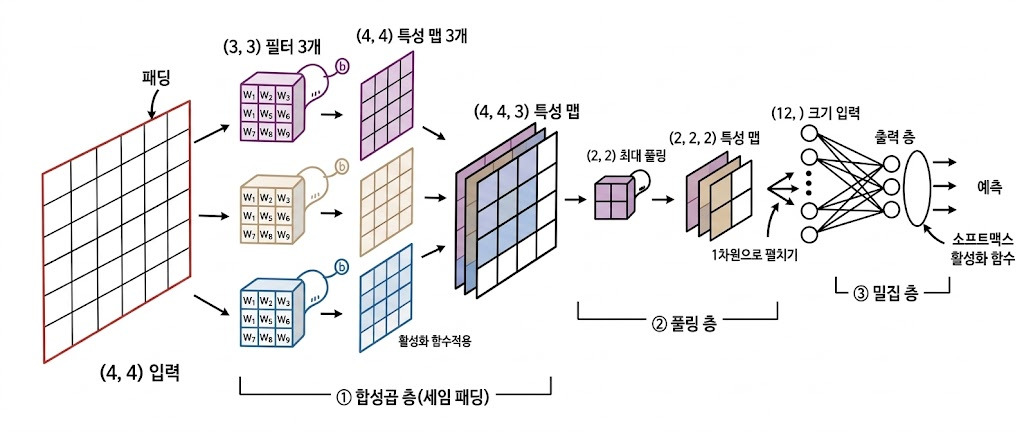
위 내용을 통해 데이터를 불러올 때 입력이 (batch, height, width, channel) 형태여야 함을 알 수 있습니다.
그래서 마지막에 채널 차원을 추가하도록 하겠습니다.
(train_input, train_target), (test_input, test_target) =\
keras.datasets.fashion_mnist.load_data()

train_scaled = train_input.reshape(-1, 28, 28, 1) / 255.0
test_scaled = test_input.reshape(-1, 28, 28, 1) / 255.0
그리고 다시 훈련 데이터와 검증 데이터를 8:2로 쪼갭니다.
from sklearn.model_selection import train_test_split

train_scaled, val_scaled, train_target, val_target =\
train_test_split(train_scaled, train_target, test_size=0.2, random_state=42)
합성곱 신경망을 만드는데, 전체적으로 Sequential 모델로 만듭니다.
model = keras.Sequential()처음에 Feature Learning (특성 학습)을 위해 입력 차원을 지정합니다.
model.add(keras.layers.Input(shape=(28, 28, 1)))그리고 첫번째 합성곱을 통과시킵니다.
이 때 출력의 shape는 (28, 28, 32)가 되고 모델 파라미터는 (3 x 3 x 1 + 1(bias)) x 32 = 320개 입니다.
model.add(keras.layers.Conv2D(filters=32, kernel_size=3, activation='relu', padding='same'))합성곱의 출력을 받으면 MaxPooling 통해 압축합니다. 풀링 크기는 (2, 2) 입니다.
이 때 출력 shape는 (14, 14, 32)가 될 것입니다.
model.add(keras.layers.MaxPooling2D(pool_size=2))다시 합성곱에 들어가 통과시킵니다. 64개의 필터의 개수만 변경합니다.
출력 shape는 (14, 14, 64)가 되며, 모델 파라미터 개수는 (3 x 3 x 32 + 1(bias)) x 64 = 18,496 개입니다.
model.add(keras.layers.Conv2D(filters=64, kernel_size=3, activation='relu', padding='same'))그리고 MaxPooling 통해 압축합니다. 이 때 출력 shape는 (7, 7, 64)가 될 것입니다.
model.add(keras.layers.MaxPooling2D(pool_size=2))두번째 분류(Classification)을 위해 학습된 것을 1차원으로 펼칩니다. shape는 (7 * 7 * 64 = 3136, )로 나옵니다.
model.add(keras.layers.Flatten())중간에 Hidden Dense Layer를 통과시킵니다.
출력 shape는 (100, )이 됩니다. 모델 파라미터는 (3136 + 1(bias)) * 100 개입니다.
model.add(keras.layers.Dense(100, activation='relu'))Hidden Layer에 과대 적합을 억제합니다.
model.add(keras.layers.Dropout(0.4))마지막에 10개의 뉴런에서 확률 계산하여 출력합니다.
출력 shape는 (10, )이 됩니다. 모델 파라미터 개수는 (100 + 1(bias) * 10개 입니다.
model.add(keras.layers.Dense(10, activation='softmax'))summary()를 통해 Layer의 구조를 살펴봅시다.
model.summary()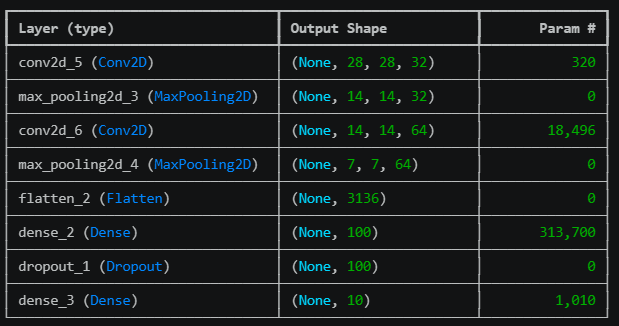
이제 모델 컴파일을 합니다.
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])2가지 콜백을 준비합니다.
checkpoint_cb =\
keras.callbacks.ModelCheckpoint('./data/best-cnn-model.keras', save_best_only=True)

early_stopping_cb =\
keras.callbacks.EarlyStopping(patience=2, restore_best_weights=True)
훈련합니다.
history = model.fit(
  train_scaled,
  train_target,
  epochs=20,
  validation_data=(val_scaled, val_target),
  callbacks=[checkpoint_cb, early_stopping_cb]
)
Loss Curve를 그려서 조기 종료가 잘 이루어지는지 확인합니다.
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.xlabel('epoch')
plt.ylabel('loss')
plt.legend(['train', 'val'])
plt.show()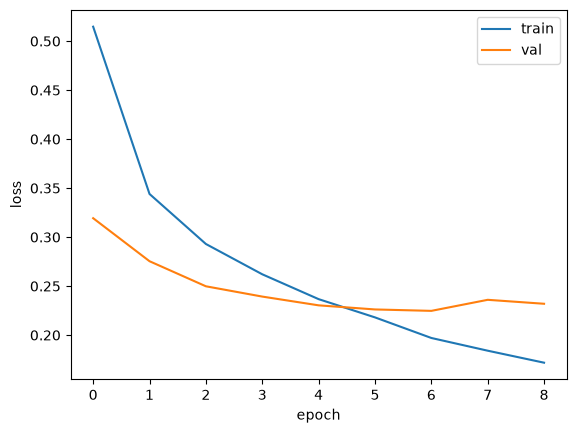
8번에서 종료되었고, 최적화된 epoch의 횟수는 6회 부근입니다.
예측하기
검증 세트의 첫번째 샘플을 처음 본 이미지라고 가정하고, predict()로 예측을 뽑아봅니다.
먼저 첫번째 샘플 이미지부터 확인하겠습니다.
plt.imshow(val_scaled[0].reshape(28, 28), cmap='gray_r')
plt.show()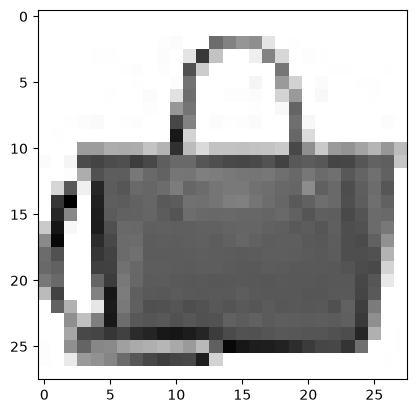
예측할 때 predict() 메소드는 첫번째 차원이 batch 차원이 있는 2차원 데이터이어야 합니다.
preds = model.predict(val_scaled[0:1])
print(preds)

'''
[[1.5422667e-17 1.2117280e-22 4.3569015e-20 3.6197230e-20 5.5778185e-19
  1.7370304e-16 1.5259329e-18 4.5830102e-19 1.0000000e+00 1.1050249e-17]]
'''
9번째 클래스가 1에 가까워 9번째 레이블값으로 예측했다는 뜻입니다.
모델 저장
이 모델을 keras 파일로 저장합니다.
model.save('./data/best-cnn-model.keras')